


Python递归函数详解:条件、实现与文件遍历应用

发布时间:2026-10-14 |
4人浏览过
本文深入解析Python递归函数的核心条件与实现逻辑,通过对比循环与递归方式计算阶乘,展示代码差异。同时结合os模块演示如何利用递归遍历树形文件结构,并重点提醒递归调用中潜在的栈溢出风险及内存消耗问题,帮助开发者掌握递归技巧并规避常见陷阱。
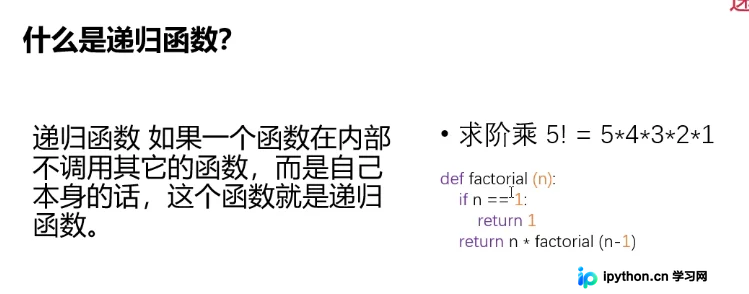
# 递归满足的条件
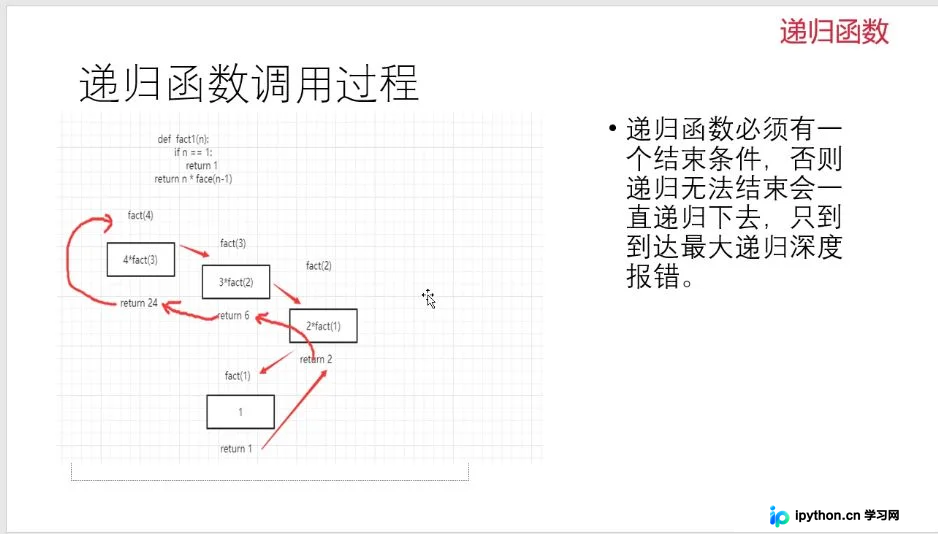
# 1.自己调用自己
# 2.必须有一个明确的结束条件
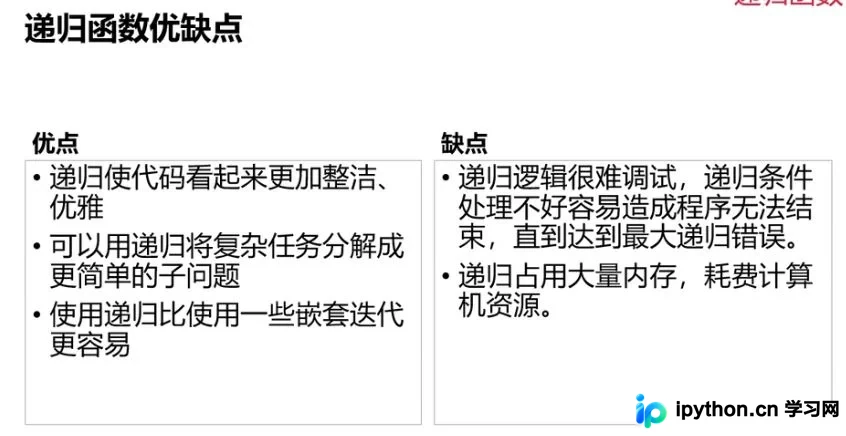
# 优点:逻辑简单\定义简单
# 缺点:防止内存消耗过多,容易导致栈溢出,内存资源紧张,甚至内存泄漏事件发生
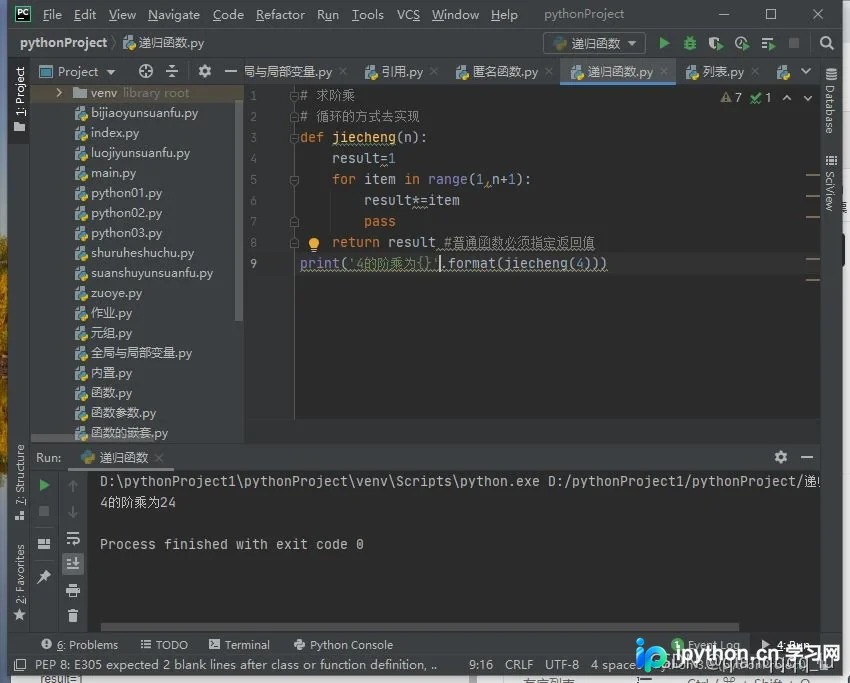
# 求阶乘
# 循环的方式去实现
def jiecheng(n):
    result=1
    for item in range(1,n+1):
        result*=item
        pass
    return result #普通函数必须指定返回值
print('4的阶乘为{}'.format(jiecheng(4)))
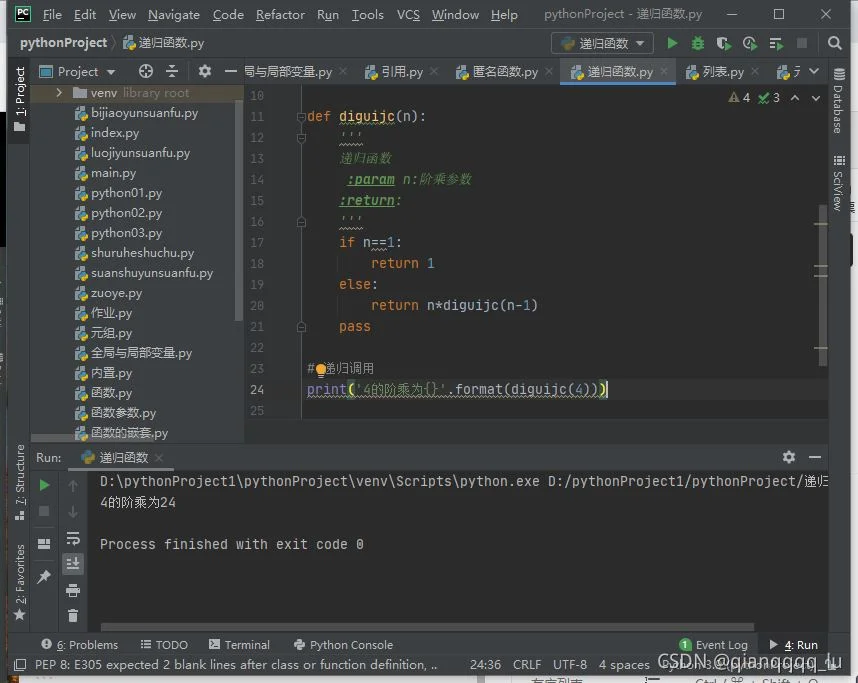
def diguijc(n):
    '''
    递归函数
     :param n:阶乘参数
    :return:
    '''
    if n==1:
        return 1
    else:
        return n*diguijc(n-1)
    pass
 # 递归调用
print('4的阶乘为{}'.format(diguijc(4)))
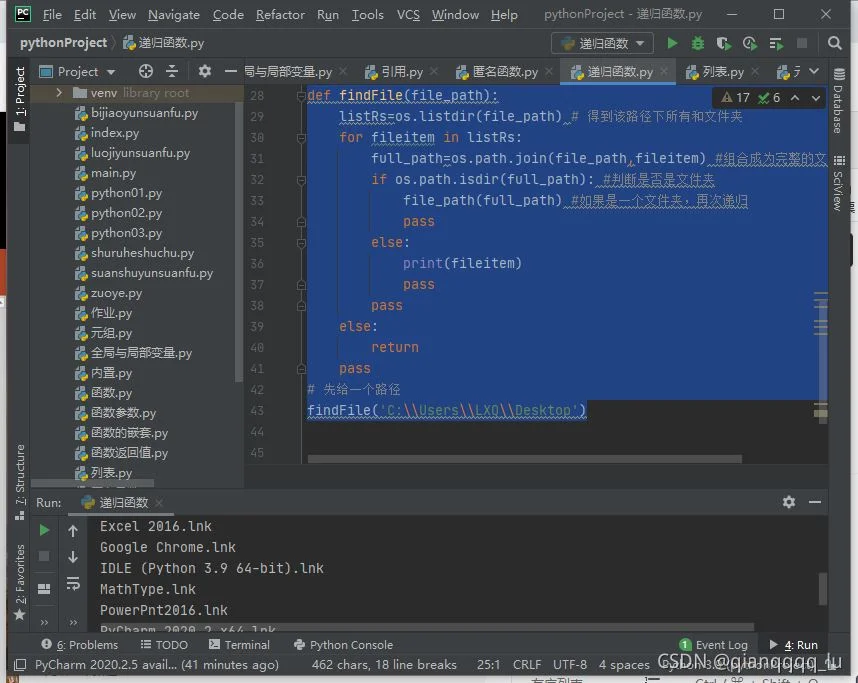
# 模拟实现树形结构的遍历
import os #引入文件操作模块
def findFile(file_path):
    listRs=os.listdir(file_path) # 得到该路径下所有和文件夹
    for fileitem in listRs:
        full_path=os.path.join(file_path,fileitem) #组合成为完整的文件路径
        if os.path.isdir(full_path): #判断是否是文件夹
            file_path(full_path) #如果是一个文件夹,再次递归
            pass
        else:
            print(fileitem)
            pass
        pass
    else:
        return
    pass
# 先给一个路径
findFile('C:\\Users\\LXQ\\Desktop')
总结 递归函数的应用需要严格遵循两个核心条件:首先,函数必须在内部调用自身;其次,必须设定明确的终止条件以防止无限循环。递归的优势在于逻辑清晰、定义简洁,但缺点同样显著:过度递归可能导致内存消耗过大,进而引发栈溢出、内存资源紧张甚至内存泄漏。为了直观理解,我们先看阶乘的两种实现方式。普通循环实现如下: def jiecheng(n): result=1 for item in range(1,n+1): result*=item pass return result #普通函数必须指定返回值 print('4的阶乘为{}'.format(jiecheng(4))) 对应的递归实现则更为简洁: def diguijc(n): ''' 递归函数 :param n:阶乘参数 :return: ''' if n==1: return 1 else: return n*diguijc(n-1) pass # 递归调用 print('4的阶乘为{}'.format(diguijc(4))) 此外,递归在处理树形结构时尤为有效。例如利用os模块遍历指定路径下的所有文件和文件夹: # 模拟实现树形结构的遍历 import os #引入文件操作模块 def findFile(file_path): listRs=os.listdir(file_path) # 得到该路径下所有和文件夹 for fileitem in listRs: full_path=os.path.join(file_path,fileitem) #组合成为完整的文件路径 if os.path.isdir(full_path): #判断是否是文件夹 file_path(full_path) #如果是一个文件夹,再次递归 pass else: print(fileitem) pass pass else: return pass # 先给一个路径 findFile('C:\\Users\\LXQ\\Desktop')
本篇文章就到这里了,希望能够给你带来帮助,也希望您能够多多关注本站的更多内容!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















