


Python去除PDF水印的实现示例

本文介绍使用Python去除PDF及图片中浅色水印的方法。核心思路是通过PIL库读取图片RGB值,识别并修改接近白色的浅颜色像素为纯白。对于PDF,利用pymupdf将页面转为图片后处理RGB值,再保存为图片。该方法简单但输出非PDF格式且可能模糊,适合特定场景。
Python去除PDF水印概述
本文介绍如何利用Python去除PDF文档或图片中的水印,整体思路清晰且代码简洁。
首先探讨如何在Python中去除图片水印,随后将相同思路应用于PDF文件处理。
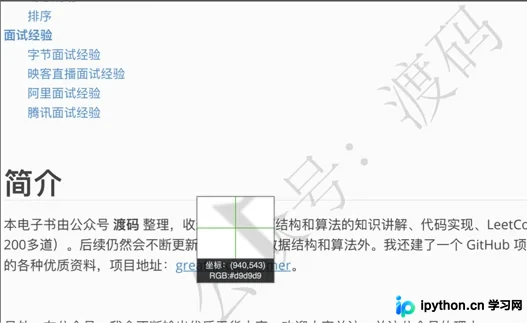
示例图片截取自《数据结构和算法》PDF文档,包含公众号水印。
图片水印去除原理
观察图片可知,为保证正文可读性,水印颜色通常较浅。利用这一颜色差异特征,可通过Python读取图片颜色,并将浅色区域处理为白色,从而去除水印。
Python标准库PIL可用于获取图片颜色信息。在Python2中该库已内置,而Python3需手动安装。本文使用Python 3.8版本,需执行以下
命令进行安装。
pip install pillow
安装完成后,读取图片并获取其尺寸(宽度和高度)。
from PIL import Image

img = Image.open('watermark_pic.png')
width, height = img.size
在继续操作前,简要介绍计算机颜色原理。光学三原色为红、绿、蓝(RGB),它们是不可分解的基本颜色,其他颜色由这三种混合而成。等比例混合三种颜色得到白色,无光时为黑色。
在计算机中,RGB颜色由三个字节表示,每个字节最大数值为 1。因此,(255, 0, 0)代表红色,(0, 255, 0)代表绿色,(0, 0, 255)代表蓝色。同理,(255, 255, 255)代表白色,(0, 0, 0)代表黑色。从(0, 0, 0)到(255, 255, 255)之间的任意组合均可表示不同颜色。
接下来通过代码读取图片的RGB值。
for i in range(width):
    for j in range(height):
        pos = (i, j)
        print(img.getpixel(pos)[:3])
图片每个位置的颜色由四元组表示,前三位对应RGB,第四位为Alpha通道,此处无需关注。
获取RGB值后,即可对其进行修改。
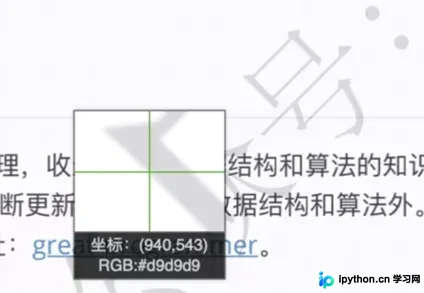
从图中可见,水印的RGB值为 #d9d9d9,即十六进制表示,对应十进制为(217, 217, 217)。
这三个颜色值越接近 255,颜色越淡。当三者均变为 255时即为白色。因此,只要RGB值均大于 217的位置,即可填充为白色,即RGB三位数之和大于等于 651。
if sum(img.getpixel(pos)[:3]) >= 651:
    img.putpixel(pos, (255, 255, 255))
完整代码如下:
from PIL import Image

img = Image.open('watermark_pic.png')
width, height = img.size

for i in range(width):
    for j in range(height):
        pos = (i, j)
        if sum(img.getpixel(pos)[:3]) >= 651:
            img.putpixel(pos, (255, 255, 255))

img.save('watermark_removed_pic.png')
PDF水印去除实现
基于上述基础,去除PDF水印变得简单:将每页PDF转换为图片,修改水印的RGB值,最后输出处理后的图片。
安装pymupdf库,用于操作PDF文件。
pip install pymupdf
读取PDF文件,并将其转换为图片。
import fitz

doc = fitz.open("数据结构和算法手册@公众号渡码.pdf")
for page in doc:
    pix = page.get_pixmap()
该PDF共 480 页,需遍历每一页并获取对应的图片对象pix。pix对象类似于前述img对象,可读取和修改其RGB值。
page.get_pixmap()操作不可逆,即只能实现从PDF到图片的转换,修改图片RGB后无法直接应用回PDF,只能输出为图片格式。
修改水印RGB与前述方法一致,区别在于此处RGB为三元组,不含Alpha通道,代码如下:
from itertools import product

for pos in product(range(pix.width), range(pix.height)):
    if sum(pix.pixel(pos[0], pos[1])) >= 651:
        pix.set_pixel(pos[0], pos[1], (255, 255, 255))
完整代码如下:
from itertools import product
import fitz


doc = fitz.open("数据结构和算法手册@公众号渡码.pdf")

page_no = 0
for page in doc:
    pix = page.get_pixmap()

    for pos in product(range(pix.width), range(pix.height)):
        if sum(pix.pixel(pos[0], pos[1])) >= 651:
            pix.set_pixel(pos[0], pos[1], (255, 255, 255))

    pix.pil_save(f"pdf_pics/page_{page_no}.png", dpi=(30000, 30000))

    print(f'第 {page_no} 页去除完成')
    page_no += 1
此方案存在缺点:首先,输出结果并非PDF格式;其次,输出图片可能较为模糊,后续需进一步优化,理想情况是直接修改PDF文件。
至此,关于Python去除PDF水印的实现示例介绍完毕,更多相关内容请搜索本站历史文章或继续浏览相关文章,感谢支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















