


Python实现微博移动端关键词数据抓取教程

本文详解如何利用Python抓取微博移动端指定关键词的搜索结果。通过获取Cookie并分析XHR接口,构造请求参数获取数据。重点讲解使用正则表达式提取标题、评论及点赞数,并解决Unicode编码转换问题,提供完整代码示例供学习参考。
近期,有高校教师委托进行微博舆情分析,需要抓取特定关键词的微博数据。同时,鉴于许多读者咨询微博爬虫的相关问题,本文将详细介绍如何使用Python实现这一功能。
一、页面结构分析
本次抓取目标为微博移动端。移动端通常采用基于cookie的信息校验机制进行反爬,因此第一步需登录以获取有效的cookie。
成功登录后,即可获取自身的cookie。接下来,我们需要分析用户在微博中搜索内容的具体交互流程。
通常,用户在此处输入关键词以触发微博搜索功能。
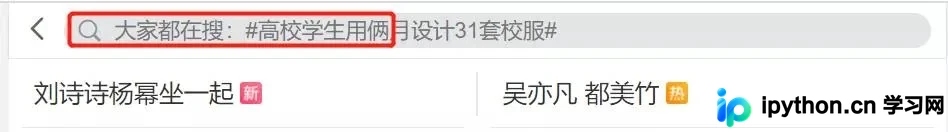
通过浏览器开发者工具观察页面行为,发现每次发起关键词请求后,系统会返回一个XHR响应,其中包含所需数据。
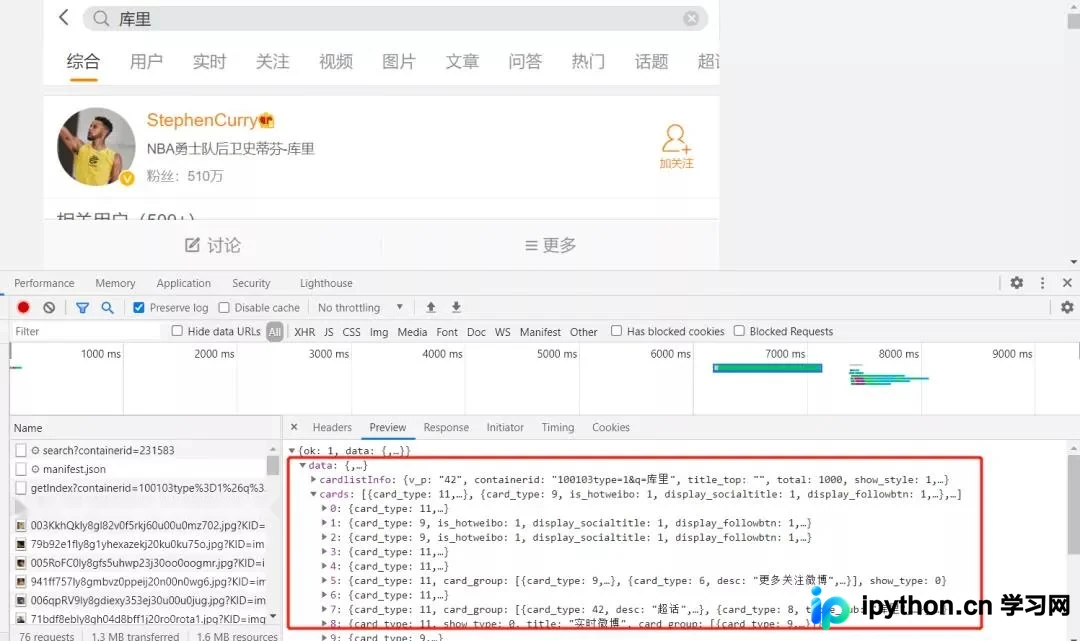
既然已定位到数据存在的真实页面,即可按照常规爬虫流程进行数据采集。
二、数据采集实施
基于前文确定的数据存储页面,我们只需对该页面发起HTTP请求,并从中提取关键信息。
1、构造请求
通过分析请求头信息,我们可以轻松构建出对应的请求代码。
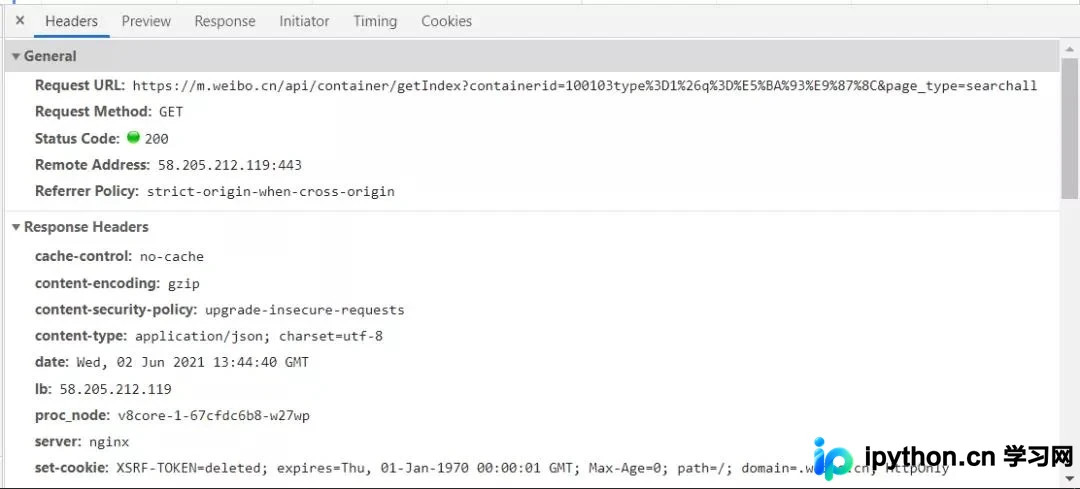
具体代码如下:
key = input("请输入爬取关键字:")
for page in range(1,10):
   params = (
       ('containerid', f'100103type=1&q={key}'),
       ('page_type', 'searchall'),
       ('page', str(page)),
   )

   response = requests.get('https://m.weibo.cn/api/container/getIndex', headers=headers, params=params)
2、数据提取
观察数据结构可知,数据可转换为字典格式进行爬取。但经实际测试,使用正则表达式提取更为简便高效。因此,本文展示正则提取方案,读者也可尝试字典解析方式。
具体代码如下:
r = response.text
title = re.findall('"page_title":"(.*?)"',r)
comments_count = re.findall('"comments_count":(.*?),',r)
attitudes_count = re.findall('"attitudes_count":(.*?),',r)
for i in range(len(title)):
   print(eval(f"'{title[i]}'"),comments_count[i],attitudes_count[i])
此处需注意一个细节:微博标题采用Unicode编码格式。若直接爬取存储,保存的将是Unicode编码字符串。感谢开发者小明提供的帮助,此前网上多种解决方案均未成功,最终通过一个简单函数解决了该问题。
解决方法:使用eval()函数处理标题输出,即可将Unicode编码正确转换为汉字。
三、总结
1. 本文详细讲解了如何使用Python针对指定关键字爬取微博数据,建议读者动手实践以加深理解。
2. 本文内容仅供技术学习交流,严禁用于非法用途。
关于使用Python爬取微博指定关键词的教程至此结束。如需了解更多相关内容,请查阅本站过往文章或继续关注后续更新,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















