


Python使用dabl几行代码实现数据处理分析及ML自动化

dabl是Python开源数据分析基线库,通过几行代码自动完成数据预处理、特征可视化及基线模型训练。本文介绍其核心功能,包括自动识别数据类型、执行探索性数据分析(EDA)及返回最佳预测模型,旨在简化机器学习开发流程。
数据科学模型的开发流程涵盖多个关键环节,包括数据收集、清洗、探索性数据分析(EDA)、模型构建以及最终部署。在正式训练机器学习或深度学习模型之前,必须对数据集进行清洗并确保其符合训练要求。通常情况下,这些前期处理步骤繁琐且重复,占据了开发者大量的时间精力。
为解决上述效率问题,本文介绍一个名为 dabl 的开源 Python 工具包。该工具旨在自动化机器学习模型的开发过程,涵盖数据预处理、特征可视化与分析以及模型训练等环节。建议读者收藏以便后续学习,若觉得有用请点赞支持。
dabl
dabl 定位为一款数据分析基线库,旨在降低机器学习建模的门槛。它提供了多种实用特性,使得开发者仅需编写几行 Python 代码,即可完成数据的处理、分析与建模工作。
安装
pip install dabl
1、数据预处理
dabl 能够通过少量 Python 代码自动执行数据预处理的整个管道流程。其自动执行的预处理步骤包括识别数据中的缺失值、移除冗余特征,以及理解各特征的数据类型,从而为后续的特征工程提供基础。
dabl 能够自动检测并识别以下类型的特征:
continuous
categorical
date
Dirty_float
Low_card_int
free_string
Useless
dabl 仅需一行 Python 代码,即可将数据集中的所有特征自动归类到上述定义的数据类型中。
df_clean = dabl.clean(df, verbose=1)
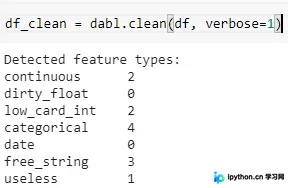
以原始的 Titanic 数据集为例,该数据集包含12个特征。dabl 会自动将这些特征分类为前述的数据类型,以便进行后续的特征工程处理。此外,dabl 还提供了手动修改任意特征数据类型的功能,以满足特定需求。
db_clean = dabl.clean(db, type_hints={"Cabin": "categorical"})
可以通过调用 detect_types() 函数来查看系统为每个特征分配的具体数据类型。
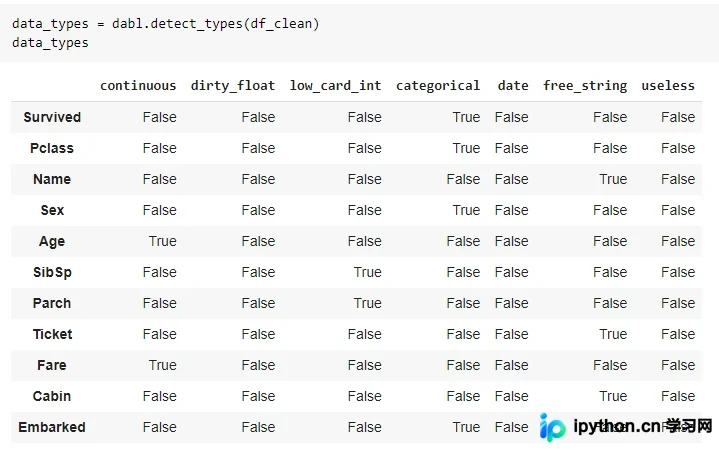
2、探索性数据分析
探索性数据分析(EDA)是数据科学模型开发生命周期中不可或缺的重要环节。虽然 Seaborn、Matplotlib 等可视化库可用于执行各种分析以深入理解数据集,但 dabl 使得 EDA 过程变得极其简单,并能节省大量时间。
dabl.plot(df_clean, target_col="Survived")
dabl 中的 plot() 函数支持绘制多种图表以实现可视化分析,具体包括:
- 目标变量分布的条形图
- 散点配对图
- 线性判别分析图
dabl 会自动对数据集执行主成分分析(PCA),并展示数据集中所有特征的判别性 PCA 图表。
3、建模
dabl 能够在训练数据上自动训练多种基线机器学习算法,以此加速建模工作流程,并自动返回性能表现最佳的模型。dabl 会基于简单的假设,为基线模型生成相应的性能指标。
可以使用 dabl 中的 SimpleClassifier() 函数来进行建模,该函数运行迅速,能够快速返回最佳模型结果。
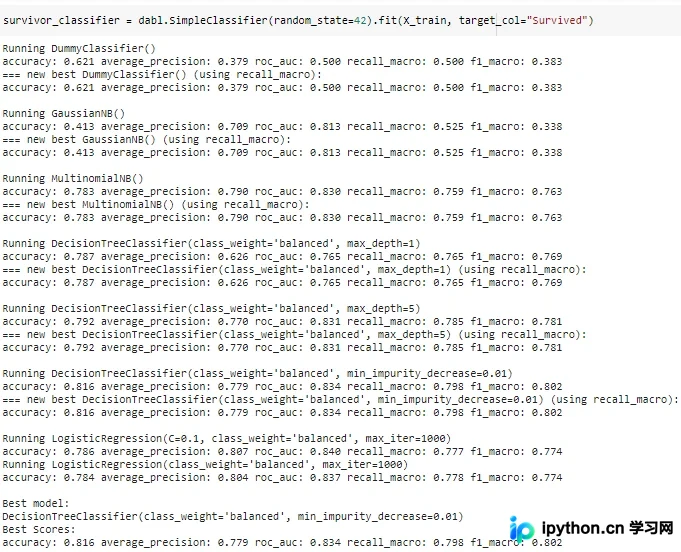
结论
dabl 是一个便捷实用的工具,它使得机器学习变得更加容易且高效。开发者仅需几行 Python 代码,即可完成数据清理、特征可视化以及基线模型的开发工作。
如需了解更多详细信息,可以访问 GitHub 仓库:https://github.com/amueller/dabl
以上就是关于使用 Python dabl 库通过几行代码实现数据处理分析及机器学习自动化的详细内容。如需获取更多关于 dabl 数据处理分析及 ML 自动化的资料,请关注本站发布的其他相关文章。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















