


Python百行代码实现汉服圈图片爬取

本文介绍如何使用Python编写百行代码,通过XPath定位元素,自动遍历汉服资讯网站分页,提取文章标题与图片链接,并批量下载高清图片至本地文件夹。
在旅游景区,穿着各式服装拍照的游客屡见不鲜,通常不会引起特别关注。日前浏览网页时,偶然发现一个汉服展示网站,其中的汉服造型令人惊艳。无论是用于工作素材积累还是创意文案创作,这些精美的图片都是极佳的资源。既然有需求,那就动手抓取,快速实现图片获取。
接下来将详细介绍图片爬取的具体实施步骤。
分析网站
目标网址如下:
https://www.aihanfu.com/zixun/tushang-1/
这是第一页的链接。通过观察发现,第二页的URL仅将末尾的数字由1变为2,后续页面依此类推,只需递增该数字即可访问所有分页内容。
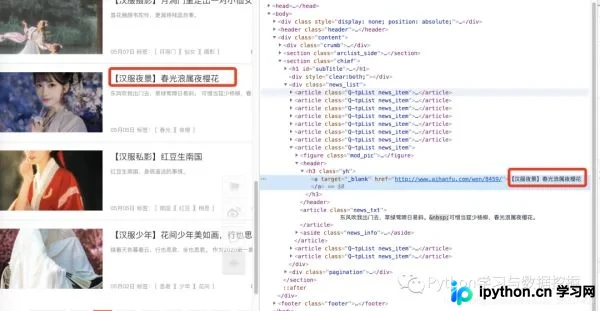
根据页面结构,我们需要提取每个子页面的链接(即href属性中的URL),进入子页面后定位图片地址,随后执行下载操作。
子链接获取
为了提取上述数据,可以使用soup、re或xpath等多种方法。本文采用xpath进行定位,编写定位函数以获取每个子页面的链接,并返回主函数。此处展示了一个在for循环中使用的技巧,值得参考。
def get_menu(url, heades):
    """
    根据每一页的网址
    获得每个链接对应的子网址
    params: url 网址
    """
    r = requests.get(url, headers=headers)
    if r.status_code == 200:
        r.encoding = r.apparent_encoding
        html = etree.HTML(r.text)
        html = etree.tostring(html)
        html = etree.fromstring(html)
        # 查找每个子网址对应的链接, 然后返回
        children_url = html.xpath('//div[@class="news_list"]//article/figure/a/@href')
        for _ in children_url:
            yield _
获取标题和图片地址
为了最大化采集数据量,我们同时提取标签和图片地址。若其他项目需要采集发布者或发布时间,同样可以实现,但本文不再展开讨论。
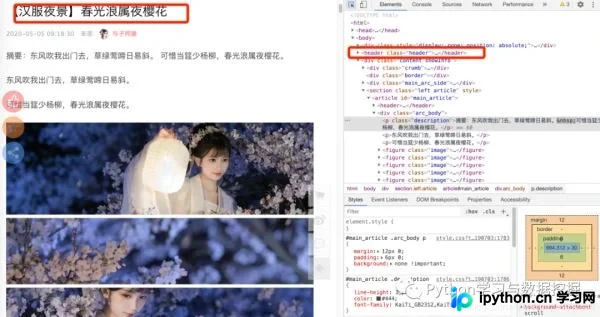
点击任意子链接,如上图所示,可以发现标题位于head节点内。获取标题的主要目的是在本地创建对应的文件夹时使用。
相关代码如下:
def get_page(url, headers):
    """
    根据子页链接,获得图片地址,然后打包下载
    params: url 子网址
    """
    r = requests.get(url, headers=headers)
    if r.status_code == 200:
        r.encoding = r.apparent_encoding
        html = etree.HTML(r.text)
        html = etree.tostring(html)
        html = etree.fromstring(html)
        # 获得标题
        title = html.xpath(r'//*[@id="main_article"]/header/h1/text()')
        # 获得图片地址
        img = html.xpath(r'//div[@class="arc_body"]//figure/img/@src')
        # title 预处理
        title = ''.join(title)
        title = re.sub(r'【|】', '', title)
        print(title)
        save_img(title, img, headers)
保存图片
在遍历每一页时,我们需要将子链接对应的图片保存下来。此步骤需注意对请求状态码的判断以及本地路径的正确处理。
def save_img(title, img, headers):
    """
    根据标题创建子文件夹
    下载所有的img链接,选择更改质量大小
    params:title : 标题
    params:  img :  图片地址
    """
    if not os.path.exists(title):
        os.mkdir(title)
    # 下载
    for i, j in enumerate(img):  # 遍历该网址列表
        r = requests.get(j, headers=headers)
        if r.status_code == 200:
            with open(title + '//' + str(i) + '.png', 'wb') as fw:
                fw.write(r.content)
        print(title, '中的第', str(i), '张下载完成!')
主函数
if __name__ == '__main__':
    """
    一页一页查找
    params : None
    """
    path = '/Users/********/汉服/'
    if not os.path.exists(path):
        os.mkdir(path)
        os.chdir(path)
    else:
        os.chdir(path)
    # url = 'http://www.aihanfu.com/zixun/tushang-1/'
    headers = {'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64)'
                             ' AppleWebKit/537.36 (KHTML, like Gecko)'
                             ' Chrome/81.0.4044.129 Safari/537.36'}
    for _ in range(1, 50):
        url = 'http://www.aihanfu.com/zixun/tushang-{}/'.format(_)
        for _ in get_menu(url, headers):
            get_page(_, headers)  # 获得一页
至此,所有环节均已处理完毕。关于爬虫的文章已多次介绍,旨在帮助大家熟悉爬虫技巧。此外,笔者认为爬虫是数据分析和数据挖掘的基础,没有数据获取,数据分析便无从谈起。
以上就是python百行代码实现汉服圈图片爬取的详细内容,更多关于python爬取汉服圈图片的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















