


Python使用逻辑回归进行垃圾邮件分类的完整实现

本文详细介绍如何使用Python和逻辑回归算法对垃圾邮件数据集进行分类。内容涵盖数据预处理、训练集与测试集划分、模型构建及参数调优。通过对比l1、l2、elasticnet和none等不同惩罚项对模型性能的影响,并计算分类准确率及错误样本,帮助读者掌握逻辑回归在文本分类中的实际应用。
数据加载与预处理
首先加载垃圾邮件数据集spambase.csv。该数据集包含4601个样本,每个样本具有57个特征,目标变量为二分类标签。
其中,标签1代表垃圾邮件,标签0代表非垃圾邮件。在开始建模前,需仔细阅读数据并理解其基本结构。
接下来对数据集进行标准化处理,以满足模型输入要求。
第一步,从数据集中分离出特征列和目标列。将仅包含特征的数据部分赋值给变量X,将仅包含目标标签的数据部分赋值给变量Y。
第二步,将完整数据集划分为训练集和测试集,比例设置为70%用于训练,30%用于测试。
逻辑回归模型构建
完成数据准备后,开始构建逻辑回归模型。
使用sklearn库中的LogisticRegression类初始化模型,并进行训练。
模型结果评估与参数对比
模型训练完成后,需要对结果进行详细比对和分析。
首先,输出测试集前5个样本的预测结果,以直观检查模型的初步表现。
其次,计算模型在测试集上的分类准确率。准确率的定义为正确分类的样本数除以测试集的总样本数。
接着,从测试集中筛选出模型未能正确预测的样本,以便进一步分析误判原因。
最后,针对LogisticRegression模型的penalty参数,分别设置其值为'l1'、'l2'、'elasticnet'和'none',对比不同惩罚项在测试集上的预测性能,并通过计算score值来评估各模型的表现。
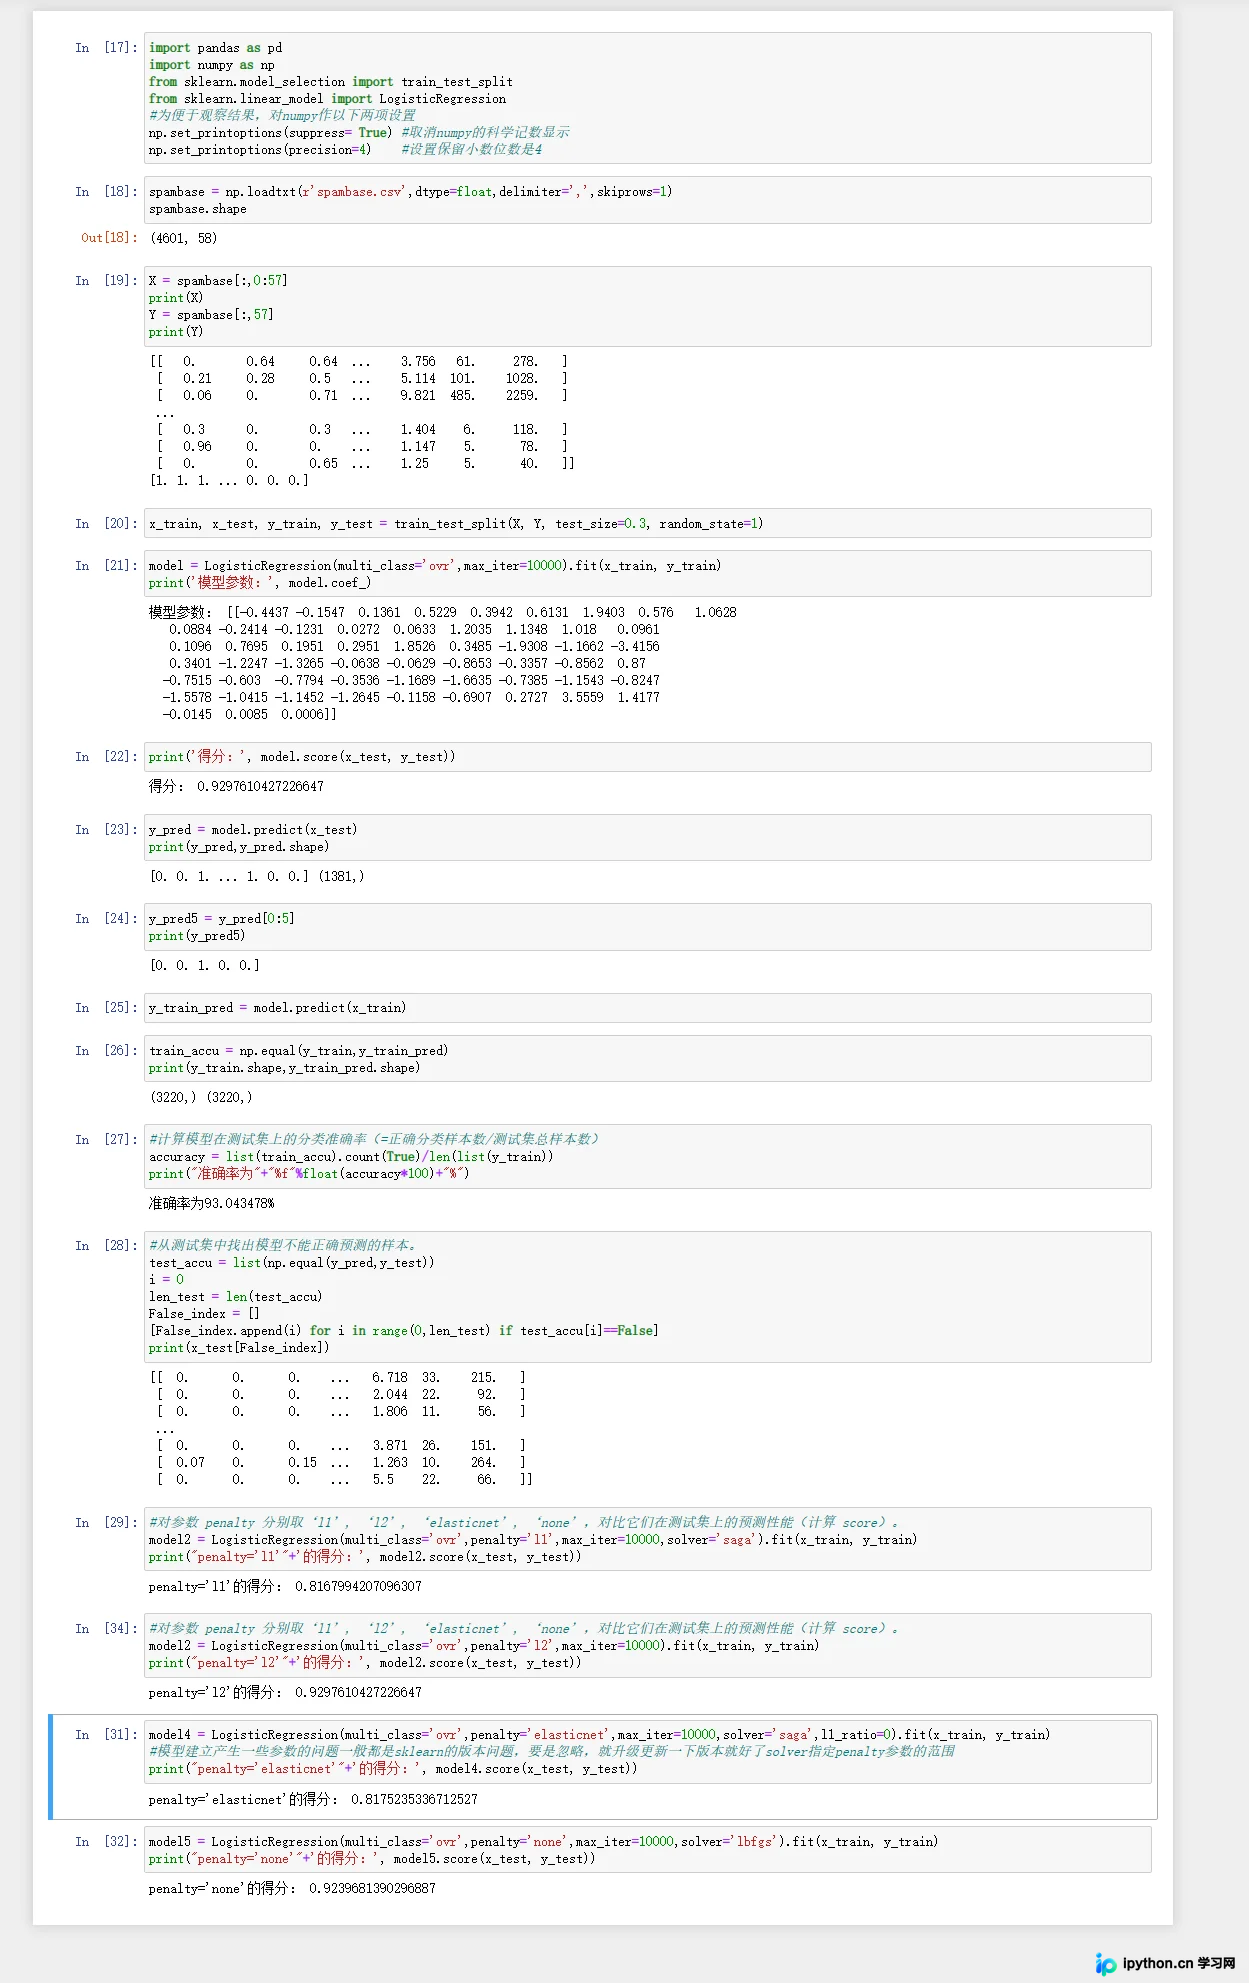
特征值与目标数据的拆分以及预测和模型得分的计算均可直接调用模型方法实现。本部分重点在于测试准确率和识别错误预测样本,主要涉及Numpy模块和列表list函数的应用。具体代码实现如下所示。
y_train_pred = model.predict(x_train)


# In[26]:


train_accu = np.equal(y_train,y_train_pred)
print(y_train.shape,y_train_pred.shape)


# In[27]:


#计算模型在测试集上的分类准确率(=正确分类样本数/测试集总样本数)
accuracy = list(train_accu).count(True)/len(list(y_train))
print("准确率为"+"%f"%float(accuracy*100)+"%")


# In[28]:


#从测试集中找出模型不能正确预测的样本。
test_accu = list(np.equal(y_pred,y_test))
i = 0
len_test = len(test_accu)
False_index = []
[False_index.append(i) for i in range(0,len_test) if test_accu[i]==False]
print(x_test[False_index])


# In[29]:


#对参数 penalty 分别取‘l1', ‘l2', ‘elasticnet', ‘none',对比它们在测试集上的预测性能(计算 score)。
model2 = LogisticRegression(multi_class='ovr',penalty='l1',max_iter=10000,solver='saga').fit(x_train, y_train)
print("penalty='l1'"+'的得分:', model2.score(x_test, y_test))


# In[33]:


#对参数 penalty 分别取‘l1', ‘l2', ‘elasticnet', ‘none',对比它们在测试集上的预测性能(计算 score)。
model2 = LogisticRegression(multi_class='ovr',penalty='l2',max_iter=10000).fit(x_train, y_train)
print("penalty='l2'"+'的得分:', model2.score(x_test, y_test))


# In[31]:


model4 = LogisticRegression(multi_class='ovr',penalty='elasticnet',max_iter=10000,solver='saga',l1_ratio=0).fit(x_train, y_train)
#模型建立产生一些参数的问题一般都是sklearn的版本问题,要是忽略,就升级更新一下版本就好了solver指定penalty参数的范围
print("penalty='elasticnet'"+'的得分:', model4.score(x_test, y_test))


# In[32]:


model5 = LogisticRegression(multi_class='ovr',penalty='none',max_iter=10000,solver='lbfgs').fit(x_train, y_train)
print("penalty='none'"+'的得分:', model5.score(x_test, y_test))
本文介绍了基于Python逻辑回归的垃圾邮件分类流程,包括数据预处理、模型训练及性能评估。
至此,关于Python垃圾邮件逻辑回归分类的教程已介绍完毕。如需了解更多Python垃圾邮件分类相关内容,建议搜索本站历史文章或继续浏览后续相关文章。感谢大家的支持与关注。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















