


Python+OpenCV实战:利用K-Means聚类进行图像色彩量化

本文介绍如何使用OpenCV的cv2.kmeans()函数在Python中实现图像色彩量化。通过调整K值控制颜色数量与图像质量的平衡,并展示如何统计像素分布及可视化色彩分布图,帮助开发者在内存受限设备上优化图像显示效果。
前言
K-Means聚类算法旨在将n个样本划分为K个簇。在之前的博文《OpenCV与机器学习的碰撞》中,我们已接触过OpenCV提供的cv2.kmeans()函数,该函数通过寻找簇中心并将样本分组至簇周围来实现聚类。本文将继续深入,探讨如何利用K-Means聚类算法进行色彩量化,从而有效减少图像中的颜色数量。
利用 K-Means 聚类进行色彩量化
色彩量化是指减少图像中颜色数量的过程。对于某些受内存限制只能显示有限颜色的设备而言,色彩量化至关重要。在这些设备上展示图像时,通常需要在色彩准确性和减少颜色数量之间取得平衡。利用K-Means聚类进行色彩量化时,通过合理设置K参数即可实现这种平衡。
利用K-Means聚类算法执行色彩量化时,簇中心数据由3个特征组成,分别对应图像每个像素的B、G、R值。因此,关键步骤是将图像数据转换为适合算法处理的格式:
data = np.float32(image).reshape((-1, 3))为了观察准确性与颜色数量之间的权衡效果,我们分别使用K值为3、5、10、20和40执行聚类过程,观察生成图像的变化。若希望结果图像仅包含3种颜色(即K=3),需执行以下操作:
首先加载BGR格式的图像:
img = cv2.imread('example.jpg')
接着调用color_quantization() 函数执行色彩量化处理:
def color_quantization(image, k):
    # 将图像转换为数据
    data = np.float32(image).reshape((-1, 3))
    # 算法终止条件
    criteria = (cv2.TERM_CRITERIA_EPS + cv2.TERM_CRITERIA_MAX_ITER, 20, 1.0)
    # K-Means 聚类
    ret, label, center = cv2.kmeans(data, k, None, criteria, 10, cv2.KMEANS_RANDOM_CENTERS)
    # 簇中心
    center = np.uint8(center)
    # 将具有 k 颜色中心的图像转换为 uint8
    result = center[label.flatten()]
    result = result.reshape(img.shape)
    return result
color_3 = color_quantization(img, 3)
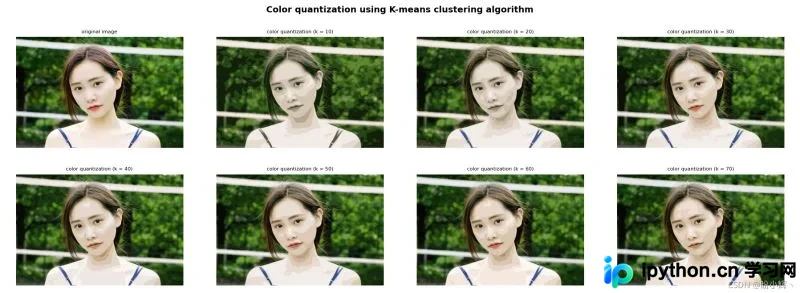
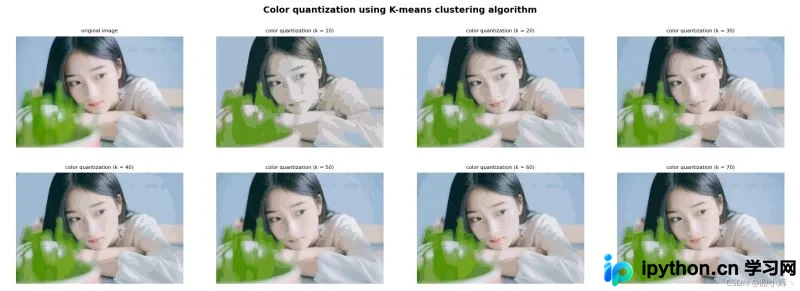
在color_quantization() 函数中,核心在于利用 cv2.kmeans()方法。最终,可以使用k种颜色构建图像,用对应的中心值替换每个像素的值。程序运行结果如下所示:
完整代码
利用K-Means聚类进行色彩量化的完整代码如下所示:
import numpy as np
import cv2
from matplotlib import pyplot as plt


def show_img_with_matplotlib(color_img, title, pos):
    img_RGB = color_img[:, :, ::-1]

    ax = plt.subplot(2, 4, pos)
    plt.imshow(img_RGB)
    plt.title(title, fontsize=8)
    plt.axis('off')

def color_quantization(image, k):
    # 将图像转换为数据
    data = np.float32(image).reshape((-1, 3))
    # 算法终止条件
    criteria = (cv2.TERM_CRITERIA_EPS + cv2.TERM_CRITERIA_MAX_ITER, 20, 1.0)
    # K-Means 聚类
    ret, label, center = cv2.kmeans(data, k, None, criteria, 10, cv2.KMEANS_RANDOM_CENTERS)
    # 簇中心
    center = np.uint8(center)
    # 将具有 k 颜色中心的图像转换为 uint8
    result = center[label.flatten()]
    result = result.reshape(img.shape)
    return result

fig = plt.figure(figsize=(16, 8))
plt.suptitle("Color quantization using K-means clustering algorithm", fontsize=14, fontweight='bold')
# 图片加载
img = cv2.imread('example.png')
show_img_with_matplotlib(img, "original image", 1)
# 使用不同 K 值进行色彩量化
for i in range(7):
    color = color_quantization(img, (i+1) * 10)
    show_img_with_matplotlib(color, "color quantization (k = {})".format((i+1) * 10), i+2)

plt.show()
显示色彩量化后的色彩分布
我们可以扩展上述程序以显示色彩量化后的色彩分布,该分布展示了分配给每个聚类中心的像素数量。只需对color_quantization()函数进行扩展,使其包含所需功能即可:
import collections
def color_quantization(image, k):
    # 将图像转换为数据
    data = np.float32(image).reshape((-1, 3))
    # 算法终止条件
    criteria = (cv2.TERM_CRITERIA_EPS + cv2.TERM_CRITERIA_MAX_ITER, 20, 1.0)
    # K-Means 聚类
    ret, label, center = cv2.kmeans(data, k, None, criteria, 10, cv2.KMEANS_RANDOM_CENTERS)
    # 簇中心
    center = np.uint8(center)
    # 将具有 k 颜色中心的图像转换为 uint8
    result = center[label.flatten()]
    result = result.reshape(img.shape)
    # 统计分配给每个聚类中心的像素数
    counter = collections.Counter(label.flatten())
    print(counter)
    # 计算输入图像的总像素数
    total = img.shape[0] * img.shape[1]
    # 为色彩分布图像指定宽度和高度:
    desired_width = img.shape[1]

    desired_height = 70
    desired_height_colors = 50
    # 初始化色彩分布图像
    color_distribution = np.ones((desired_height, desired_width, 3), dtype='uint8') * 255
    start = 0

    for key, value in counter.items():
        # 归一化
        value_normalized = value / total * desired_width
        end = start + value_normalized
        # 绘制与当前颜色对应的矩形
        cv2.rectangle(color_distribution, (int(start), 0), (int(end), desired_height_colors), center[key].tolist(), -1)
        start = end

    return np.vstack((color_distribution, result))
在上述代码中,使用collections.Counter()来统计分配给每个聚类中心的像素数量:
counter = collections.Counter(label.flatten())
例如,当K=10时,可以得到如下统计结果:
Counter({7: 37199, 3: 36302, 0: 29299, 5: 23987, 6: 23895, 1: 20077, 9: 19814, 8: 18427, 4: 16221, 2: 14779})
构建好色彩分布图像后,将其与色彩量化后的图像进行垂直连接:
np.vstack((color_distribution, result))
程序的最终输出如下所示:
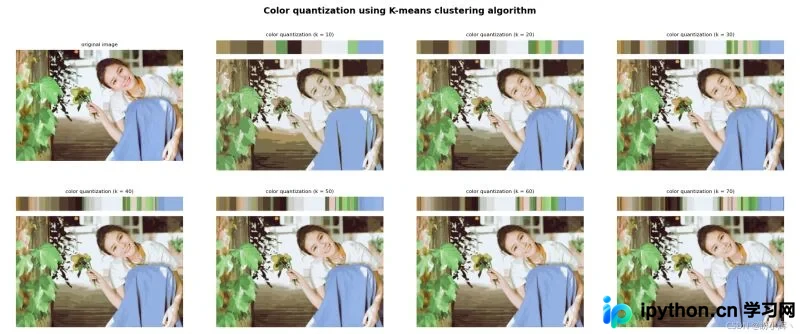
从上图可以看出,应用K-Means聚类算法进行色彩量化后,改变参数k(分别为10、20、30、40、50、60和70)会产生不同结果。k值越大,生成的图像越逼真。
Note:除了color_quantization()函数外,由于其他代码部分未做修改,因此不再另行列出。
到此这篇关于Python+OpenCV实战之利用 K-Means 聚类进行色彩量化的文章就介绍到这了,更多相关OpenCV K-Means 内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















