


解决mysqldump备份大数据库速度慢及内存溢出问题

使用 mysqldump 备份数十 GB 乃至上百 GB 的数据表时,系统往往会出现两种典型异常:一是备份进程占用内存飙升,最终触发系统级 Out Of Memory (OOM) 导致进程被强行 Kill;二是备份耗时极长,中途频繁抛出 Lost connection to MySQL server during query (error 2013)。这类问题的根源不在于数据量本身,而在于 mysqldump 默认采用了全表行集在客户端内存中整体缓冲的工作模式,加之单线程写入与 I/O 阻塞。本文将直接拆解其底层数据流,给出可落地的核心参数配置与标准化执行流程。
一、mysqldump 内存溢出与吞吐瓶颈的根源分析
很多排查人员在遇到内存溢出时,第一反应是去调大服务器的物理内存,但往往收效甚微。mysqldump 本质上是一个运行在客户端位置的命令行工具(即使你在数据库主机本地执行,它也是通过 MySQL 客户端协议同服务端交互)。默认情况下,它调用的 C API 是 mysql_store_result()。
该调用会将整张查询表产生的所有数据行,先一口气全部接收并写入客户端进程的内存空间中,等到全部加载完毕后,才开始格式化拼接成 SQL 插入语句并输出到标准输出。当遇到上亿行的大表或几百兆单行的 BLOB/TEXT 字段时,内存占用会在几分钟内耗尽系统可用运存,触发 Linux 内核的 OOM-Killer。
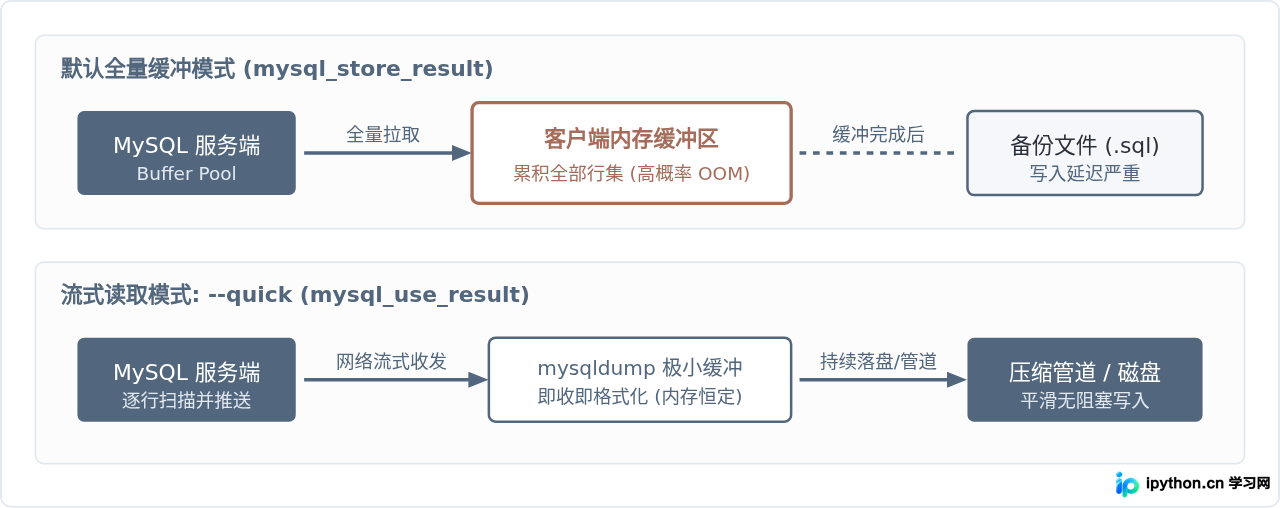
在导出速度慢的问题上,除了全表缓冲拖延了初次落盘时间,还存在另外两个隐性瓶颈:
- 扩展插入语句未优化:单条
INSERT INTO table VALUES (...);会频繁产生 SQL 语法解析和网络数据包开销。开启批量插入能够显著减小生成的转储文件体积并提高后续恢复速度。 - 单线程磁盘 I/O 阻塞:默认将未压缩的 SQL 写入机械盘或普通云盘时,受限于单线程磁盘写入带宽。如果在输出端没有引入高效压缩流(如 pigz),整体速度会被磁盘写入上限卡死。
二、关键参数配置与具体作用
要从根源解决上述问题,必须通过组合参数调整 mysqldump 与服务端的网络通信协议以及缓冲策略。下表列出了核心参数的配置要求与具体作用:
| 参数名称 | 推荐设定 | 针对解决的问题与原理 |
|---|---|---|
--quick (-q) |
必须显式开启 | 彻底避免内存溢出。指示 mysqldump 改用 mysql_use_result() 逐行从服务端拉取数据,跳过本地缓冲。 |
--single-transaction |
InnoDB 表必须开启 | 基于 MVCC 实现可重复读隔离级别的一致性快照备份,避免执行全局锁表(FTWRL),保障生产读写不阻塞。 |
--max_allowed_packet |
512M 或 1G |
避免因单行大字段(如 JSON、MEDIUMTEXT、BLOB)超过客户端通信包上限而触发中断断开。 |
--net_buffer_length |
16384 (16KB) - 1M |
连续批量 INSERT 语句的初始缓冲区长度,通常与 --extended-insert 配合使用提升吞吐。 |
--extended-insert |
默认开启 (保留) | 使用包含多个 VALUES 列表的多行语法,大幅缩减导出文件的总体积与语法解析耗时。 |
--quick 后,数据变为逐行在网络通道中检索。如果备份的服务器网络延迟较高,或者执行备份的机器磁盘写入极慢,可能导致服务端在等待网络发送时超时。如果遇到 net_write_timeout 报错,需临时增加服务端的该变量值(例如调整为 3600 秒)。
三、大库备份的标准执行流程与操作步骤
解决慢与溢出的标准操作不是单一执行一条命令,而是涵盖备份前网络参数检查、执行低内存流式备份,以及管道多线程压缩三个环节。
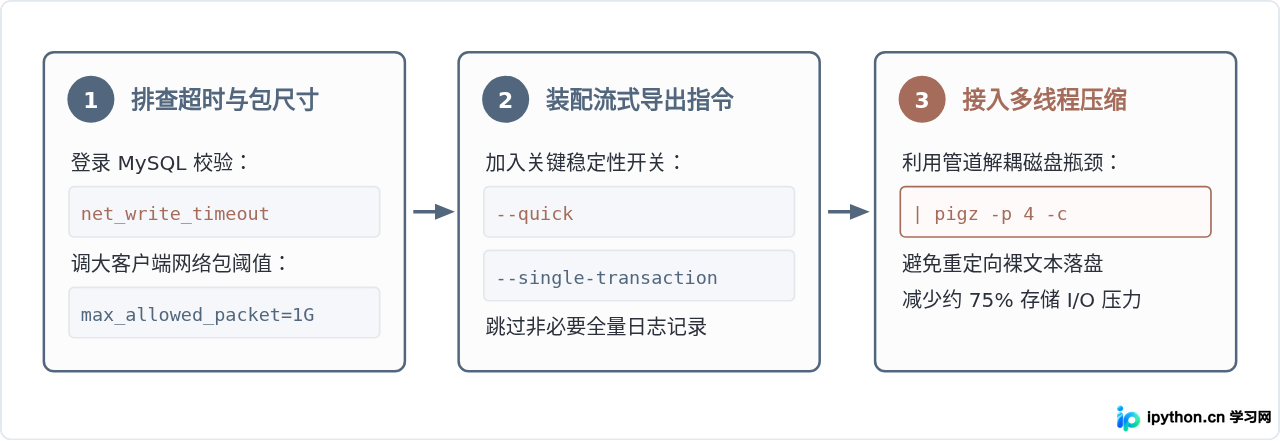
第一步:临时调整服务端超时设置
在执行大库备份前,连接到数据库实例,检查并提升超时参数。这一步能避免由于网络流量突发排队引发的连接中断:
-- 登录数据库查看当前超时设定
SHOW GLOBAL VARIABLES LIKE '%timeout%';

-- 针对当前备份会话或全局临时放大网络写入与读取超时(单位:秒)
SET GLOBAL net_write_timeout = 3600;
SET GLOBAL net_read_timeout = 3600;
第二步:组装完整的高性能备份命令
在命令行执行 mysqldump 时,必须显式带上防 OOM 参数,并配合 Linux 管道直接流向多线程压缩工具(如 pigz,若未安装可替换为常规 gzip)。以下为标准生产执行示例:
mysqldump \
  --host=127.0.0.1 \
  --port=3306 \
  --user=backup_user \
  --password='YourSecurePassword' \
  --single-transaction \
  --quick \
  --max_allowed_packet=1024M \
  --net_buffer_length=1048576 \
  --extended-insert \
  --triggers \
  --routines \
  --events \
  --default-character-set=utf8mb4 \
  --databases production_db \
  | pigz -p 4 > /data/backup/production_db_$(date +%F).sql.gz
第三步:验证备份完整性
执行完成后,不能仅依据进程是否返回 0 来断定备份正常。由于管道命令的存在,默认 Shell 可能会掩盖管道前端 mysqldump 的非零错误码。可以检查输出文件结尾的标志性注释:
# 检查压缩包尾部是否包含 Dump completed 注释
zcat /data/backup/production_db_$(date +%F).sql.gz | tail -n 10
示例输出:
-- Dump completed on 2026-09-22 00:15:30若末尾明确出现了 Dump completed 字样,证明没有发生因中途超时或 OOM 导致的截断。
四、网络断开(2013/2006 错误)的快速排查与参数联动
配置了 --quick 后,客户端内存问题已彻底消除,但可能引入“网络读取超时”。其物理过程如下图所示:客户端通过网络请求逐行读取时,如果客户端写入慢,服务端会把数据持续塞向内核 TCP 发送缓冲区(Send-Q)。当缓冲区填满且客户端在 net_write_timeout 指定的窗口期内未能腾出空位,服务端就会强行断开连接。
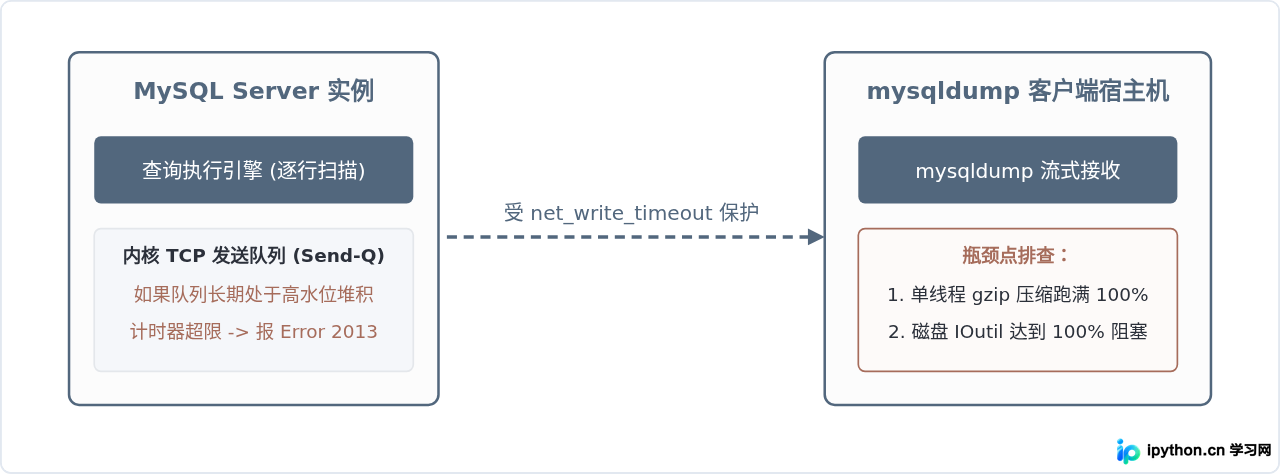
要排查并消除此类 2013 错误,请按以下条目对照调整:
- 解除 CPU 单核压缩瓶颈:常规
gzip仅能调动 1 个 CPU 核心,无法跟上高速网络传输的节奏,反向阻塞了从网络接收数据的速度。换用pigz -p [CPU核心数]可以平摊计算负载,避免管道反压。 - 调整数据包吞吐上限:如果大表中存在
LONGBLOB或单行包含海量数据的 JSON 数组,务必保证服务端与 mysqldump 端的max_allowed_packet均设置为1024M,防止遇到超长记录时直接触发网络连接断开。 - 分表并行导出:如果数据库内包含上千张中大型表,与其单进程处理全部数据,不如编写简易脚本按表拆分,通过
xargs -P 4发起 4 个并发的 mysqldump 会话,充分利用服务器多核心与带宽资源。
五、优化方案总结与技术选型边界
针对大数据库备份,调优 mysqldump 参数能够以最低的认知与架构成本解决绝大部分内存溢出与导出慢的问题。但需要明确的是,逻辑导出在数据量突破数 TB 之后,必然会遭遇逻辑解析与反序列化的性能墙。
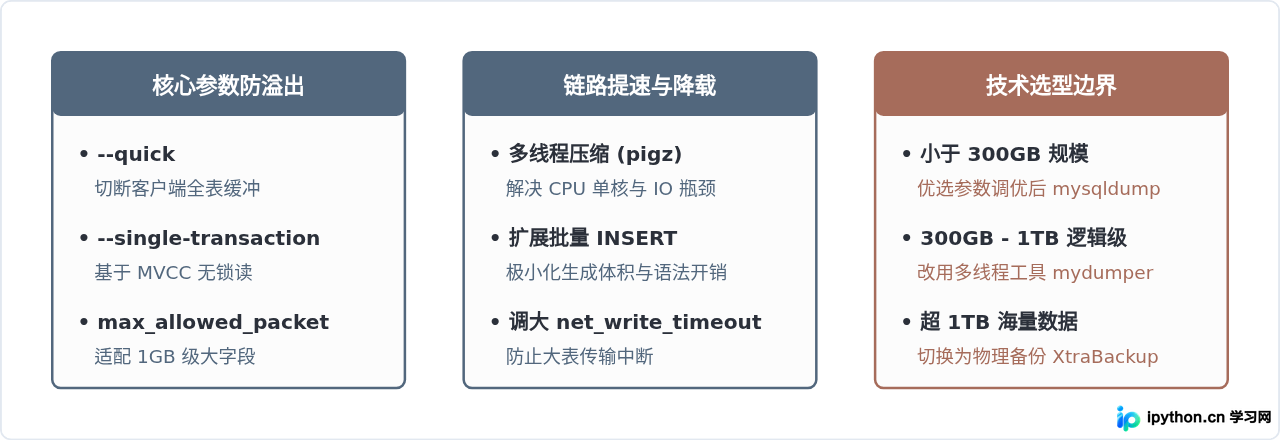
在实际生产环境中:
- 对于 300GB 以下的数据体量,添加
--quick、--single-transaction与pigz管道足以在几十分钟到数小时内平稳完成导出,且内存占用基本恒定在几十兆以内。 - 当单库体量达到 数百 GB 至数 TB 级别且要求极高备份时效时,应评估选用并行逻辑导出工具
mydumper,或直接采用基于拷贝数据文件副本的物理备份方案(如 Percona XtraBackup),从而跳过 SQL 文本构造,达成更高的吞吐与更短的业务 RTO。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















