


Ollama本地部署AI大模型:Windows与Mac一键安装教程

在云端API调用日益普及的今天,许多用户开始担忧数据隐私、网络延迟以及持续订阅的费用。对于普通开发者或科技爱好者而言,想要体验最新的大语言模型(LLM),往往被复杂的Python环境配置、显卡驱动兼容性以及庞大的依赖库劝退。
这种“想玩怕麻烦”的矛盾,正是Ollama出现的意义所在。它不是一个需要深入研究的框架,而更像是一个为大模型设计的“应用商店”加“运行时引擎”。
Ollama的核心价值在于将本地部署的门槛降到了最低:只需一条命令,就能让LLaMA 3、Mistral等主流模型在你的Windows或Mac上跑起来。 它屏蔽了底层的CUDA配置、量化处理和内存管理细节,让用户能专注于与模型交互本身,而非与环境搏斗。
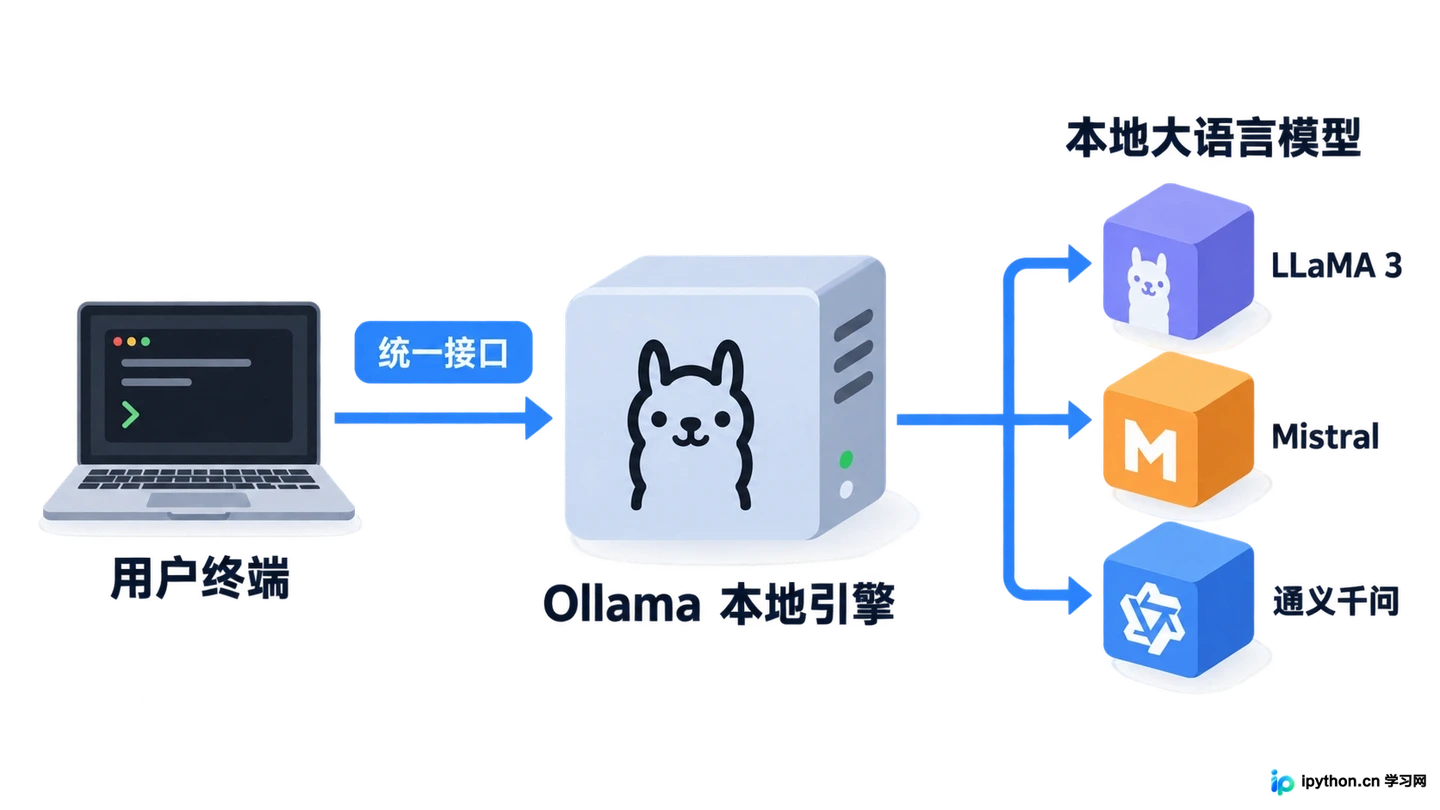
Ollama简化了底层依赖,提供统一的命令行接口
安装逻辑:从“配置环境”到“双击运行”
传统部署本地模型通常需要安装Anaconda、PyTorch、配置环境变量,还要担心GPU显存是否足够。Ollama改变了这一流程,它将模型运行所需的所有依赖打包成一个独立的可执行程序。
在Windows上,你只需要访问官网下载安装包,像安装普通软件一样点击“下一步”。安装完成后,Ollama会自动在后台运行一个本地服务,并提供一个简洁的命令行终端入口。这意味着你不需要打开复杂的IDE,也不需要编写任何Python脚本,系统托盘里的小图标就代表了你的本地AI服务器已经就绪。
Mac用户的体验则更为无缝。无论是Intel芯片还是Apple Silicon(M1/M2/M3),Ollama都提供了原生的arm64支持。得益于macOS统一的内存架构,大模型可以直接调用系统内存作为显存使用,这在一定程度上缓解了消费级显卡显存不足的焦虑。安装过程同样简单,下载dmg文件拖入应用程序文件夹即可,首次启动时系统可能会提示权限确认,允许后即可在终端中直接调用。
这种“去开发化”的安装逻辑,使得非程序员也能在几分钟内拥有自己的本地AI助手,而不必关心什么是vRAM、什么是quantization。
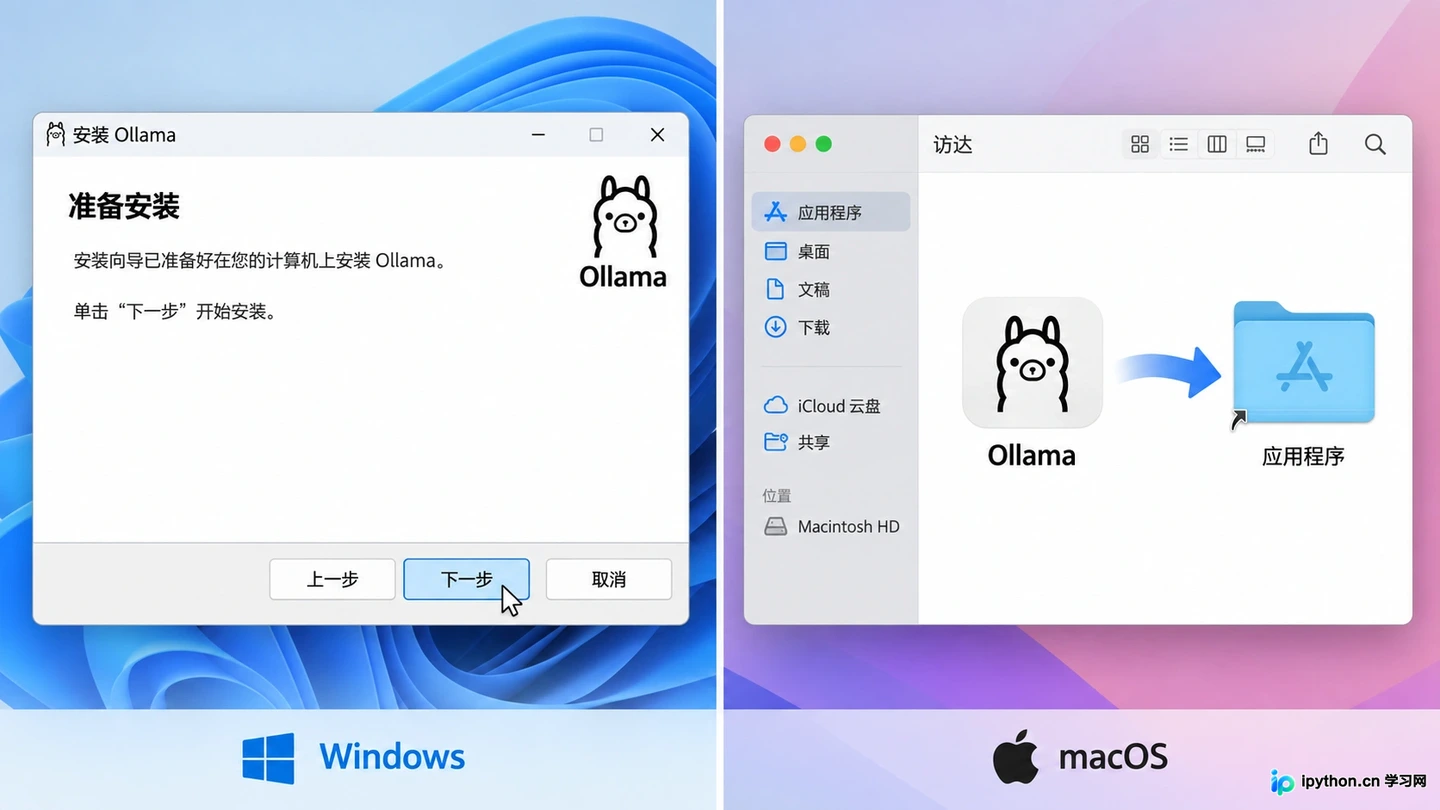
Windows安装包向导与Mac拖拽安装示意
模型获取:像安装App一样选择智能
安装好Ollama只是第一步,真正的灵魂在于模型。Ollama内置了一个类似Docker Hub的模型库,用户无需去Hugging Face下载几十GB的原始权重文件,也不用手动转换格式。
在终端中输入 ollama run llama3,系统会自动检测本地是否有该模型。如果没有,它会从官方源下载经过量化的版本。这里的“量化”是关键,Ollama默认提供4-bit量化模型,这在保持大部分智能水平的同时,将模型体积压缩到了普通电脑可以承受的范围。例如,7B参数的模型通常只需要4-5GB的存储空间和运行内存。
你可以随时切换不同的模型来测试效果。想要更强的逻辑推理?试试 ollama run mistral。需要中文支持更好?可以尝试 ollama run qwen:7b(通义千问)。甚至有一些专门用于代码生成的模型如 codellama,也可以通过同样的命令一键拉取。
这种按需下载、即用即删的机制,极大地降低了试错成本。 你不需要为每个模型预留巨大的硬盘空间,不喜欢某个模型的表现,直接删除即可,没有任何残留配置困扰。
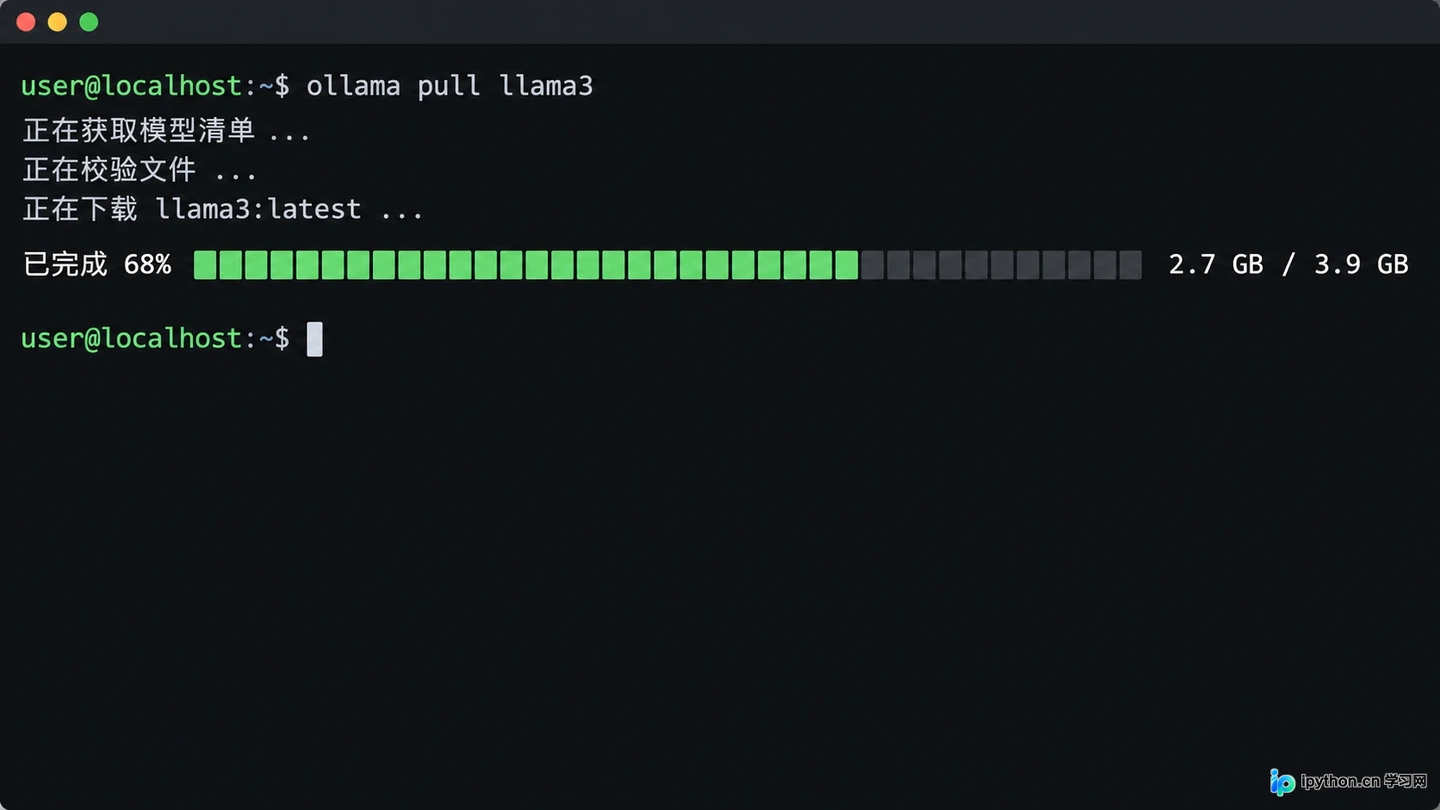
在终端中执行ollama pull命令的进度展示
交互体验:命令行里的自然对话
很多人对命令行有畏难情绪,但Ollama的交互界面异常友好。当你运行 ollama run <模型名> 后,终端会进入一个交互模式,光标闪烁,等待你的输入。
在这里,你可以像使用网页版ChatGPT一样提问。比如询问“如何用Python读取Excel文件”,或者让模型帮你润色一段邮件。由于是本地运行,响应速度取决于你的硬件性能,但在现代笔记本上,7B规模的模型通常能达到每秒数个token的输出速度,足以满足日常阅读和辅助写作的需求。
除了直接对话,Ollama还支持通过API接口与其他软件集成。这意味着你可以将它作为后端,连接到Obsidian、VS Code或其他支持自定义LLM端点的工具中。对于开发者而言,这提供了一个完全可控、无流量限制的本地测试环境;对于普通用户,这也意味着未来会有更多基于Ollama的图形化前端应用出现,进一步隐藏命令行的外壳。
需要注意的是,本地模型的上下文窗口(Context Window)通常有限制,虽然部分模型支持长文本,但在处理超长文档时,可能需要分段输入或使用专门的RAG工具配合,这是当前本地小参数模型的物理边界。
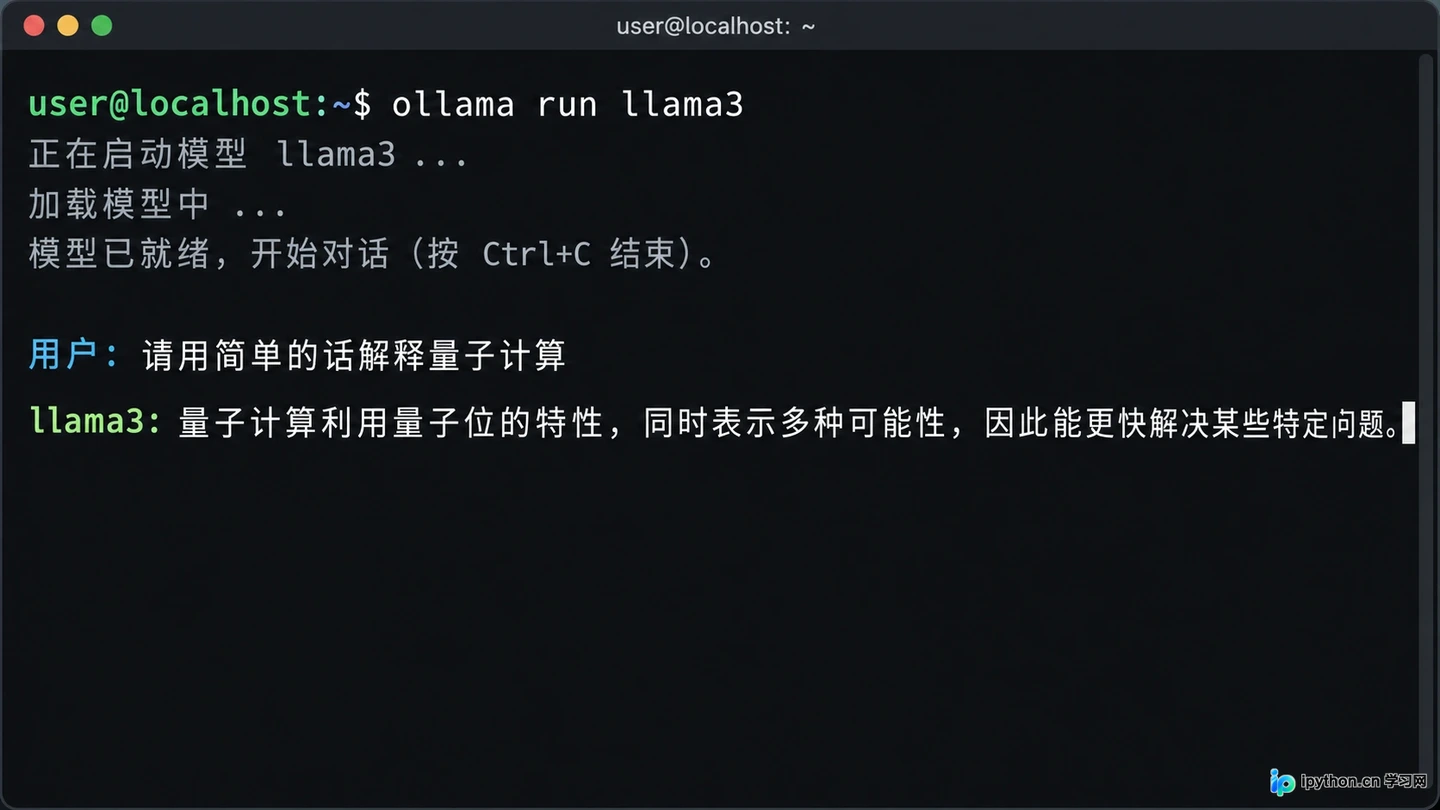
用户在终端中与本地模型进行多轮对话
适用边界:谁应该尝试本地部署?
Ollama并非要取代云端大模型,而是填补了特定场景下的空白。
如果你经常处理敏感数据,如公司财报、个人日记或未公开的代码库,本地部署提供了绝对的隐私安全保障,数据 never leaves your machine。此外,在没有网络连接的环境下,如飞机上或偏远地区,本地模型是你唯一的AI助手。
然而,如果你追求极致的逻辑推理能力、超长的上下文理解或最新的实时资讯,云端的大参数模型(如GPT-4o或Claude 3.5)依然具有不可替代的优势。本地7B或13B模型在复杂任务上的表现仍有差距,且受限于硬件算力,无法做到瞬间响应。
因此,Ollama最适合的是那些对隐私有要求、希望低成本高频次调用AI、或仅仅出于好奇想要探索大模型原理的用户。 它不是万能的超级大脑,但是一个触手可及、完全属于你的数字伙伴。
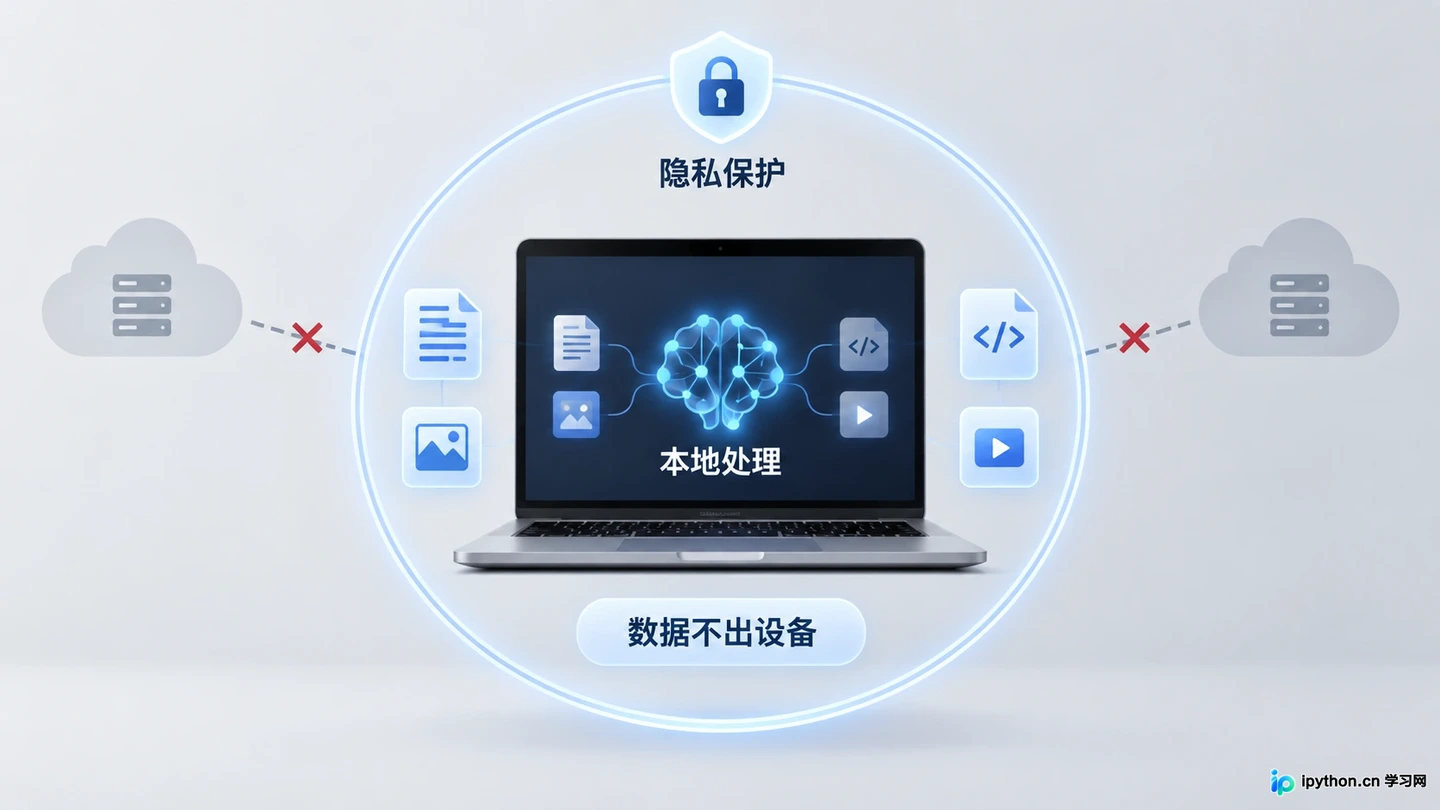
数据在本地设备内部闭环处理
回到最初的取舍:我们牺牲了一部分顶尖的智能水平和便捷的网络接入,换来了数据的绝对主权、零延迟的响应体验以及一次付费(硬件)后无限使用的自由。对于大多数日常辅助任务而言,这种交换是值得的。现在,打开终端,输入那行简单的命令,你的本地AI之旅就已经开始了。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















