


Python实现多组数据显著性差异检验:方差分析与卡方检验实战

发布时间:2026-10-15 |
6人浏览过
本文介绍如何使用Python对多组数据进行显著性差异检验。通过单因素方差分析判断连续变量(如订单量)在各组间是否存在显著差异,并利用卡方检验评估分类指标(如男女比例)的分布一致性。文章包含具体代码实现、统计量计算过程及结果解读,帮助开发者科学验证数据分布特征。
一、方差分析
1.单因素方差分析
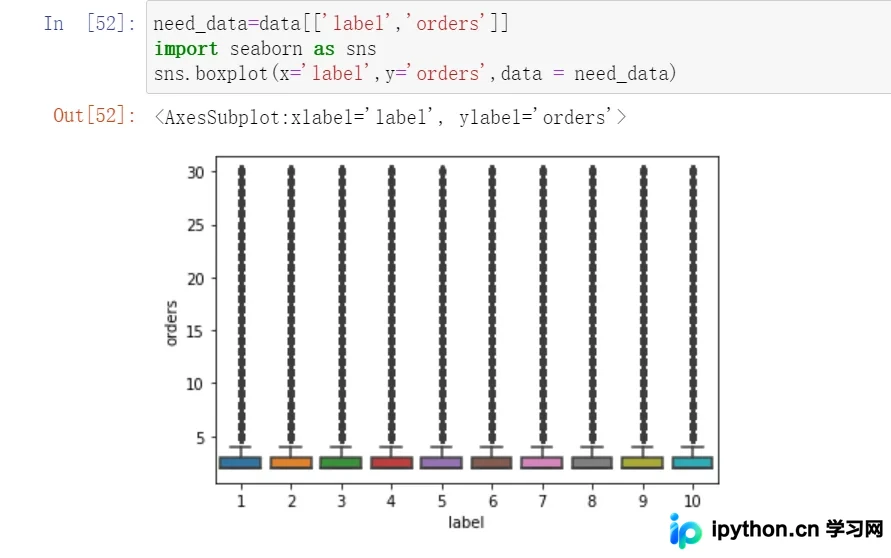
观察箱线图可知,10个组的订单量数值分布较为接近。为了更严谨地评估这10组订单量是否存在统计学上的显著差异,采用方差分析方法进行验证。
from statsmodels.formula.api import ols
from statsmodels.stats.anova import anova_lm
model = ols('orders~C(label)',data=need_data).fit()
anova_table = anova_lm(model, typ = 2)
print(anova_table)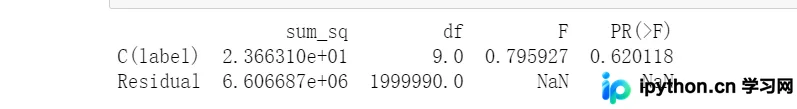
分析结果显示,p值为0.62,该值大于显著性水平0.05。因此无法拒绝原假设,结论表明这10组数据的订单量分布不存在显著差异。
二、卡方检验
若需比较多组数据中非连续型指标是否存在差异,应如何处理?
例如,检验上述10个组别中男女比例是否分布一致。
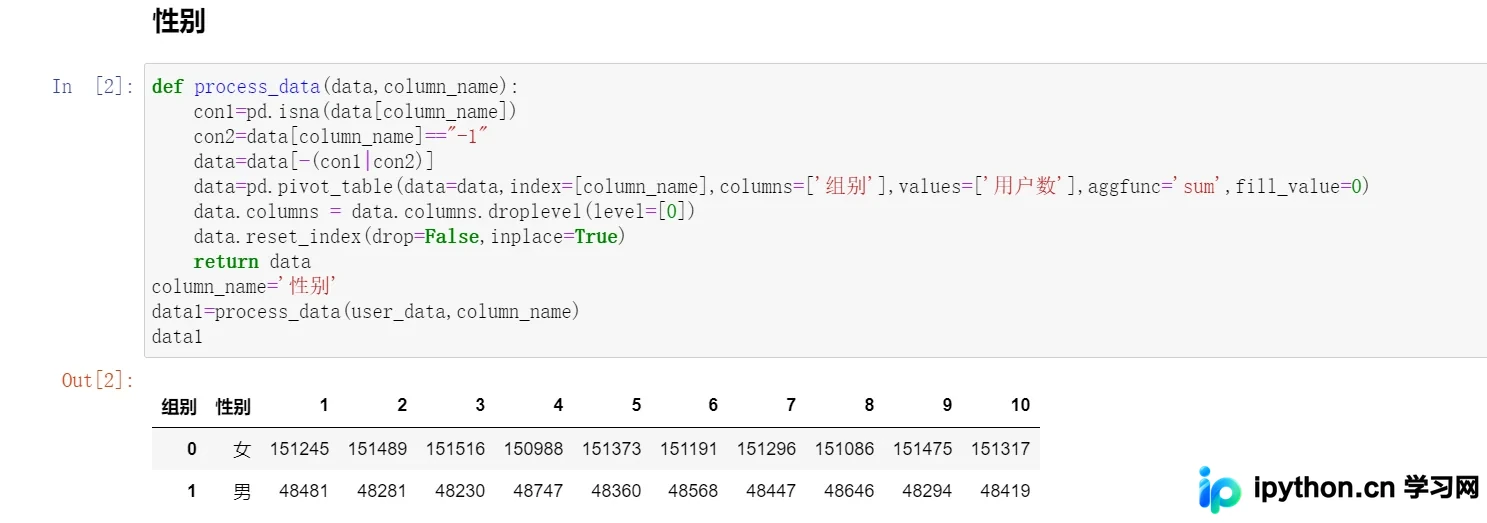
首先计算各组的观察频数:
data2=data1.melt(id_vars=['性别'],value_name='观察频数')
data2.head()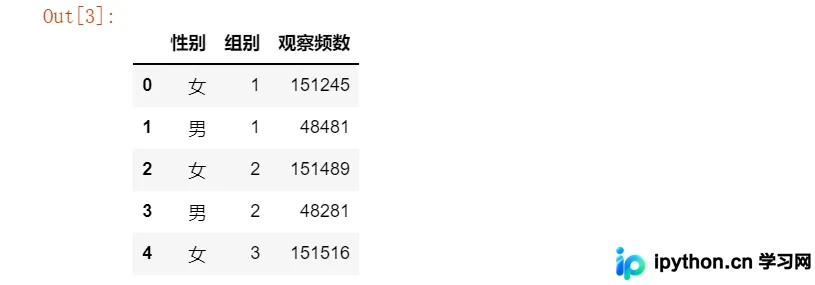
接着计算总体的男女比例:
rate=(data2.groupby(['性别'])['观察频数'].sum()/data2.groupby(['性别'])['观察频数'].sum().sum()).reset_index()
rate.columns=['性别','rate']
rate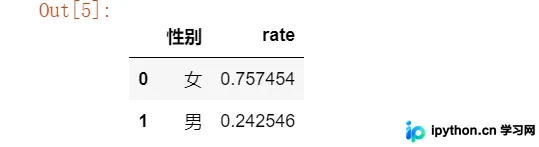
随后统计各组用户总数:
group_sum=data2.groupby(['组别'])['观察频数'].sum().reset_index()
group_sum.columns=['组别','组内用户数']
group_sum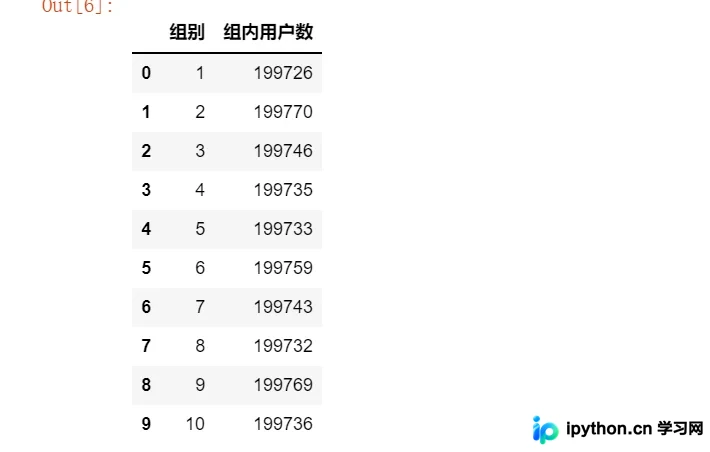
最后计算卡方统计量:
import math
data3=pd.merge(data2,group_sum,on=['组别'],how='left')
data3=pd.merge(data3,rate,on=['性别'],how='left')
data3['期望频数']=data3['组内用户数']*data3['rate']
data3['卡方值']=data3.apply(lambda x: math.pow((x.期望频数-x.观察频数),2)/x.期望频数,axis=1)
data3.head()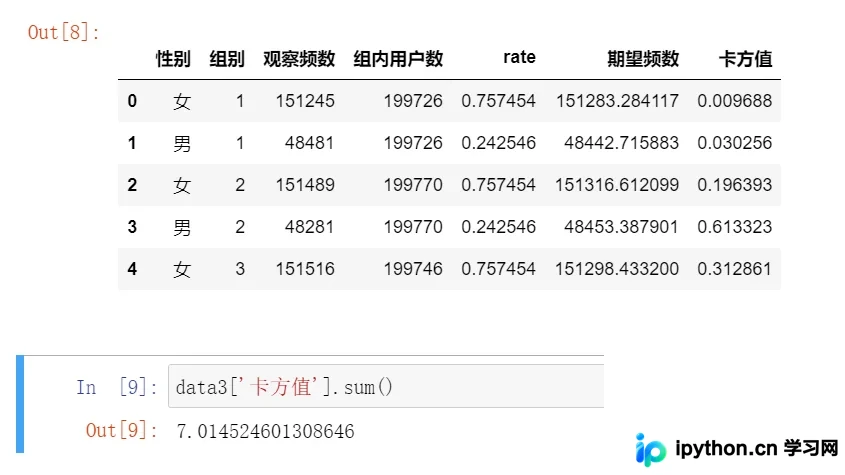
本案例的自由度为(10-1)*(2-1)=9,设定显著性水平为0.05。查阅卡方分布表可知临界值为18.31。由于计算得到的卡方值7.01小于临界值18.31,故不能拒绝原假设,即各组间的性别分布不存在显著性差异。
至此,关于使用Python验证多组数据间显著性差异的内容介绍完毕。如需了解更多相关技术细节,可查阅本站往期文章或继续浏览后续内容,感谢支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















