


Python使用LAC与LTP库提取语句中人名的方法对比

发布时间:2026-10-16 |
3人浏览过
本文介绍如何使用Python的LAC和LTP两个库从文本中提取人名。通过对比两种模式在指定测试语句下的执行耗时与提取结果,分析LAC的高速度与LTP的高准确率差异,为开发者在实际项目中选择合适的命名实体识别工具提供参考。
前言
本文提供一种可直接调用的工具方法,用于从自然语言语句中提取人名信息。
环境依赖
实现该功能需要安装相应的Python库。虽然仅使用其中一个库即可完成任务,但为了进行性能与效果的对比分析,本文准备了两个库供比较。
安装命令如下:
pip install LAC -i https://pypi.douban.com/simple
pip install ltp -i https://pypi.douban.com/simple
代码
以下直接展示核心实现代码。
#!/user/bin/env python
# coding=utf-8
"""
@project : csdn
@author  : 剑客阿良_ALiang
@file   : extract_sentence_name_tool.py
@ide    : PyCharm
@time   : 2022-01-25 11:11:43
"""
from LAC import LAC
from ltp import LTP
import time

lac = LAC(mode="lac")
ltp = LTP()


# 句子提取名字
def extract_name(sentence: str, type='lac'):
    user_name_lis = []
    if type == 'lac':
        _result = lac.run(sentence)
        for _index, _label in enumerate(_result[1]):
            if _label == "PER":
                user_name_lis.append(_result[0][_index])
    elif type == 'ltp':
        _seg, _hidden = ltp.seg([sentence])
        _pos_hidden = ltp.pos(_hidden)
        for _seg_i, _seg_v in enumerate(_seg):
            _hidden_v = _pos_hidden[_seg_i]
            for _h_i, _h_v in enumerate(_hidden_v):
                if _h_v == "nh":
                    user_name_lis.append(_seg_v[_h_i])
    else:
        raise Exception('type not suppose')
    return user_name_lis


if __name__ == '__main__':
    _start_lac = time.time()
    lis1 = extract_name("就因为看了沈腾和贾玲的王牌对王牌节目,所以杨迪肯定偷题了。", 'lac')
    _end_lac = time.time()
    print("LAC: {} <- 耗时[{}]秒".format(lis1, (_end_lac - _start_lac)))

    _start_ltp = time.time()
    lis2 = extract_name("就因为看了沈腾和贾玲的王牌对王牌节目,所以杨迪肯定偷题了。", 'ltp')
    _end_ltp = time.time()
    print("LTP: {} <- 耗时[{}]秒".format(lis2, (_end_ltp - _start_ltp)))
代码说明:
核心函数extract_name接收两个参数:待处理的语句sentence和指定模型类型type。type参数默认为'lac'模式,用户也可显式指定为'ltp'模式。
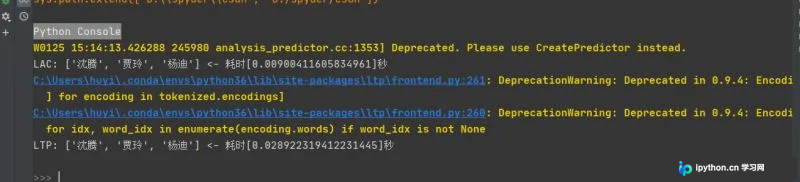
在性能表现上,LAC模型在提取人名时速度较快;相比之下,LTP模型在提取人名的准确率方面表现更优。
验证一下
通过实际运行代码来观察两种模式的执行效率差异。
总结
在实际应用开发中,建议根据具体需求对两个库进行多场景测试。通常情况下,LTP模型在人名提取的准确率上略高于LAC模型。
到此这篇关于Python实现提取语句中的人名的文章就介绍到这了,更多相关Python提取人名内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















