


Python与Selenium实现拼图验证码自动破解详解

本文详细解析利用Python和Selenium破解网站拼图验证码的实现方案。内容涵盖从理解验证码生成原理、制定破解策略到编写自动化脚本的全过程。重点介绍如何通过抓取碎片图片、分析RGB颜色差异确定缺口位置,并利用Selenium控制滑块完成验证。代码示例展示了图像下载、颜色提取、缺口定位及滑块移动的具体实现,适用于需要绕过此类安全机制的自动化测试场景。
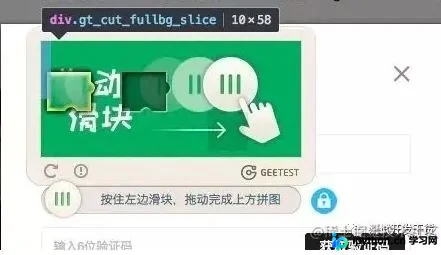
实现思路
当前许多网站采用了拼图验证码机制来增强安全性。
1.首先需要深入理解拼图验证码的具体生成原理。
2.制定详细的破解计划,评估该方案的可行性及预期成功率。
3.基于上述分析编写自动化脚本。
多数网站的拼图验证码直接调用第三方插件,因此针对特定类型的验证码往往有对应的单一解法。
笔者所遇到的这种拼图验证码,其本质是将多个小碎片重新组合成一张完整图片。因此,第一步需要在目标网站上抓取这些分散的小碎片图片,并将其保存到本地存储中。
接下来梳理整体操作流程:
获取所有碎片图片——分析并确定它们的排列顺序逻辑——识别出包含深色背景(即真实缺口位置)的小碎片序号——根据每个碎片的宽度以及该深色碎片相对于基准点的距离计算出最终位移量——最后使用Selenium控制滑块向右移动至计算出的距离处。
核心代码
首先导入运行所需的必要依赖包:
# -*- coding:utf-8 -*-
import colorsys
import urllib,os,uuid,re,time
from PIL import Image
from selenium.webdriver.common.action_chains import ActionChains
from selenium import webdriver
执行抓取操作并将图片保存至本地目录。
def create(locapath,fileName):
  filePath=locapath+'/'+fileName
  if not os.path.exists(filePath):
    file=open(filePath,'a+')
    file.close()
    return filePath
def downloadImg():
  list = openBrowser()
  for i in range(2):
    fileName = str(i) + '_test.jpg'
    urllib.urlretrieve(list[i], create('/Users/zijiawang/Downloads/', fileName))  #下载到本地
  time.sleep(3)
def openBrowser():
  global wzj
  wzj =  webdriver.Firefox()
  wzj.get('https://。。。。')
  image1_url = wzj.find_elements_by_class_name('gt_cut_bg_slice')[0].get_attribute('style')
  image1_url=image1_url[23:-38]
  image2_url = wzj.find_elements_by_class_name('gt_cut_fullbg_slice')[0].get_attribute('style')
  image2_url=image2_url[23:-38]
  return [image1_url,image2_url]
对图片进行分割处理并提取RGB颜色信息。
ef getcolor(image):
  list = [[x,y] for x in range(26) for y in range(2)]
  listt = []
  colors = []
  for i in range(len(list)):
    l = list[i][0]*12+12
    w = list[i][1]*58+58
    listt.append([12*0.25+i/2*12, 58*0.25+((i+10)%2)*58])
    listt.append([12*0.25+i/2*12, 58*0.75+((i+10)%2)*58])
    listt.append([12*0.75+i/2*12, 58*0.25+((i+10)%2)*58])
    listt.append([12*0.75+i/2*12, 58*0.75+((i+10)%2)*58])
  for i in range(len(listt)):
    colors.append(image[listt[i][0],listt[i][1]])
  return colors
通过颜色差异找出构成不同小碎片的序号。
def getDeferent():
  deferent = []
  for i in range(208):
    if abs(color1[i][2] - color2[i][2]) >20:
      print u'B差值: ',color1[i][2]-color2[i][2]
      deferent.append(i)
      # print ([i,abs(color1[i][0] - color2[i][0]),abs(color1[i][1] - color2[i][1]),abs(color1[i][2] - color2[i][2])])
  return deferent
def getUPDOWN():
  deferent = getDeferent()
  xlist = []
  ylist = []
  for i in deferent:
    if (i / 4) % 2 == 0:
      xlist.append(i)
    else:
      ylist.append(i)
  uplist = []
  downlist = []
  for i in xlist:
    uplist.append(i / 4)
  for i in ylist:
    downlist.append(i / 4)
  for i in range(len(uplist)):
    uplist[i] /= 2
  for i in range(len(downlist)):
    downlist[i] /= 2
  func = lambda x, y: x if y in x else x + [y]
  up = reduce(func, [[], ] + uplist)
  func = lambda x, y: x if y in x else x + [y]
  down = reduce(func, [[], ] + downlist)
  return up,down
编写排序算法,用于处理获取到的数据。
def bubble(l):
    for index in range(len(l) - 1, 0 , -1):
        for two_index in range(index):
            if l[two_index] > l[two_index + 1]:
                l[two_index], l[two_index + 1] = l[two_index + 1], l[two_index]
    return l
最后进行解析与拼装,生成完整的验证逻辑代码。
def end():
  orders = getUPDOWN()
  orderx = orders[0]
  ordery = orders[1]
  print 'x:',orderx
  print 'y:',ordery
  orderX = [145, 157, 277, 265, 169, 181, 253, 241, 97, 109, 301, 289, 73, 85, 37, 25, 1, 13, 133, 121, 49, 61, 229,
            217, 193, 205]
  orderY = [157, 145, 265, 277, 181, 169, 241, 253, 109, 97, 289, 301, 85, 73, 25, 37, 13, 1, 121, 133, 61, 49, 217,
            229, 205, 193]
  print u'X:',orderX
  print u'Y:',orderY
  for x in range(26):
    orderX[x] -= 1
    orderX[x] /= 12
  for y in range(26):
    orderY[y] -= 1
    orderY[y] /= 12
  endX = []
  endY = []
  for i in range(len(orderX)):
    for j in range(len(orderx)):
      if orderx[j] == orderX[i]:
        endX.append(i)
        break
  for i in range(len(orderY)):
    for j in range(len(ordery)):
      if ordery[j] == orderY[i]:
        endY.append(i)
        break
  print 'endx:',endX
  print 'endy:',endY
  os.remove('/Users/zijiawang/Downloads/0_test.jpg')
  os.remove('/Users/zijiawang/Downloads/1_test.jpg')
  all = []
  all = endX+endY
  # print 'all:',all
  #系统最多可实验5次
  func = lambda x, y: x if y in x else x + [y]
  all_old = reduce(func, [[], ] + all)
  # print 'all_old:',all_old
  all_end =bubble(all_old)
  print 'all_end:',all_end
  duandata = 1000
  for i in range(1,len(all_end)):
    if all_end[i]-1 in all_end:
      pass
    else:
      duandata = all_end[i]
      print u'断点为:',duandata
  guess =[]
  if duandata != 1000:
    if endX != [] and endY!=[]:
      print u'断点1'
      guess = [duandata,all_end[0]]
    elif endX ==[]:
      print u'断点2'
      guess = [duandata, endY[0]]
    elif endY == []:
      print u'断点3'
      guess = [duandata,  endX[0]]
  else:
      print u'无断点'
      guess = [ all_end[0]]
  end_guess =[]
  print u'猜测的点:',guess
  for i in guess:
    end_guess.append(i * 12 - 38)
    end_guess.append(i * 12 - 28)
    end_guess.append(i * 12 - 20)
    end_guess.append(i * 12 - 17)
    end_guess.append(i * 12 - 15)
  print  u'猜测的位移量: ',end_guess
  return end_guess
主函数入口。
if __name__ == '__main__':
  downloadImg()
  color1 = getcolor(Image.open('/Users/zijiawang/Downloads/0_test.jpg').load())
  color2 = getcolor(Image.open('/Users/zijiawang/Downloads/1_test.jpg').load())
  guess = end()
  for i in guess:
    print i,wzj.title
    try:
      ele = wzj.find_element_by_xpath('//div[@class="gt_slider_knob gt_show"]')
    except:
      ele = wzj.find_element_by_xpath('//div[@class="gt_slider_knob gt_show moving"]')
    ActionChains(wzj).click_and_hold(ele).perform()
    ActionChains(wzj).move_to_element_with_offset(ele, 0,i).perform()
由于各网站的验证码实现大同小异,此处省略具体测试网站名称,以避免对目标站点造成压力。该算法属于高度定制化方案,应用于其他网站时需调整相关参数,且代码注释较为简略。如有不明之处,欢迎留言交流。
以上就是Python结合Selenium破解拼图验证码脚本的详细内容,更多关于Python Selenium处理拼图验证码的资料,请关注本站其他相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















