


Python自动化处理:基于销售排名的等级划分与文件管理

本文详解如何利用Python实现销售数据的自动化等级划分。通过结合os模块进行文件夹管理,使用整除与取模运算精确计算等级数量,并借助Openpyxl库遍历切片数据写入独立工作簿。此外,介绍cn2an库实现阿拉伯数字与中文数字的转换,最终生成规范的等级销售报表。
接下来我们将学习如何实现等级划分功能。为了完成这一任务,需要掌握五个核心知识点,包括os.path.exists()、os.mkdir()、算术运算符//、%以及cn2an.an2cn()。
本功能的核心目标是将【销售总表.xlsx】中的数据依据“销售排名”进行拆分,生成名为【等级x销售表.xlsx】的独立文件,并将其存放于【等级销售表】文件夹内。具体规则为每120人划分为一个等级。
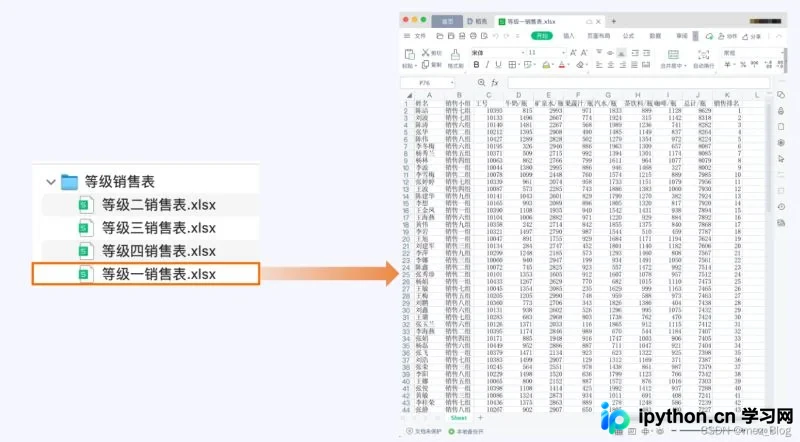
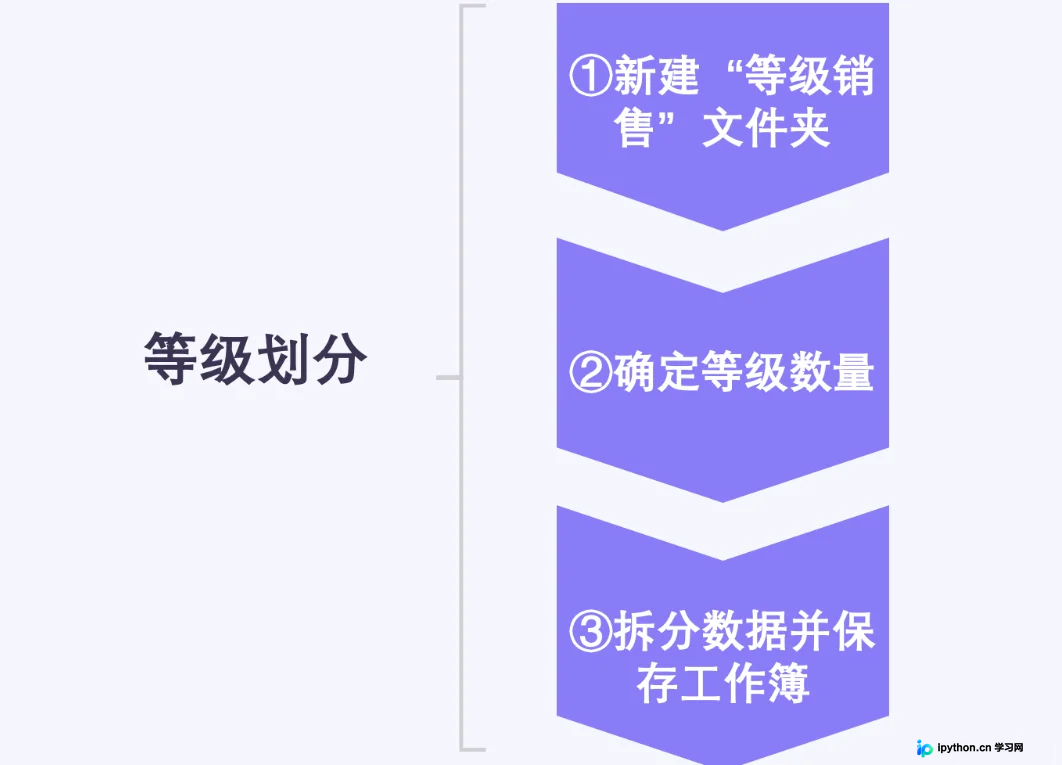
依据项目概述中对等级划分功能的定义,该任务可分解为以下三个主要步骤:
1)创建【等级销售表】文件夹,用于集中存放生成的各等级Excel文件; 2)读取【销售总表.xlsx】,依据“销售排名”列进行排序与拆分,设定每120人为一个等级,并计算所需的总等级数; 3)根据计算出的等级数量,依次创建对应的工作簿,从等级1开始顺序排列,将各等级的人员销售数据及排名写入其中,并保存为【等级x销售表.xlsx】格式,其中x代表具体的等级编号。
等级划分
新建等级销售表文件夹
等级划分后会产生多个新的工作簿文件。若这些文件与原始的【销售总表.xlsx】及【销售数据】文件夹混存于同一目录下,将极大增加文件检索的难度。
为优化文件管理结构,建议在执行拆分操作前预先建立专用文件夹以存放新生成的工作簿。此过程涉及os.path.exists()和os.mkdir()两个关键知识点。
函数用于判断指定路径是否存在。其参数为文件或文件夹的路径字符串,若路径存在则返回True,否则返回False。
import os

# 当前目录下存在test文件夹
print(os.path.exists('./test/'))

# 当前目录下不存在test_new文件夹
print(os.path.exists('./test_new/'))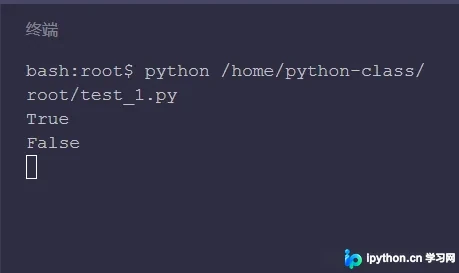
例如,若【test】文件夹已存在,执行该函数将打印True;而若【test_new】文件夹不存在,则打印False。
若需创建新文件夹,则需调用os.mkdir()函数。
“dir”意指目录或路径,因此os.path.exists()用于创建指定的目录。在实际应用中,os.mkdir()常与结合使用,先判断后创建。
延续上述示例,若【test_new】文件夹尚不存在,可通过以下代码逻辑新建该文件夹:
import os

# 判断是否存在文件夹
path = './test_new/'
if not os.path.exists(path):
    # 新建文件夹
    os.mkdir(path)
执行后,可在【static3】目录下观察到新增的【test_new】文件夹。
回到本项目,若需创建“等级销售表”文件夹,相应的代码实现如下:
import os

path = './等级销售表/'

# 判断是否存在文件夹'./等级销售表/',若不存在,则新建'./等级销售表/'
if  not os.path.exists(path):

    os.mkdir(path)
确定等级数量
根据康明的业务需求,每120人划分为一个等级。因此,首要任务是确定总人数,即获取列表total_rows的长度。
计算列表长度可使用len(list)函数。
在获知总人数后,需结合算术运算符//和%来计算具体的等级数量。
运算符//用于执行整除运算,返回除法结果的商,即向下取整。
运算符%用于执行取模运算,返回除法结果的余数。
通过以下代码示例进行验证:
print('商:', 10 // 3)
print('余数:', 10 % 3)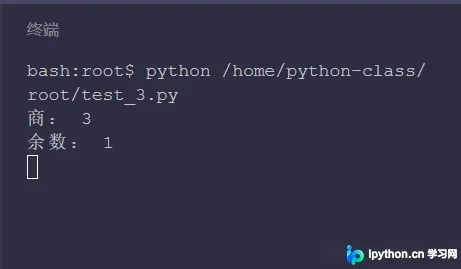
计算10除以3,商为3,余数为1,代码输出结果与此一致。
以下以total_rows列表的前10项数据为例进行拆分演示,设定每4项为一个等级:
cut = 4

# 取出在汇总排序功能中最后得到的total_rows的一小部分数据
total_rows = [['陈洁', '销售七组', 10393, 815, 2993, 971, 1833, 889, 1128, 8629, 1], ['刘波', '销售七组', 10133, 1496, 2667, 774, 1924, 315, 1142, 8318, 2], ['陈涛', '销售六组', 10140, 1481, 2267, 568, 1989, 1236, 741, 8282, 3], ['张华', '销售二组', 10212, 1395, 2908, 490, 1485, 1149, 837, 8264, 4], ['陈伟',
'销售八组', 10427, 1289, 2828, 502, 1279, 1354, 972, 8224, 5], ['李冬梅', '销售六组', 10195, 326, 2946, 886, 1963, 1309, 657, 8087, 6], ['杨秀兰', '销售五组', 10371, 509, 2715, 992, 1394, 1301, 1174, 8085, 7], ['杨林', '销售四组', 10063, 862, 2766, 799, 1611, 964, 1077, 8079, 8], ['李波', '销售一组', 10044, 1380, 2995, 886, 946, 1468, 327, 8002, 9], ['李雪梅', '销售二组', 10078, 1099, 2448, 760, 1574, 1215, 889, 7985, 10]]

# 计算等级数量,先整除,得到至少需要拆分的等级数量nums
nums = len(total_rows) // cut

# 如果余数不为0,则等级数量nums+1,得到最终需要的等级数量
if len(total_rows) % cut != 0:
    nums += 1
print(nums)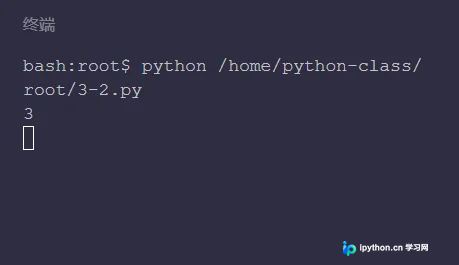
上述代码第8行通过整除运算初步计算等级数量;第11至13行则通过判断余数是否为0来修正等级数量。若余数不为0,说明最后一组人数不足120人但仍需单独成级,故将等级数量加1,从而得到最终所需的等级总数。
拆分数据并保存工作簿
明确等级数量后,即可开始新建工作簿、写入表头,并遍历total_rows列表。关键问题在于如何实现每120人自动拆分为一个等级。
实现这一逻辑的核心在于列表切片操作:
# 拆分为3个等级
nums = 3
# 每4项为一个等级
cut = 4
# 定义列表
list_info = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]
# 通过遍历拆分成了3个列表
for i in range(nums):
    # 限定了每个列表最多有cut项
    print(list_info[i*cut:(i+1)*cut])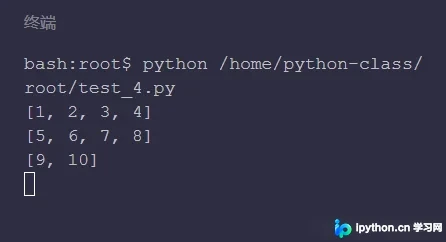
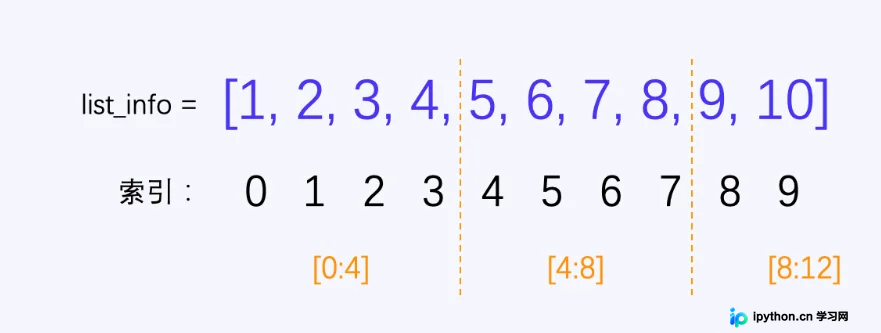
代码第10行中乘以cut变量,旨在以每4项为一个等级进行切片,确保每次切片获取的列表最多包含4项。list_info[i * cut: (i + 1) * cut]分别对应list_info[0:4]、list_info[4:8]和list_info[8:12]。由于list_info仅包含10项,最大索引为list_info[9],因此list_info[8:12]实际上仅提取list_info列表的最后两项,从而构成最后一个等级的数据列表。
回到项目实战,我们再次以前面使用的total_rows列表前10项为例,设定每4项拆分为一个等级,并将结果写入新工作表:
from openpyxl import Workbook
# 每4项拆分为一个等级
cut = 4
# 总共拆成3个等级
nums = 3

# 取出在汇总排序功能中最后得到的total_rows的一小部分数据
total_rows = [['陈洁', '销售七组', 10393, 815, 2993, 971, 1833, 889, 1128, 8629, 1], ['刘波', '销售七组', 10133, 1496, 2667, 774, 1924, 315, 1142, 8318, 2], ['陈涛', '销售六组', 10140, 1481, 2267, 568, 1989, 1236, 741, 8282, 3], ['张华', '销售二组', 10212, 1395, 2908, 490, 1485, 1149, 837, 8264, 4], ['陈伟',
'销售八组', 10427, 1289, 2828, 502, 1279, 1354, 972, 8224, 5], ['李冬梅', '销售六组', 10195, 326, 2946, 886, 1963, 1309, 657, 8087, 6], ['杨秀兰', '销售五组', 10371, 509, 2715, 992, 1394, 1301, 1174, 8085, 7], ['杨林', '销售四组', 10063, 862, 2766, 799, 1611, 964, 1077, 8079, 8], ['李波', '销售一组', 10044, 1380, 2995, 886, 946, 1468, 327, 8002, 9], ['李雪梅', '销售二组', 10078, 1099, 2448, 760, 1574, 1215, 889, 7985, 10]]

# 按等级数量,拆分等级表
for num in range(nums):
    # 新建工作表
    new_wb = Workbook()
    new_sheet = new_wb.active

    # 写入表头
    new_sheet.append(['姓名', '销售小组', '工号', '牛奶/瓶', '矿泉水/瓶', '果蔬汁/瓶', '汽水/瓶', '茶饮料/瓶', '咖啡/瓶', '总计/瓶', '销售排名'])

    # 写入数据
    for row in total_rows[num*cut:(num+1)*cut]:
        new_sheet.append(row)
    # 保存等级表
    new_wb.save('等级{}销售表.xlsx'.format(num + 1))
由于每次提取的是包含4人销售数据的子列表,而每个人的数据本身也是一个独立列表,因此第21行代码切片后得到的实际结果如下所示:
[['陈洁', '销售七组', 10393, 815, 2993, 971, 1833, 889, 1128, 8629, 1], ['刘波', '销售七组', 10133, 1496, 2667, 774, 1924, 315, 1142, 8318, 2], ['陈涛', '销售六组', 10140, 1481, 2267, 568, 1989, 1236, 741, 8282, 3], ['张华', '销售二组', 10212, 1395, 2908, 490, 1485, 1149, 837, 8264, 4]] [['陈伟', '销售八组', 10427, 1289, 2828, 502, 1279, 1354, 972, 8224, 5], ['李冬梅', '销售六组', 10195, 326, 2946, 886, 1963, 1309, 657, 8087, 6], ['杨秀兰', '销售五组', 10371, 509, 2715, 992, 1394, 1301, 1174, 8085, 7], ['杨林', '销售四组', 10063, 862, 2766, 799, 1611, 964, 1077, 8079, 8]] [['李波', '销售一组', 10044, 1380, 2995, 886, 946, 1468, 327, 8002, 9], ['李雪梅', '销售二组', 10078, 1099, 2448, 760, 1574, 1215, 889, 7985, 10]]
嵌套列表直接写入工作表并不合适。因此,在第20至22行增加遍历逻辑,以提取每个人单独的销售数据(即独立的小列表),随后再将其写入新工作表。
最后使用num+1的原因在于,等级编号需从1开始递增,而非从0开始。
回顾康明的需求,在保存为【等级x销售表.xlsx】时,x需使用中文数字而非阿拉伯数字。为此,我们需要引入最后一个新知识点——cn2an.an2cn(),其用法简单直观。
在本地运行前,需通过pip在cmd或终端中安装cn2an模块。
# Windows系统:
pip install cn2an
# Mac系统:
pip3 install cn2an
import cn2an
num1 = 101
num2 = '三百六十九'
# 将num1转成中文数字
num1_new = cn2an.an2cn(num1)
# 讲num2转成阿拉伯数字
num2_new = cn2an.cn2an(num2)
print(num1_new)
print(num2_new)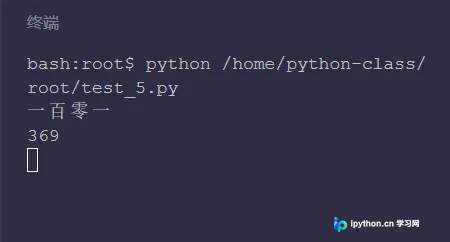
测试结果显示,101可转换为“一百零一”,“三百六十九”可转换为369。因此,在项目代码中,只需在保存文件夹的代码里,将num+1的结果先通过cn2an.an2cn()进行转换,即可实现文件名的中文数字命名。
总结
以上即为功能二所涉及的全部知识点,可通过思维导图进行回顾与总结。
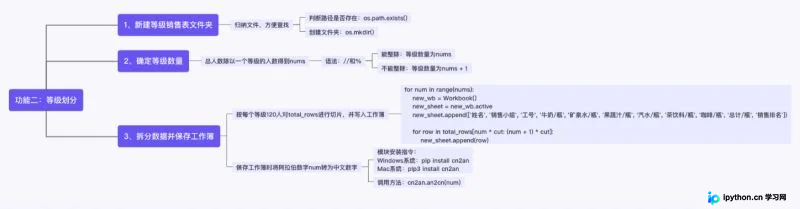
至此,关于使用Python实现等级划分的教程已介绍完毕。如需了解更多Python等级划分相关内容,请搜索本站历史文章或继续浏览后续文章。感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















