


Python实现文件加密器:基于PyQt与自定义算法的本地安全方案

本文介绍如何使用Python和PyQt开发一款本地文件加密工具,旨在防止敏感信息泄露。文章详细解析了自定义加密算法的核心逻辑,包括密钥处理、数据分组交叉及加密流程,并提供了完整的源代码与GitHub下载链接。通过图形界面简化操作,适合对数据安全有需求的开发者参考。
前言
出于隐私保护的考虑,家庭成员对个人电脑中的文件内容关注度较高。为有效防止敏感信息外泄,笔者利用Python编写了一款文件加密工具,以保障个人重要数据的安全性。
下载地址
项目托管于GitHub:https://github.com/13337356453/FileCipher
该仓库提供完整的Python源代码供下载与学习。
效果预览
为提升用户体验,程序采用PyQt构建了图形用户界面。运行后的界面布局直观,便于用户操作。
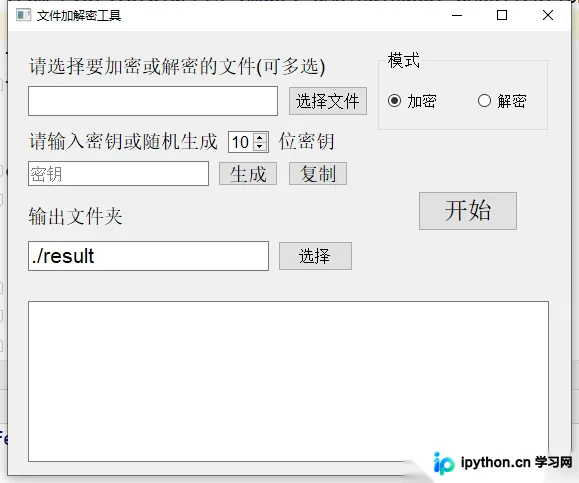
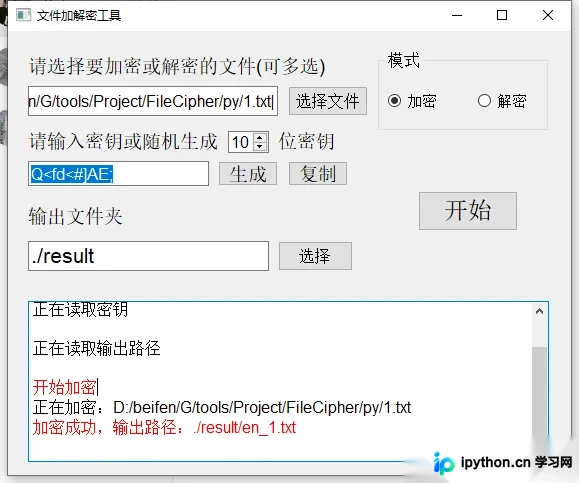
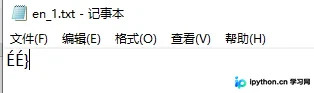
从实际测试来看,该工具的加密效果符合预期,能够有效保护文件内容。
加密算法
相较于图形界面的开发,加密算法的实现是本项目的核心难点。
以下首先展示核心代码,随后对具体实现流程进行详细解析。
class Cipher:
    key = ""

    def __init__(self, key):
        self.key = key

    def setKey(self, key):
        self.key = key

    def getKey(self):
        return self.key

    def parseKey(self, key):
        # 处理密钥
        if key != "":
            o = 0
            for k in key:
                n = 0
                i = str(ord(k))
                for t in i:
                    n += int(t)
                o += n
            # 使密钥范围控制在10-100之间
            while True:
                if o < 10:
                    o = int(o * 2)
                elif o > 100:
                    o = int(o / 2)
                else:
                    return o
        return

    def getOdd(self, max):
        return [i for i in range(1, max + 1) if i % 2 == 1]

    def encrypt(self, data):
        # 加密算法
        if data == "":
            return
        result = ""
        length = len(data)  # 获取数据长度
        a = [ord(x) for x in data]
        # 判断是否为4的倍数
        remainder = length % 4  # 余数
        if remainder != 0:
            b = 4 - remainder
            for c in range(b):
                a.append(0)
        # 第一次分组
        groups = []
        d = len(a) // 2
        e1 = a[:d]
        e2 = a[d:]
        indexs = self.getOdd(d)
        groups.append([e1[i - 1] for i in indexs])
        groups.append([e1[i] for i in indexs])
        groups.append([e2[i - 1] for i in indexs])
        groups.append([e2[i] for i in indexs])
        # 第二次分组
        f1 = groups[0] + groups[3]
        f2 = groups[1] + groups[2]
        # 第一次加密
        keycode1 = self.parseKey(self.getKey())
        g = []
        for h in f1:
            i = h + keycode1
            j = chr(i)
            g.append(i)
            result += j
        # 第二次获取keycode
        k = str(sum(g))
        keycode2 = self.parseKey(k)
        # 第二次加密
        for l in f2:
            m = l + keycode2
            n = chr(m)
            result += n
        # 加密完成
        return result

    def decrypt(self, data):
        # 解密算法
        if data == "":
            return
        result = ""
        # 获取keycode1
        keycode1 = self.parseKey(self.getKey())
        # 第一次解密
        a = len(data) // 2
        b1 = data[:a]
        b2 = data[a:]
        c = [ord(d) for d in b1]
        e = [f - keycode1 for f in c]
        # 获取keycode2
        g = str(sum(c))
        keycode2 = self.parseKey(g)
        # 第二次解密
        h = [ord(i) for i in b2]
        j = [k - keycode2 for k in h]
        # f1对应e , f2对应j
        # 第一次分组
        k = len(e) // 2
        group1 = e[:k]
        group4 = e[k:]
        group2 = j[:k]
        group3 = j[k:]
        # 第二次分组
        datalength = len(group1) + len(group2) + len(group3) + len(group4)  # 数据长度
        l = datalength // 4
        m = []
        for n in range(l):
            m.append(group1[n])
            m.append(group2[n])
        o=[]
        for p in range(l):
            o.append(group3[p])
            o.append(group4[p])
        # 数据拼接
        q=m+o
        for r in q:
            result+=chr(r)
        # 返回结果
        return result
整体处理流程大致如下所示:
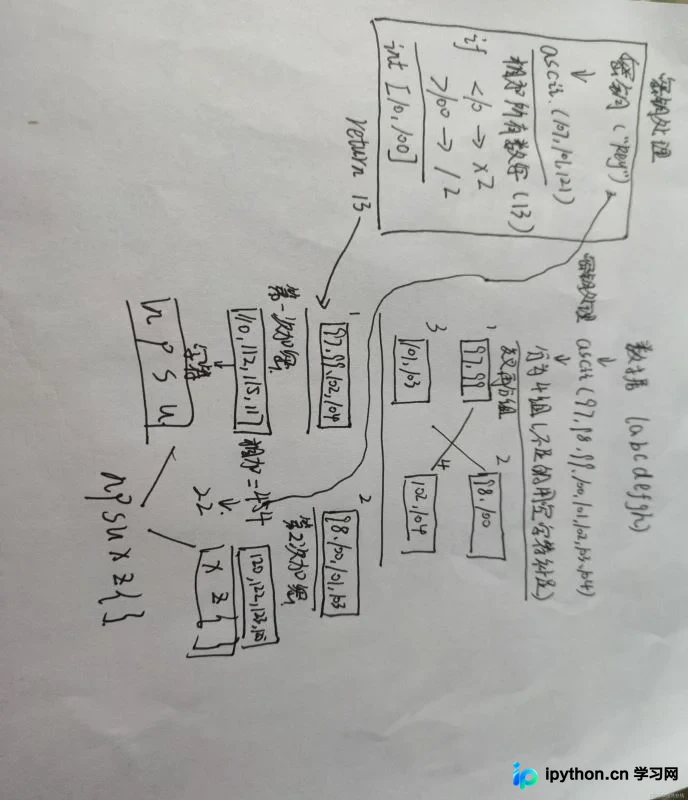
图示为简化后的逻辑框架,可能存在细节偏差,但整体思路一致。
具体处理步骤如下: 1. 密钥预处理:将输入密钥转换为ASCII码,计算所有字符ASCII值之和,并通过乘除运算将该和值限制在10至100的范围内。 2. 数据分组:将待加密数据划分为4组,若某组位数不足,则用00补齐。 3. 交叉重组:对分组后的数据进行交叉重排,生成第二次分组结果。 4. 加密计算:利用处理后的密钥对第一组结果进行加密,得到数据一;将数据一的ASCII值之和再次进行密钥处理,生成密钥二。 5. 二次加密:利用密钥二对第二组结果进行加密,得到数据二。 6. 结果拼接:将数据一与数据二拼接,形成最终的加密数据。
解密过程即为上述加密步骤的逆向操作。
总结
本文介绍了基于Python的文件加密器实现方法,涵盖了从界面设计到核心算法的完整流程。更多Python文件安全相关的技术内容,欢迎查阅本站往期文章或关注后续更新,感谢支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















