


Python实现灰色预测模型(GM(1,1))详解与代码实例

本文详细介绍利用Python实现灰色系统理论中的GM(1,1)预测模型。内容涵盖从原始数据累加生成、微分方程参数求解到未来趋势预测的完整流程,并提供基于NumPy和Matplotlib的完整代码示例,用于处理如GDP等时间序列数据的预测分析。
1.简介
灰色系统理论针对那些既包含已知信息又包含未知或非确定信息的系统进行预测研究。这类系统在特定范围内随时间变化,虽然表现出的现象看似随机且杂乱,但实质上具有有序性和边界性,因此数据集合中潜藏着特定规律。灰色预测正是利用这种潜在规律,构建灰色模型来对系统进行预测。
灰色预测通过鉴别系统因素间发展趋势的相异程度,即进行关联分析,并对原始数据进行生成处理以寻找系统变动的规律。该方法旨在生成具有较强规律性的数据序列,进而建立相应的微分方程模型,从而预测事物未来的发展趋势。其核心是用等时距观测到的反映预测对象特征的一系列数量值构造灰色预测模型,以预测未来某一时刻的特征量,或达到某一特征量所需的时间。
2.算法详解
2.1 生成累加数据
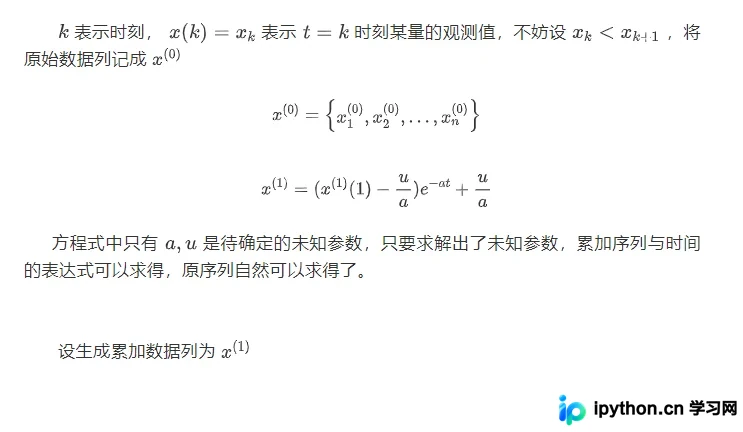
2.2 累加后的数据表达式
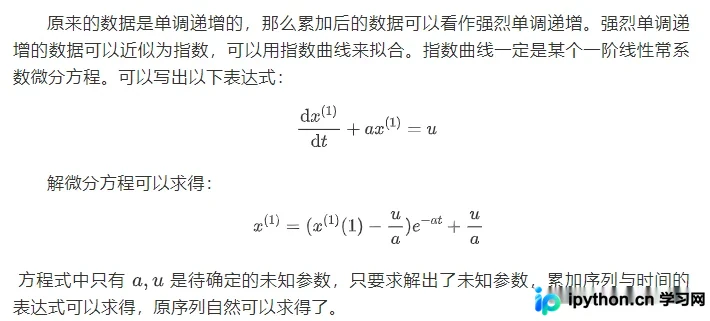
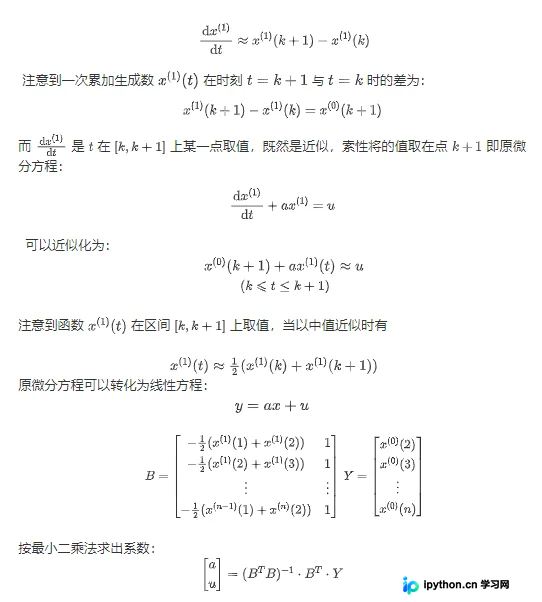
2.3 求解2.2的未知参数
3.实例分析
现有1997—2002年各项指标相关统计数据如下表:
年份 | 第一产业 GDP | 消费 | 第三产业 GDP |
1997 | 72.03 | 241.2 | 1592.74 |
1998 | 73.84 | 241.2 | 1855.36 |
1999 | 74.49 | 244.8 | 2129.60 |
2000 | 76.68 | 250.9 | 2486.86 |
2001 | 78.00 | 250.9 | 2728.94 |
2002 | 79.68 | 252.2 | 3038.90 |
利用灰色预测方法对2003—2009年各项指标数据进行预测。同时,已知实际的预测数据如下:将预测数据与实际数据进行比较分析。
年份 | 第一产业GDP | 居民消费价格指数 | 第三产业GDP |
2003 | 81.21 | 256.5 | 3458.05 |
2004 | 82.84 | 259.4 | 3900.27 |
2005 | 84.5 | 262.4 | 4399.06 |
2006 | 86.19 | 265.3 | 4961.62 |
2007 | 87.92 | 268.3 | 5596.13 |
2008 | 89.69 | 271.4 | 6311.79 |
2009 | 91.49 | 274.5 | 7118.96 |
3.1 导入数据
#原数据
data=np.array([[72.03,241.2,1592.74],[73.84,241.2,1855.36],[74.49,244.8,2129.60],[76.68,250.9,2486.86],[78.00,250.9,2728.94],[79.68,252.2,3038.90]])
#要预测数据的真实值
data_T=np.array([[81.21,256.5,3458.05],[82.84,259.4,3900.27],[84.5,262.4,4399.06],[86.19,265.3,4961.62],[87.92,268.3,5596.1],[89.69,271.4, 6311.79],[91.49,274.5,7118.96]])
返回结果,请自行打印查看
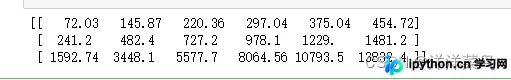
3.2 进行累加数据
#累加数据
data1=np.cumsum(data.T,1) #按列相加
print(data1)
返回:
3.3 求解系数
[m,n]=data1.shape #得到行数和列数 m=3,n=6
#对这三列分别进行预测
X=[i for i in range(1997,2003)]#已知年份数据
X=np.array(X)
X_p=[i for i in range(2003,2010)]#预测年份数据
X_p=np.array(X_p)
X_sta=X[0]-1#最开始参考数据
#求解未知数
for j in range(3):
    B=np.zeros((n-1,2))
    for i in range(n-1):
        B[i,0]=-1/2*(data1[j,i]+data1[j,i+1])
        B[i,1]=1
    Y=data.T[j,1:7]
    a_u=np.dot(np.dot(np.linalg.inv(np.dot(B.T,B)),B.T),Y.T)
    print(a_u)
    #进行数据预测
    a=a_u[0]
    u=a_u[1]
返回:
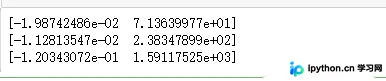
得到3对 a和u
3.4 预测数据及对比
需在3.3的基础上进行预测
[m,n]=data1.shape #得到行数和列数 m=3,n=6
#对这三列分别进行预测
X=[i for i in range(1997,2003)]#已知年份数据
X=np.array(X)
X_p=[i for i in range(2003,2010)]#预测年份数据
X_p=np.array(X_p)
X_sta=X[0]-1#最开始参考数据
#求解未知数
for j in range(3):
    B=np.zeros((n-1,2))
    for i in range(n-1):
        B[i,0]=-1/2*(data1[j,i]+data1[j,i+1])
        B[i,1]=1
    Y=data.T[j,1:7]
    a_u=np.dot(np.dot(np.linalg.inv(np.dot(B.T,B)),B.T),Y.T)
#     print(a_u)
    #进行数据预测
    a=a_u[0]
    u=a_u[1]
    T=[i for i in range(1997,2010)]
    T=np.array(T)
    data_p=(data1[0,j]-u/a)*np.exp(-a*(T-X_sta-1))+u/a #累加数据
#     print(data_p)
    data_p1=data_p
    data_p1[1:len(data_p)]=data_p1[1:len(data_p)]-data_p1[0:len(data_p)-1]
#     print(data_p1)
    title_str=['第一产业GDP预测','居民消费价格指数预测','第三产业GDP预测']
    plt.subplot(221+j)
    data_n=data_p1
    plt.scatter(range(1997,2003),data[:,j])
    plt.plot(range(1997,2003),data_n[X-X_sta])
    plt.scatter(range(2003,2010),data_T[:,j])
    plt. plot(range(2003,2010),data_n[X_p-X_sta-1])
#     plt.title(title_str[j])
    plt.legend(['实际原数据','拟合数据','预测参考数据','预测数据'])
    y_n=data_n[X_p-X_sta-1].T
    y=data_T[:,j]
    wucha=sum(abs(y_n-y)/y)/len(y)
    titlestr1=[title_str[j],'预测相对误差:',wucha]
    plt.title(titlestr1)
    plt.show()
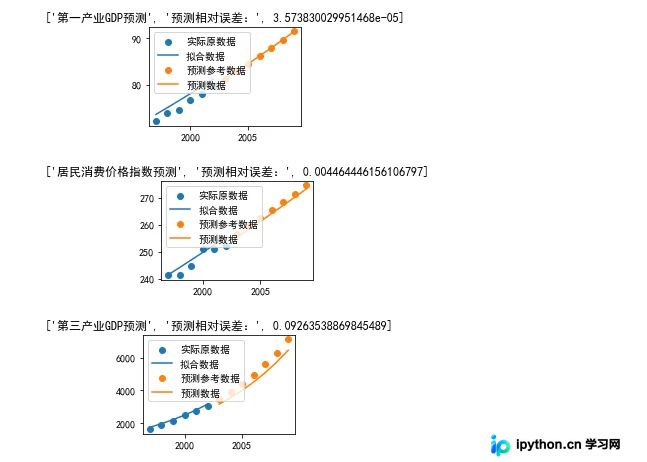
返回:
完整代码
import numpy as np
import matplotlib.pyplot as plt
import math

# 解决图标题中文乱码问题
import matplotlib as mpl
mpl.rcParams['font.sans-serif'] = ['SimHei']  # 指定默认字体
mpl.rcParams['axes.unicode_minus'] = False  # 解决保存图像是负号'-'显示为方块的问题

#原数据
data=np.array([[72.03,241.2,1592.74],[73.84,241.2,1855.36],[74.49,244.8,2129.60],[76.68,250.9,2486.86],[78.00,250.9,2728.94],[79.68,252.2,3038.90]])
#要预测数据的真实值
data_T=np.array([[81.21,256.5,3458.05],[82.84,259.4,3900.27],[84.5,262.4,4399.06],[86.19,265.3,4961.62],[87.92,268.3,5596.1],[89.69,271.4, 6311.79],[91.49,274.5,7118.96]])

#累加数据
data1=np.cumsum(data.T,1)
print(data1)

[m,n]=data1.shape #得到行数和列数 m=3,n=6
#对这三列分别进行预测
X=[i for i in range(1997,2003)]#已知年份数据
X=np.array(X)
X_p=[i for i in range(2003,2010)]#预测年份数据
X_p=np.array(X_p)
X_sta=X[0]-1#最开始参考数据
#求解未知数
for j in range(3):
    B=np.zeros((n-1,2))
    for i in range(n-1):
        B[i,0]=-1/2*(data1[j,i]+data1[j,i+1])
        B[i,1]=1
    Y=data.T[j,1:7]
    a_u=np.dot(np.dot(np.linalg.inv(np.dot(B.T,B)),B.T),Y.T)
#     print(a_u)
    #进行数据预测
    a=a_u[0]
    u=a_u[1]
    T=[i for i in range(1997,2010)]
    T=np.array(T)
    data_p=(data1[0,j]-u/a)*np.exp(-a*(T-X_sta-1))+u/a #累加数据
#     print(data_p)
    data_p1=data_p
    data_p1[1:len(data_p)]=data_p1[1:len(data_p)]-data_p1[0:len(data_p)-1]
#     print(data_p1)
    title_str=['第一产业GDP预测','居民消费价格指数预测','第三产业GDP预测']
    plt.subplot(221+j)
    data_n=data_p1
    plt.scatter(range(1997,2003),data[:,j])
    plt.plot(range(1997,2003),data_n[X-X_sta])
    plt.scatter(range(2003,2010),data_T[:,j])
    plt. plot(range(2003,2010),data_n[X_p-X_sta-1])
#     plt.title(title_str[j])
    plt.legend(['实际原数据','拟合数据','预测参考数据','预测数据'])
    y_n=data_n[X_p-X_sta-1].T
    y=data_T[:,j]
    wucha=sum(abs(y_n-y)/y)/len(y)
    titlestr1=[title_str[j],'预测相对误差:',wucha]
    plt.title(titlestr1)
    plt.show()
到此这篇关于python灰色预测法的具体使用的文章就介绍到这了,更多相关python灰色预测法内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















