


Python基于LightGBM进行时间序列预测:LazyProphet实战解析

本文介绍如何使用Python中的LazyProphet库结合LightGBM进行高效的时间序列预测。通过特征工程如傅里叶基函数和滞后值,该模型在M4数据集上超越了传统树模型基准,且无需复杂调参即可实现快速建模与预测,适合高频大数据场景。
前言
在探讨基于增强树的时间序列预测时,M5竞赛是一个典型例子,其中前十名中有大量方案采用了LightGBM。然而,在单变量时间序列场景中,由于缺乏丰富的外生特征支持,增强树模型的性能往往表现不佳。
值得注意的是,M4竞赛的亚军DID确实使用了增强树,但其角色是作为元模型来集成其他更传统的时间序列方法。在M4公开的代码基准测试中,标准增强树的表现普遍较差,有时甚至不如传统的预测方法。Sktime包及其相关论文[1]对此进行了详尽的评估。
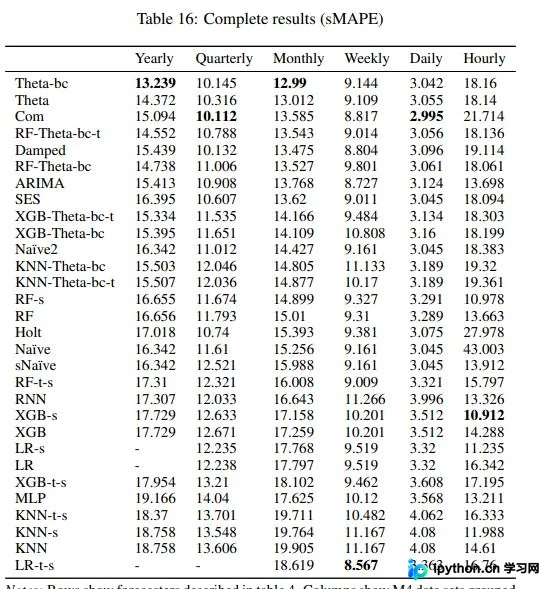
任何名称中包含“XGB”或“RF”的模型均属于基于树的集成方法。在上述评估中,XGBoost在每小时数据集中取得了10.9的最佳结果。然而,这些仅是Sktime框架内的初步尝试,而M4竞赛的获胜者在相同数据集上的得分仅为9.3分。我们需要关注的关键数据点包括:XGB-s在每小时数据集上的10.9分,以及RF-t-s在每周数据集中树模型的最佳结果9.0分。
基于上述观察,我们的目标是开发一个基于LightGBM且适合个人使用的快速时间序列建模程序。该程序旨在绝对超越上述基准数值,同时在处理速度上能够与传统统计方法相媲美。
这听起来颇具挑战性,初期的思路可能是优化树结构本身。但提升树的优化过程极其复杂且耗时,结果也不确定。不过,既然我们处理的是单个数据集,是否可以从特征工程入手?
特征
在考察单变量空间中的其他树模型实现时,通常会看到一些特征工程手段,例如分箱、使用目标的滞后值、简单的计数器、季节性虚拟变量,或许还有傅里叶函数。这些方法对于传统指数平滑等技术非常有效。但我们的目标是将时间元素特征化,并将其表示为表格数据以提供给树模型,此时LazyProphet应运而生。此外,LazyProphet还包含一个额外的特征工程元素:将点“连接”起来。
具体操作很简单:将时间序列的第一个点与中途的另一个点连接成一条线,再将中途的点与最后一个点连接。通过多次重复此过程,并改变作为“折点”(中间节点)的点,这就是所谓的“连接”操作。
下图很好地说明了这一过程。蓝线代表时间序列,其他线条仅表示“连接点”:
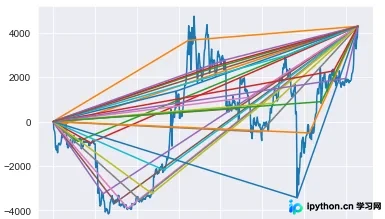
事实证明,这些连接构成了加权分段线性基函数。这样做的一个缺点是这些线的外推可能会出现偏差。为了解决这一问题,引入了一个惩罚从中点到最后点的每条线斜率的“衰减”因子。
在此基础上,加入滞后的目标值和傅里叶基函数,在某些问题上能够达到接近最先进的性能。由于对参数要求极少,因此我们将其命名为“LazyProphet”。
下面我们将查看实际应用的结果。
代码
这里使用的数据集均为开源数据,并发布在M-competitions GitHub上。数据已被分割为训练集和测试集,我们直接使用训练csv进行拟合,而测试csv用于使用SMAPE进行评估。现在导入LazyProphet:
pip install LazyProphet
安装后,开始编码:
import matplotlib.pyplot as plt
import numpy as np
from tqdm import tqdm
import pandas as pd
from LazyProphet import LazyProphet as lp

train_df = pd.read_csv(r'm4-weekly-train.csv')
test_df = pd.read_csv(r'm4-weekly-test.csv')
train_df.index = train_df['V1']
train_df = train_df.drop('V1', axis = 1)
test_df.index = test_df['V1']
test_df = test_df.drop('V1', axis = 1)
导入所有必要的包后,我们将读入每周数据。创建SMAPE函数,它将返回给定预测值和实际值的SMAPE:
def smape(A, F):
  return 100/len(A) * np.sum(2 * np.abs(F - A) / (np.abs(A) +       np.abs(F)))
对于这个实验,我们将取所有时间序列的平均值与其他模型进行比较。为了进行健全性检查,我们还将计算获得的平均SMAPE,以确保我们的操作与比赛中所做的一致。
smapes = []
naive_smape = []
j = tqdm(range(len(train_df)))
for row in j:
  y = train_df.iloc[row, :].dropna()
  y_test = test_df.iloc[row, :].dropna()
  j.set_description(f'{np.mean(smapes)}, {np.mean(naive_smape)}')
  lp_model = LazyProphet(scale=True,
                          seasonal_period=52,
                          n_basis=10,
                          fourier_order=10,
                          ar=list(range(1, 53)),
                          decay=.99,
                          linear_trend=None,
                          decay_average=False)
  fitted = lp_model.fit(y)
  predictions = lp_model.predict(len(y_test)).reshape(-1)
  smapes.append(smape(y_test.values,     pd.Series(predictions).clip(lower=0)))
  naive_smape.append(smape(y_test.values, np.tile(y.iloc[-1], len(y_test))))
print(np.mean(smapes))
print(np.mean(naive_smape))
在查看结果之前,快速介绍一下LazyProphet的参数。
scale:这个很简单,只是是否对数据进行缩放。默认值为True。
seasonal_period:此参数控制季节性的傅立叶基函数,因为这里我们使用的是52的每周频率。
n_basis:此参数控制加权分段线性基函数。这只是要使用的函数数量的整数。
Fourier_order:用于季节性的正弦和余弦对的数量。
ar:要使用的滞后目标变量值。可以获取多个列表1-52。
decay:衰减因子用于惩罚我们的基函数的“右侧”。设置为0.99表示斜率乘以(1-0.99)或0.01。
linear_trend:树的一个主要缺点是它们无法推断出后续数据的范围。为了克服这个问题,有一些针对多项式趋势的现成测试将拟合线性回归以消除趋势。None表示有测试,通过True表示总是去趋势,通过False表示不测试并且不使用线性趋势。
decay_average:在使用衰减率时不是一个有用的参数。这是一个trick但不要使用它。传递True只是平均基函数的所有未来值。这在与elasticnet程序拟合时很有用,但在测试中对LightGBM的用处不大。
下面继续处理数据:
train_df = pd.read_csv(r'm4-hourly-train.csv')
test_df = pd.read_csv(r'm4-hourly-test.csv')
train_df.index = train_df['V1']
train_df = train_df.drop('V1', axis = 1)
test_df.index = test_df['V1']
test_df = test_df.drop('V1', axis = 1)

smapes = []
naive_smape = []
j = tqdm(range(len(train_df)))
for row in j:
  y = train_df.iloc[row, :].dropna()
  y_test = test_df.iloc[row, :].dropna()
  j.set_description(f'{np.mean(smapes)}, {np.mean(naive_smape)}')
  lp_model = LazyProphet(seasonal_period=[24,168],
                          n_basis=10,
                          fourier_order=10,
                          ar=list(range(1, 25)),
                          decay=.99)
  fitted = lp_model.fit(y)
  predictions = lp_model.predict(len(y_test)).reshape(-1)
  smapes.append(smape(y_test.values, pd.Series(predictions).clip(lower=0)))
  naive_smape.append(smape(y_test.values, np.tile(y.iloc[-1], len(y_test))))
print(np.mean(smapes))
print(np.mean(naive_smape))
所以真正需要修改的是seasonal_period和ar参数。将list传递给seasonal_period时,它将为列表中的所有内容构建季节性基函数。ar进行了调整以适应新的主要季节24。
结果
对于上面的Sktime结果,表格如下:
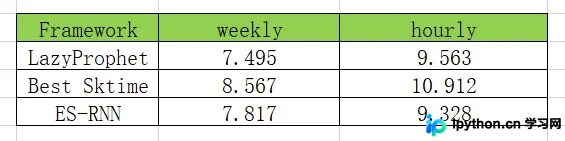
LazyProphet击败了Sktime最好的模型,其中包括几种不同的基于树的方法。在每小时数据集上输给了M4的获胜者,但平均而言总体上优于ES-RNN。这里要意识到的重要一点是,只使用默认参数进行了此操作……
boosting_params = {
                  "objective": "regression",
                  "metric": "rmse",
                  "verbosity": -1,
                  "boosting_type": "gbdt",
                  "seed": 42,
                  'linear_tree': False,
                  'learning_rate': .15,
                  'min_child_samples': 5,
                  'num_leaves': 31,
                  'num_iterations': 50
                  }
可以在创建LazyProphet类时传递你参数的字典,可以针对每个时间序列进行优化,以获得更多收益。
对比一下我们的结果和上面提到的目标:
进行了零参数优化(针对不同的季节性稍作修改)
分别拟合每个时间序列
在我的本地机器上在一分钟内“懒惰地”生成了预测。
在基准测试中击败了所有其他树方法
目前看是非常成功的,但是成功可能无法完全的复制,因为他数据集的数据量要少得多,因此我们的方法往往会显着降低性能。根据测试LazyProphet在高频率和大量数据量上表现的更好,但是LazyProphet还是一个时间序列建模的很好选择,我们不需要花多长时间进行编码就能够测试,这点时间还是很值得。
到此这篇关于Python基于LightGBM进行时间序列预测的文章就介绍到这了,更多相关Python LightGBM时间序列预测内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















