


Python列表推导式与for循环的区别及适用场景

假设你正在处理一份包含上万条用户数据的列表,需要从中清洗出所有有效的电子邮箱并统一转换成小写。初学者通常会先定义一个空列表,再通过 for 循环逐项判断并调用 append() 方法;而在成熟的 Python 代码库中,你更常看到单行的列表推导式完成同样的操作。这两者不仅写法不同,在执行机制、语法设计目标和资源开销上也有本质差别。本文将明确剖析列表推导式与常规 for 循环的核心区别,并通过具体场景与代码给出可落地的选用规则。
一、直观对照:从同一个清洗任务看语法结构
为了直观展现差异,我们设定一个具体的数据转换任务:从一组整数列表中筛选出所有的偶数,并将它们计算平方后存入新列表。
1. 使用常规 for 循环的写法
# 原始输入数据
numbers = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]

# 方案 A:常规 for 循环
even_squares = []
for n in numbers:
    if n % 2 == 0:
        even_squares.append(n ** 2)

# 打印执行结果(示例输出)
print(even_squares)
# 输出: [4, 16, 36, 64, 100]
2. 使用列表推导式的写法
# 方案 B:列表推导式
even_squares = [n ** 2 for n in numbers if n % 2 == 0]

# 打印执行结果(示例输出)
print(even_squares)
# 输出: [4, 16, 36, 64, 100]在这组对照中,for 循环更贴近于命令式思维:读者必须一行行阅读“初始化列表”、“迭代对象”、“条件筛选”以及“方法调用追加元素”。而列表推导式采用的是声明式表达,它将计算目标直接包裹在方括号 [] 内,向阅读者清晰表达意图:“从 numbers 中过滤满足条件的 n,生成 n ** 2 组成的新列表”。
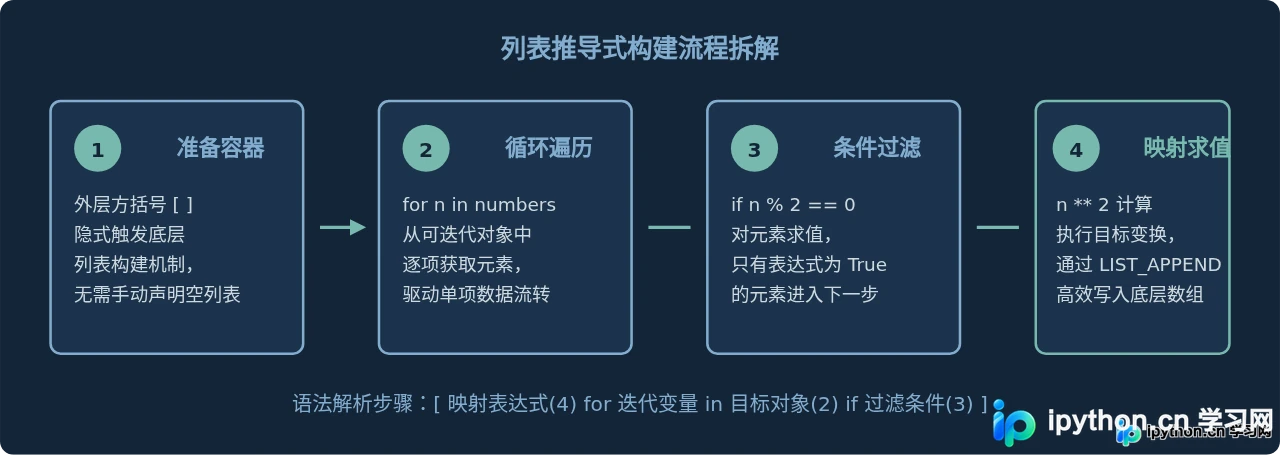
二、深层差异:机制、作用域与执行性能
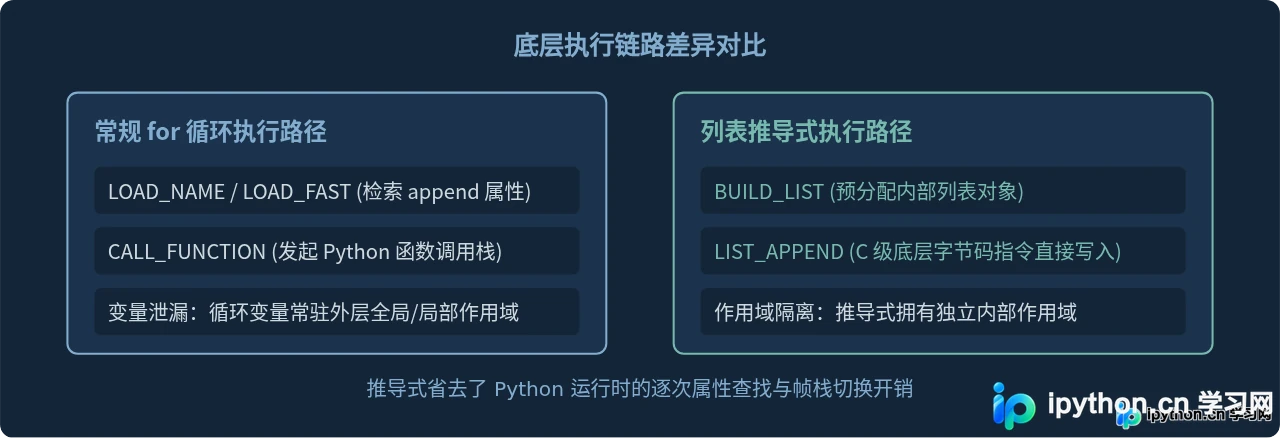
表面上看,推导式只是省去了缩进和 append 调用,但在 CPython 虚拟机的执行底层,两者的运作模型存在明显差异。
1. 字节码与函数调用开销
在常规 for 循环中,每次循环追加元素时,解释器都需要执行两项操作:通过属性查找定位列表的 append 方法,然后触发一次函数调用栈。当循环次数达到几十万次时,这种查找和函数调用开销会明显累积。
列表推导式在编译为字节码时,会使用专用的 LIST_APPEND 指令。该指令在 CPython 运行时是针对 C 数组的快速追加操作,无需在 Python 层面反复查找属性和建立调用栈,因此执行速度通常比普通的 for 循环加 append 快 20% 到 40% 左右。
2. 变量作用域泄漏问题
在常规 for 循环中,循环内部使用的临时变量在循环结束后依然存活于外层命名空间,这可能会意外覆盖同名变量:
# 场景:同名变量覆盖
item = "Original Config"

items = ["a", "b", "c"]
for item in items:
    pass

# 此时 item 已经被修改为列表最后一项
print(item)
# 输出: c
自 Python 3 开始,列表推导式拥有独立的局部作用域(类似内部函数)。在推导式内部定义的迭代变量在表达式结束后会自动销毁,不会污染或覆盖外部作用域中的同名变量。
三、核心区别全景对比
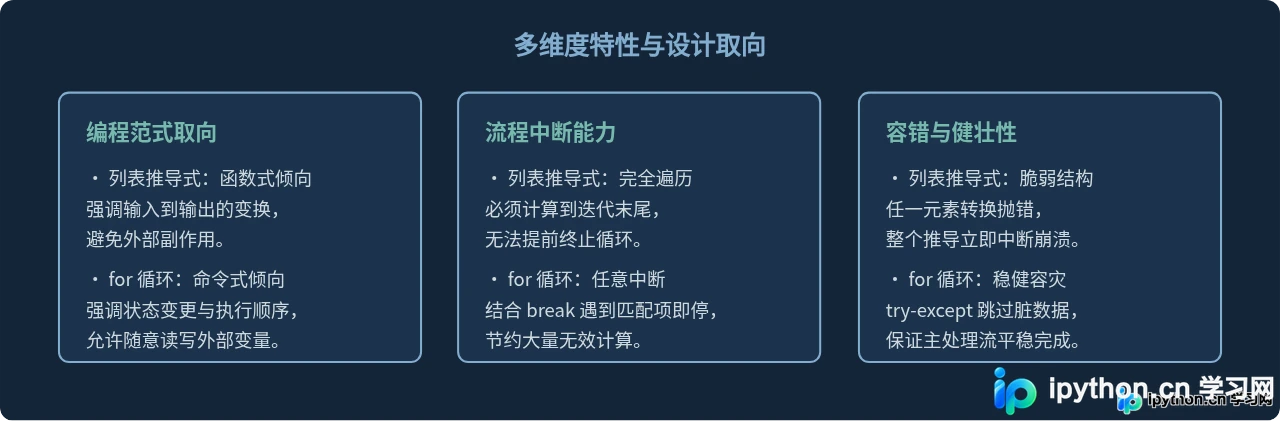
除了执行机制和代码行数,在异常处理、流程中断和返回值等方面,两者的约束也截然不同:
| 对比维度 | 列表推导式 | 常规 for 循环 |
|---|---|---|
| 语法类别 | 表达式(Expression,必然产生返回值) | 控制语句(Statement,执行操作无返回值) |
| 核心目的 | 生产新列表,侧重数据映射与过滤 | 流程驱动,侧重执行一系列命令或副作用 |
| 分支与跳转 | 不支持 break 或 continue |
原生支持 break、continue、else |
| 异常处理 | 无法在推导式内部放置 try...except |
可在循环体内细粒度捕获处理异常 |
| 内存占用 | 立即在内存中构建完整的列表对象 | 若配合 yield,可实现恒定内存的流式处理 |
四、具体适用场景与代码选型
1. 适用列表推导式的场景
当任务的核心目标是以纯粹的数据转换产生新列表,且逻辑较为简单时,推导式是最佳选择。
- 一维列表的简单映射与过滤:例如字符串清洗、类型转换、数学简单算术。
- 字典或键值对提取:例如从接口返回的对象列表中抽取某一特定字段。
- 浅层二维矩阵展平:将简单的嵌套列表展开为单层列表。
# 典型场景:从字典列表中快速提取字段并清洗
users = [
    {"name": "Alice", "active": True},
    {"name": "Bob", "active": False},
    {"name": "Charlie", "active": True}
]

# 一行表达过滤与字段提取
active_names = [u["name"] for u in users if u["active"]]
print(active_names)
# 输出: ['Alice', 'Charlie']
2. 适用 for 循环的场景
若你的任务属于以下任意一种情况,强行写成列表推导式会严重破坏代码可读性,甚至引发隐蔽的性能或逻辑 Bug:
- 包含副作用的操作:如写磁盘文件、发送网络请求、调用日志打印或修改全局数据库。推导式的目的是“生成结果”,绝不应将推导式当成执行
[print(x) for x in data]的循环工具。 - 需要异常保护的代码:数据源中含有不可控的脏数据,必须对单项数据进行
try...except容错。 - 包含复杂分支控制:需要使用
break提前退出的查找任务,或存在多层嵌套的复杂业务逻辑。
# 典型场景:包含网络请求、容灾保护与中断条件(严禁使用推导式)
urls = ["https://api.example.com/item/1", "https://invalid-url", "https://api.example.com/item/2"]
valid_results = []

for url in urls:
    try:
        # 假设这里是网络调用
        if "invalid" in url:
            raise ValueError("地址不合法")
        valid_results.append(f"Data from {url}")
    except ValueError as e:
        # 单项异常不影响后续流程,记录日志继续
        print(f"跳过故障节点: {url}")
        continue

    # 当收集满 1 个结果时快速终止
    if len(valid_results) >= 1:
        print("达到需求上限,提前结束任务")
        break
五、工程落地的决策路径
在编写日常代码或进行代码审查时,无需凭直觉犹豫。你可以通过下面这套固定的四步条件过滤树做出明确决断:
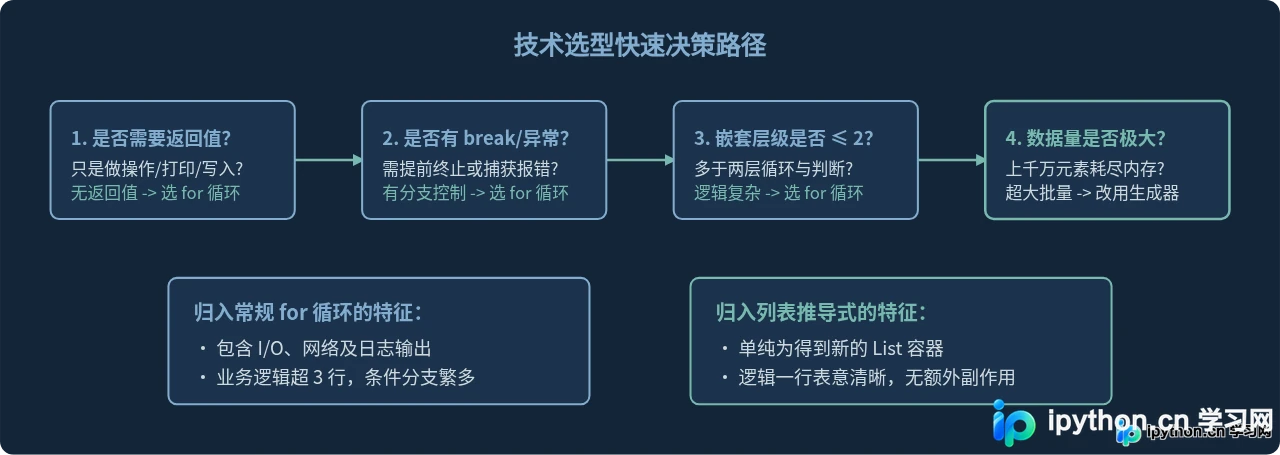
for / if 子句时,请主动将它重构回标准的 for 循环结构。推导式是为了提高代码表达密度,而非展示语法复杂度。
总结来说,列表推导式与 for 循环并非简单的互相替代关系。当你需要以极简清晰的语法直接变换出新数据时,优先使用列表推导式,它兼具性能优势与代码简洁度;而当你需要掌控执行流程、处理异常或产生副作用时,结构完整、扩展性强的常规 for 循环才是最稳健的工具。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















