


Python实现提取PDF简历信息并存入Excel

发布时间:2026-10-15 |
5人浏览过
本文分享一个利用Python从PDF简历中提取关键信息并自动写入Excel的完整案例。通过pdfplumber读取PDF文字,结合python-docx处理Word中间文件,最终使用xlwings将结构化数据写入Excel模板。针对非标准格式简历,文中提供了字符调配与清洗建议,旨在解决HR部门批量处理求职资料时的数据录入难题。
介绍
本文分享一个实际工作中的数据处理案例。
接到人力资源部同事的需求,需要将求职者投递的PDF格式简历中的关键信息提取出来,并汇总保存到Excel表格中。
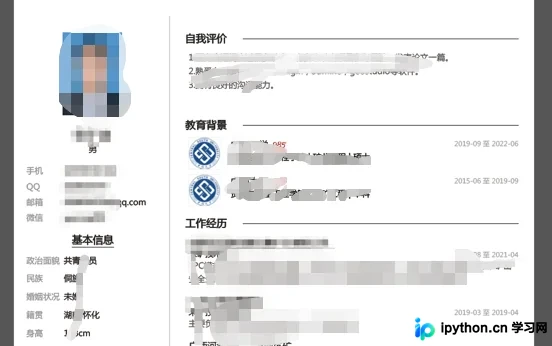
背景说明:这些PDF简历由求职者自行编制,格式不统一,导致数据采集工作存在一定难度。
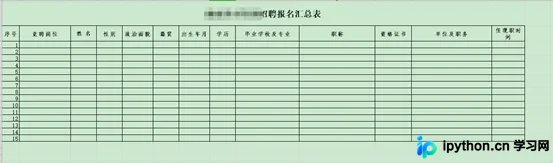
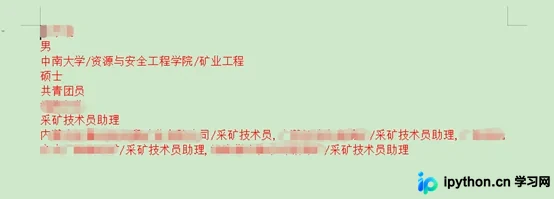
解决思路:首先从PDF文档中抓取文字内容并保存为Word文档,随后从Word文档中读取文字信息,最后将其写入Excel文件中。
1. 将PDF文档中的文字读取到word中
import pdfplumber
from docx import Document

with pdfplumber.open('1_5的简历1632532336.pdf') as rpdf:
    first_page = rpdf.pages[0]
    print(first_page.extract_text())

doc = Document()
rpdfword = first_page.extract_text()

pages = doc.add_paragraph(rpdfword)

doc.save('测试2.docx')
处理结果如下:
2. 将word中读到的文字输入到excel中
#导入所需库
from docx import Document
import xlwings as xw

#写数据
def excel_write(a,path,sheetname,write_cols,write_rows):
    app=xw.App(visible=False,add_book=False)
    app.display_alerts=False
    app.screen_updating=False
    wb=app.books.open(path)
    sht=wb.sheets[sheetname]
    weizhi = []
    try:
        i = 0
        while i!=len(write_cols):
            j = 0
            while j!=len(write_rows):
                weizhi.append(write_cols[i]+str(write_rows[j]))
                j+=1
            i+=1
        k=0
        while k!=len(a):
            sht.range(weizhi[k]).value=a[k].text
            print(weizhi[k])
            k+=1
    finally:
        wb.save()
        wb.close()
        app.kill()

if __name__ == "__main__":
    #打开word文档
    document = Document(u"测试2.docx")

    #获取所有段落
    all_paragraphs = document.paragraphs
    print(len(all_paragraphs))


    excel_path =r'报名人员信息统计表(模板).xls'
    SheetName = r'Sheet1'

    wcols = ['c','d','i','h','e','f','j','L']
    #新读取一个简历要换一行
    wrow = [3]
    excel_write(all_paragraphs,excel_path,SheetName,wcols,wrow)
处理结果如下:
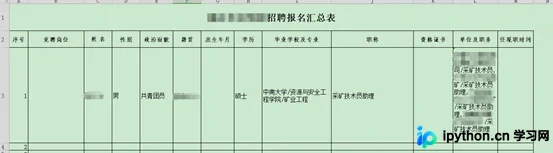
在读取Word文档内容时,需注意对关键信息的字符进行适当调配,如有必要,可删除非关键信息以优化数据质量。
关于Python实现提取PDF简历信息并存入Excel的介绍到此结束,更多相关Python提取PDF信息内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















