


Python使用PyPDF2为PDF批量添加水印及编码错误解决

本文介绍如何使用Python的PyPDF2库为PDF文件批量添加水印,并详细解决运行过程中常见的UnicodeEncodeError编码异常。通过修改PyPDF2源码中的generic.py和utils.py文件,实现中文字符的正确处理,确保水印添加功能稳定运行。
准备用于添加的水印模板文件。
可以使用WPS软件来创建该水印模板。
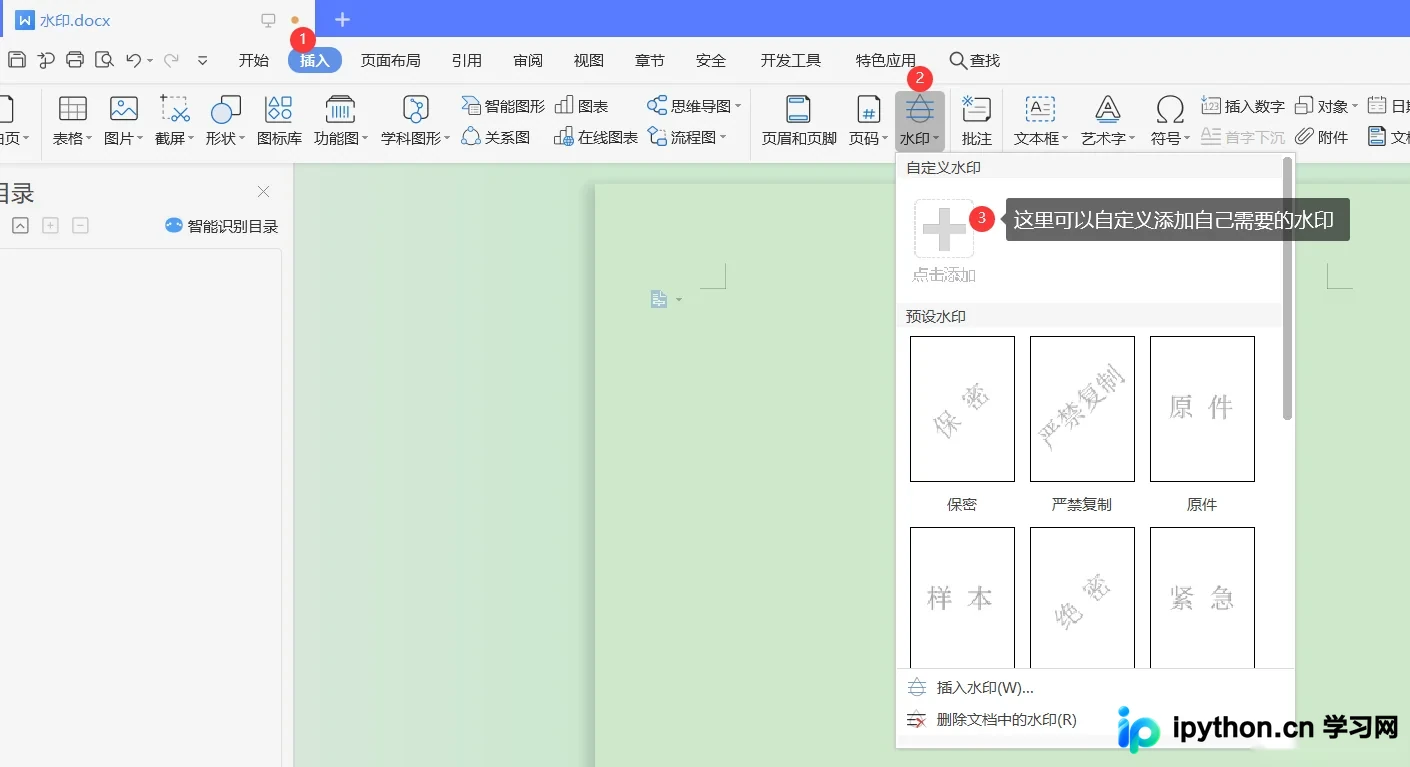
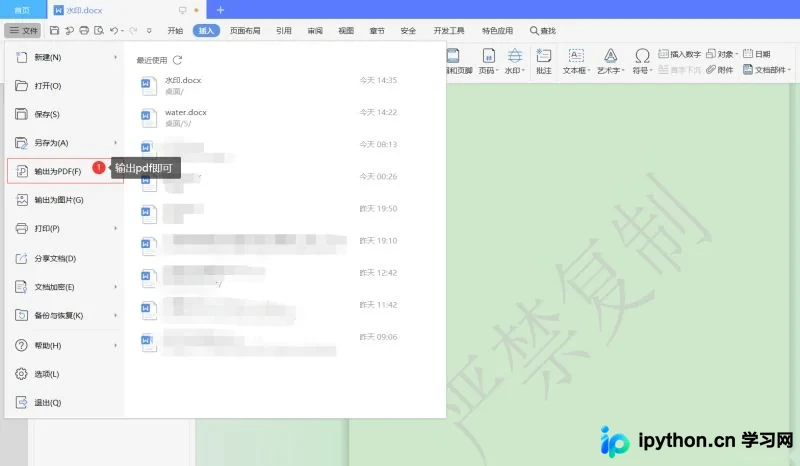
将创建好的模板输出为PDF格式。
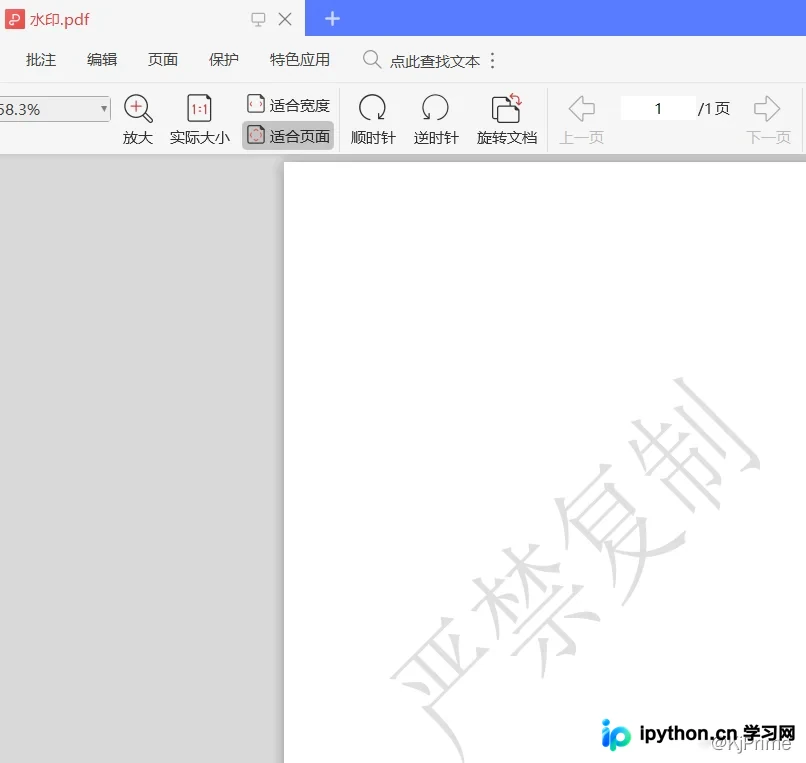
最终生成的包含水印的PDF文件。
具体实现流程如下。
首先需要安装必要的依赖库。
pip install PyPDF2
核心实现代码。
import os
from PyPDF2 import PdfFileReader as pr
from PyPDF2 import PdfFileWriter as pw


def write_watermark(watermark_pdf_path: str, target_pdf_path: str):
    result_pdf = pw()
    pdf_file_name = os.path.basename(target_pdf_path)
    f_target = open(target_pdf_path, 'rb')
    f_watermark = open(watermark_pdf_path, 'rb')
    target_pdf = pr(f_target)
    watermark_page = pr(f_watermark).getPage(0)
    for page in range(target_pdf.getNumPages()):
        try: # 这一段try except是一个让我超级麻烦的bug,让我解决了一天。
            target_pdf.getPage(page).mergePage(watermark_page)
            result_pdf.addPage(target_pdf.getPage(page))
        except Exception as e:
            result_pdf.addPage(watermark_page)
    if not os.path.exists("output"):
        os.makedirs("output")
    result_pdf.write(open("output/已添加水印_" + pdf_file_name, 'wb'))
    f_target.close()
    f_watermark.close()


def folder_pdf_files(folder: str) -> list[str]:  # 一个文件夹里面有多少pdf文件
    file_list = []
    for a, b, c in os.walk(folder):
        if b == []:
            for filename in c:
                if filename[-3:].lower() == 'pdf':
                    file_path = os.path.join(a, filename)
                    file_list.append(file_path)
    print(folder, ": 有", len(file_list), "个pdf文件")
    return file_list


def group_write_watermark(path_array: list[str], watermark_pdf_path: str):  # 一组pdf文件添加水印
    for pdf_path in path_array:
        print(pdf_path, "添加水印中...")
        write_watermark(watermark_pdf_path, pdf_path)
    print("完成")


if __name__ == '__main__':
    watermark_pdf_path = "水印文件.pdf"
    folder_pdf = "目录"  # 需要添加水印的pdf的目录
    pdf_list = folder_pdf_files(folder_pdf)
    group_write_watermark(pdf_list, watermark_pdf_path)
在运行过程中可能遇到的问题。
UnicodeEncodeError: ‘latin-1’ codec can’t encode characters in position 8-9: ordinal not in range(256)
若遇到上述错误,可参考以下解决方案。
使用pypdf2时出现的编码问题。
具体的报错信息。
‘latin-1’ codec can’t encode characters in position 8-11: ordinal not in range(256)
这种情况通常是由中文字符编码冲突引起的。
以下是使用pypdf2复制PDF时触发的报错详情。
//报错信息
<ipython-input-1-4f7e1b354328> in <module>()
     14      output.addPage(p)
     15 with open('D:\\Program Files\\2.pdf', 'wb') as f:
---> 16     output.write(f)

D:\Program Files (x86)\anaconda\lib\site-packages\PyPDF2\pdf.py in write(self, stream)
    499                 md5_hash = md5(key).digest()
    500                 key = md5_hash[:min(16, len(self._encrypt_key) + 5)]
--> 501             obj.writeToStream(stream, key)
    502             stream.write(b_("\nendobj\n"))
    503

D:\Program Files (x86)\anaconda\lib\site-packages\PyPDF2\generic.py in writeToStream(self, stream, encryption_key)
    547             key.writeToStream(stream, encryption_key)
    548             stream.write(b_(" "))
--> 549             value.writeToStream(stream, encryption_key)
    550             stream.write(b_("\n"))
    551         stream.write(b_(">>"))

D:\Program Files (x86)\anaconda\lib\site-packages\PyPDF2\generic.py in writeToStream(self, stream, encryption_key)
    470
    471     def writeToStream(self, stream, encryption_key):
--> 472         stream.write(b_(self))
    473
    474     def readFromStream(stream, pdf):

D:\Program Files (x86)\anaconda\lib\site-packages\PyPDF2\utils.py in b_(s)
    236             return s
    237         else:
--> 238             r = s.encode('latin-1')
    239             if len(s) < 2:
    240                 bc[s] = r

UnicodeEncodeError: 'latin-1' codec can't encode characters in position 8-11: ordinal not in range(256)
针对该问题的解决方法。
第一步,修改pypdf2包中的generic.py文件。
若使用Anaconda环境,该文件路径通常为anaconda\Lib\site-packages\PyPDF2\generic.py。
定位到generic.py文件第488行的原始代码。
try:
   return NameObject(name.decode('utf-8'))
   except (UnicodeEncodeError, UnicodeDecodeError) as e:
   # Name objects should represent irregular characters
   # with a '#' followed by the symbol's hex number
   if not pdf.strict:
      warnings.warn("Illegal character in Name Object", utils.PdfReadWarning)
      return NameObject(name)
   else:
      raise utils.PdfReadError("Illegal character in Name Object")
将其修改为指定代码。
try:
     return NameObject(name.decode('utf-8'))
 except (UnicodeEncodeError, UnicodeDecodeError) as e:
     try:
         return NameObject(name.decode('gbk'))
     except (UnicodeEncodeError, UnicodeDecodeError) as e:
         # Name objects should represent irregular characters
         # with a '#' followed by the symbol's hex number
         if not pdf.strict:
             warnings.warn("Illegal character in Name Object", utils.PdfReadWarning)
             return NameObject(name)
         else:
             raise utils.PdfReadError("Illegal character in Name Object")
第二步,修改pypdf2包中的utils.py文件。
定位到utils.py第238行的原始代码。
 r = s.encode('latin-1')
 if len(s) < 2:
   		bc[s] = r
 return r
将其修改为指定代码。
try:
    r = s.encode('latin-1')
    if len(s) < 2:
        bc[s] = r
    return r
except Exception as e:
    print(s)
    r = s.encode('utf-8')
    if len(s) < 2:
        bc[s] = r
    return r
完成上述修改后,问题即可解决。
开发过程中的心得与总结。
该代码的创新之处在于支持遍历文件夹并批量添加水印。
虽然基础功能常规,但write_watermark函数中的try-except语句最具价值,它解决了一个导致PDF生成空白页且网上无解的Bug,耗时一天才摸索出来。
目前代码对图片型PDF的水印效果不佳,因图片PDF页面尺寸通常大于普通文字PDF,导致水印位置难以精准控制。后续考虑在创建水印PDF时预先放大页面尺寸以适配。
至此,关于Python实现PDF添加水印功能的介绍完毕,更多相关Python PDF水印内容可搜索本站历史文章或继续浏览后续文章,感谢支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















