


Python递归遍历子文件夹批量将Markdown转换为Word

发布时间:2026-10-15 |
5人浏览过
本文介绍如何使用Python脚本递归遍历当前目录及所有子文件夹,提取其中的Markdown文档,并利用Pandoc工具批量转换为Word格式。代码提供了两种输出策略:一是将转换后的文档集中保存在Python程序所在的主文件夹中,二是保持原有目录结构。通过glob和pathlib模块实现文件路径的自动识别与处理,解决了传统工具仅支持单文件夹转换的限制。
前言
前言
需求背景与改进思路
近期有需求需要批量将Markdown格式的文档转换为Word格式。虽然网上存在多种解决方案,但大多数方法仅支持处理同一文件夹内的文件。由于个人保存的Markdown文档分散在不同的子文件夹中,现有工具无法满足需求,因此对方法进行了改进,实现了以下功能。
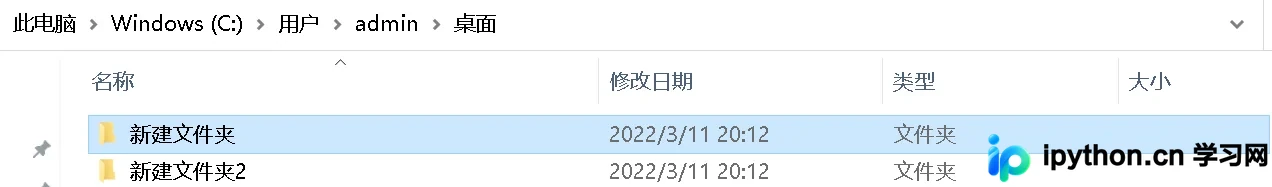
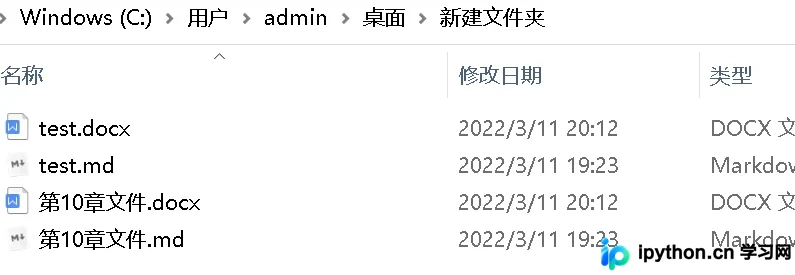
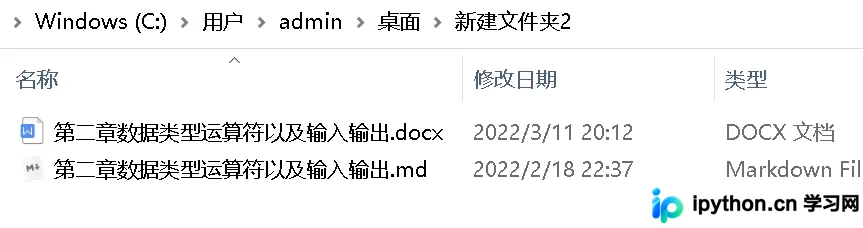
方案一:集中输出至根目录
from glob import glob
from pathlib import Path
import os

dirs = [ d for d in glob("./**/")]

# 用在本文件夹内则调整为下列代码
# dirs = [ d for d in glob("./")]

# 提取所有的md文档路径
al1_file_pathes=[]
for dir in dirs:
    file_list=Path(dir).glob("*.md")
    for file in file_list:
        al1_file_pathes.append(".\\"+str(file))
        print(file)


# 批量转化所有的md文档为docx
for md_path in al1_file_pathes:
    doc_path=md_path.replace(".md",".docx")
    command_new="pandoc -s "+md_path+" -o "+doc_path
    print(command_new)
    try:
        res=os.popen(command_new).readlines()
        if len(res)==0:
            print(md_path,"已经转化为",doc_path_2)
    except Exception as e:
        print(e)
集中输出模式的配置说明
若希望将转换生成的Word文档统一集中保存到Python程序所在的根文件夹内。
具体实现代码如下:
方案二:保持原有目录结构
from glob import glob
from pathlib import Path
import os

dirs = [d for d in glob("./**/")]

# 用在本文件夹内则调整为下列代码
# dirs = [ d for d in glob("./")]

# 提取所有的md文档路径
for dir in dirs:
    file_list = Path(dir).glob("*.md")
    for file in file_list:
        md_path = ".\\" + str(file)
        doc_path_1 = os.path.split(file)[1].replace(".md", ".docx")
        command_new_1 = "pandoc -s "+md_path+" -o "+doc_path_1
        try:
            res=os.popen(command_new_1).readlines()
            if len(res)==0:
                print(md_path,"已经转化为",doc_path_1)
        except Exception as e:
            print(e)
总结
至此,关于利用Python针对子文件夹中的Markdown文档实现批量转换为Word的文章介绍完毕。如需了解更多Python批量处理Markdown相关技巧,可搜索本站往期文章或继续浏览后续内容,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















