


Python 手动实现 MapReduce 模型进行销量统计

发布时间:2026-10-15 |
3人浏览过
本文介绍如何使用 Python 手动实现 MapReduce 编程模型来统计商品销量。通过生成模拟订单数据,编写 Mapper 将商品映射为键值对,再使用 Reducer 进行归约统计,完整展示了从数据生成到结果输出的全过程,帮助理解 MapReduce 的核心思想。
MapReduce 是一种专为处理大规模数据集(通常超过 1TB)而设计的并行运算编程模型。其核心概念源自函数式编程语言中的“Map(映射)”和“Reduce(归约)”,并借鉴了矢量编程语言的某些特性。该模型使得开发者无需具备分布式并行编程的专业知识,即可将程序部署在分布式系统上运行。当前的软件实现通常要求定义一个 Map 函数,用于将一组键值对转换为一组新的键值对;同时定义并发的 Reduce 函数,以确保所有映射结果中共享相同键组的数据能够被正确处理。
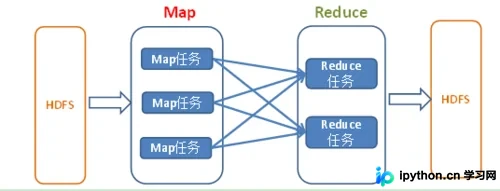
接下来,我们将通过手动编码实现 MapReduce 流程,以统计销售数量为例进行模拟演示。
首先,打开 Python3 在线编程环境:
http://www.dooccn.com/python3/
1、生成模拟数据
#!/usr/bin/python
# -*- coding: utf-8 -*-
import random
# 模拟商品
stocks = ["HUAWEI Mate40","Apple iphone13","Apple MacBook Pro 14","ThinkBook 14p","RedmiBook Pro14","飞鹤星飞帆幼儿奶粉","爱他美 幼儿奶粉","李宁运动男卫裤","小米踏步机椭圆机","欧莱雅面膜","御泥坊面膜","欧莱雅男士套装","金六福白酒","牛栏山42度","茅台飞天"]
# 销售订单
sales_list = list()
# 生成100个买家订单,每个订单三个商品
for i in range(100):
    sstocks = list()
    for j in range(3):
        sstocks.append(stocks[random.randint(0,14)])
    a = "买家" + str(i+1) + ":" + ",".join(sstocks)
    print(a)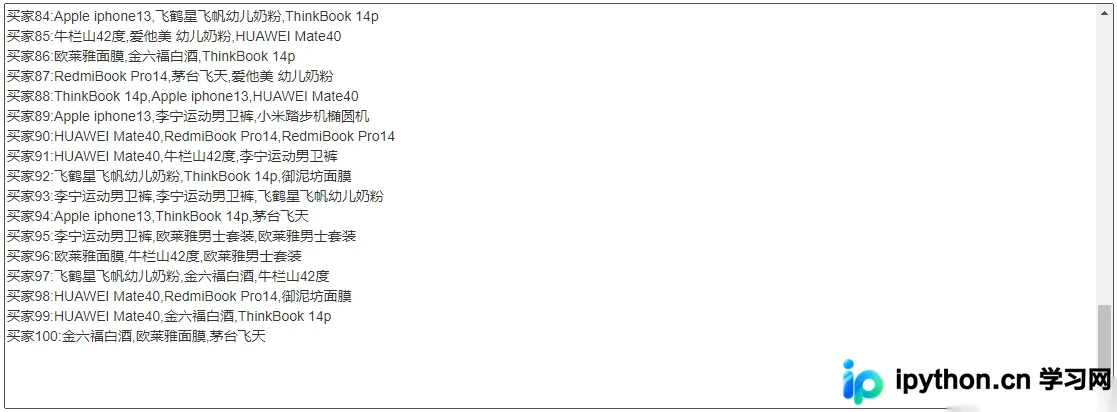
2、mapper 实现
将第一步生成的数据作为第二步 Mapper 处理的输入。
#!/usr/bin/python
# -*- coding: utf-8 -*-
import sys
#从控制台中读取数据,循环发送每行数据
for line in sys.stdin:
    #对订单进行拆分
    orders = line.strip().split(":")
    if len(orders) == 2:
        #对订单中的商品进行拆分
        stocks = orders[1].split(",")
        for stock in stocks:
            #将每一个商品作为key,value进行输出
            print('%s,%s' % (stock,1))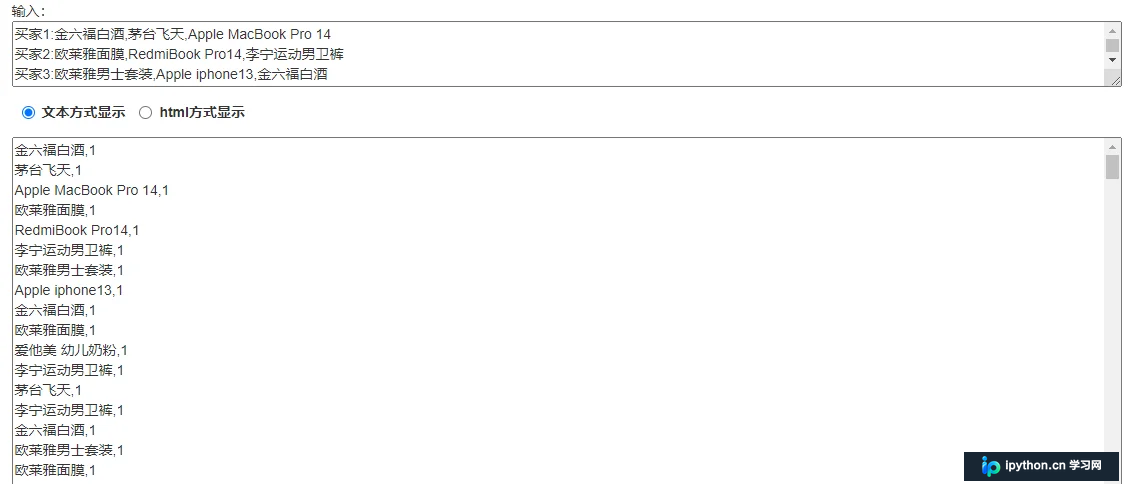
3、reducer 实现
将第二步 Mapper 输出的结果作为第三步 Reducer 处理的输入。
#!/usr/bin/python
# -*- coding: utf-8 -*-
import sys
# 创建一个空的字典用来每一个商品的销售数据
stock_dict = dict()
for line in sys.stdin:
    if len(line.strip()) >= 1:
        # 拆分每一行的商品,销量
        stock, sales = line.split(',')
        # 判断当前商品是否在字典中有存放
        if stock in stock_dict:
            # 如果有,把字典中的商品和销量取出来,追加当前销量再放入
            stock_dict[stock] = stock_dict[stock] + int(sales)
        else:
            # 如果没有,直接把商品和销量数据放入字典中
            stock_dict[stock] = int(sales)
# 遍历字典列表,获取每一个商品的销量
for stock, sales in stock_dict.items():
    print('%s\t%s' % (stock, sales))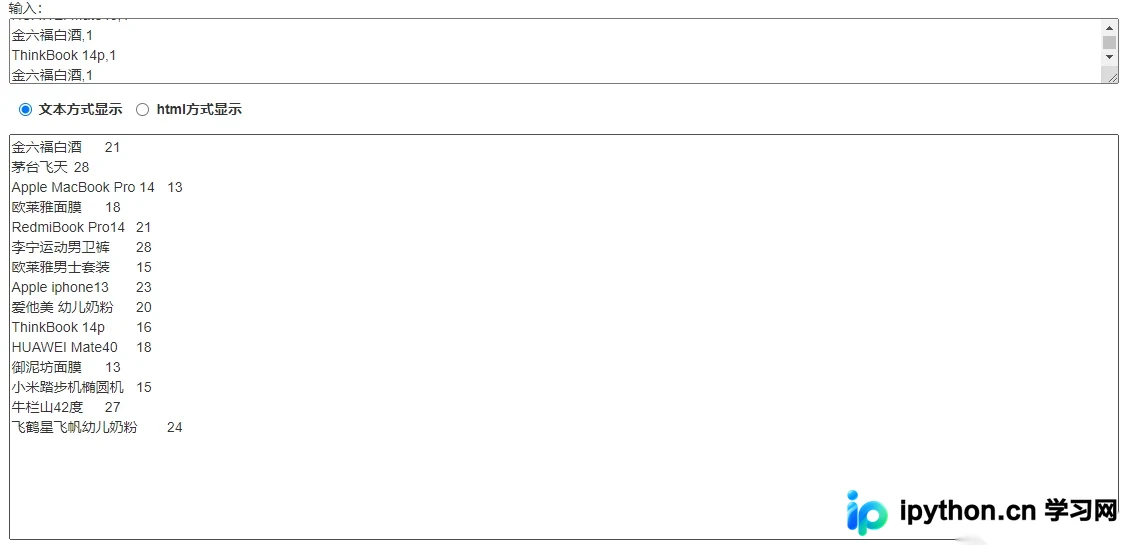
通过上述步骤,我们成功实现了简单的销售数据统计功能。
至此,关于使用 Python 手动实现 MapReduce 模型统计销量的介绍已完成。如需了解更多 Python 与 MapReduce 相关内容,建议搜索本站过往文章或继续浏览后续相关教程。感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















