


Python列表转集合去重后顺序丢失怎么办?

在 Python 中,通过 list(set(raw_list)) 去重会导致元素原本的相对位置被完全打乱。如果业务场景要求保留元素首次出现的先后顺序,最直接高效的标准方案是使用 list(dict.fromkeys(raw_list))。这行代码既能保证去重的高效性,又依托 Python 字典的保序特性完整留存了先来后到的位置。下文将梳理乱序的原因、可用的解决手段以及不同数据类型下的应对策略。
为什么使用集合去重一定会打乱原有顺序?
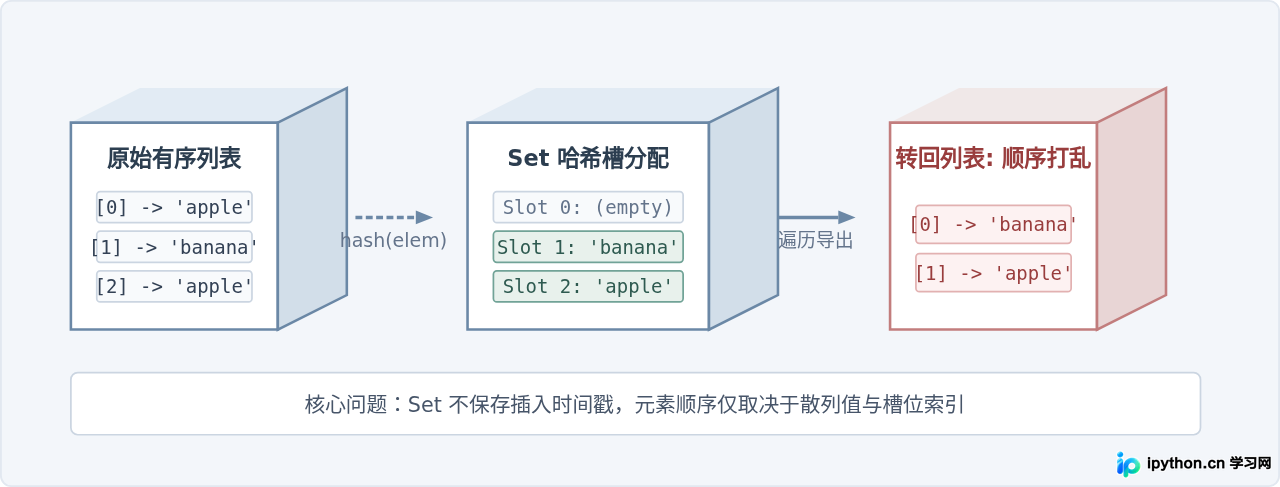
为了理解顺序丢失的原因,需要观察 Python 集合(Set)的底层结构。列表(List)是以连续整数索引排列的线性结构,元素按追加顺序存储;而集合在底层是基于哈希表实现的无序容器。
当元素被存入集合时,Python 会先根据哈希函数计算出元素的哈希值,再由哈希值与掩码运算决定其在哈希桶中的插槽位置。元素的分布取决于散列分布,而非列表的物理插入时间。转换回列表时,解释器只是按哈希桶中槽位的排列顺序依次取出数据,自然无法维持原列表的先后逻辑。
首选方案:使用 dict.fromkeys()
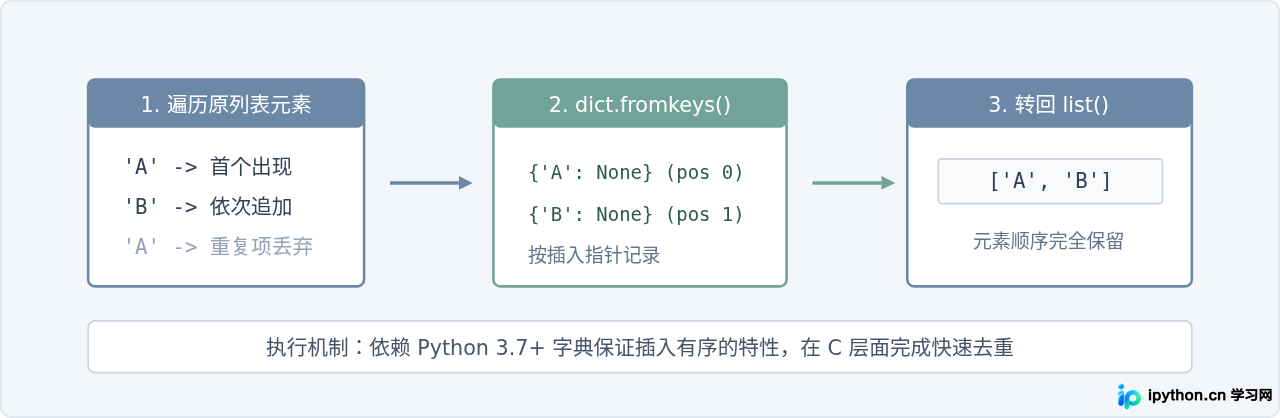
自 Python 3.7 开始,标准字典正式在语言规范层面保证“维护键的插入顺序”(在 Python 3.6 的 CPython 实现中已具备此特性)。dict.fromkeys() 接收一个可迭代对象,并将其元素作为字典的键生成字典;由于字典中键不能重复,后传入的重复元素会被直接忽略,从而自然完成了去重并保留首次出现的相对顺序。
# 示例代码:常规数据类型的有序去重
source_list = ["apple", "orange", "banana", "apple", "grape", "orange"]

# 使用字典键保序去重
deduped_list = list(dict.fromkeys(source_list))

print("去重后的结果:", deduped_list)这个方法不仅语法极短,而且底层完全运行在 C 语言层面,执行速度与纯集合去重相差无几,时间复杂度保持在稳定的平均 O(n)。对于绝大多数常见业务数据,这都是最优选择。
备选方案:列表推导式配合临时集合
如果业务中需要在去重时执行额外的条件判断,或者希望更清晰地展示去重逻辑,可以使用“列表推导式 + 辅助集合”的方式。这种方式通过一个外部集合记录已经出现过的元素,利用集合进行 O(1) 的快速查找,同时利用推导式保持列表原有的迭代顺序。
# 示例代码:带条件的有序去重
source_list = ["apple", "orange", "banana", "apple", "grape", "orange"]

seen = set()
# set.add(x) 返回 None,借助 not 运算符可以在推导式内原位记录元素
deduped_list = [x for x in source_list if not (x in seen or seen.add(x))]

print("去重后的结果:", deduped_list)not (x in seen or seen.add(x)) 技巧能在一行内完成去重,但写成标准的 for 循环函数在团队协作中可读性更好,也能方便地添加日志或类型检查。
元素不可哈希时怎么办?(包含字典或列表)
dict.fromkeys() 和 set() 方案都有一个硬性限制:列表中的元素必须是可哈希(Hashable)对象。如果列表元素是字典、嵌套列表这类可变数据类型(不可哈希),直接调用这些方法会触发 TypeError: unhashable type。
面对嵌套结构数据,可以采用两种应对思路:
1. 按特定字段去重:很多场景下,列表内是字典数据,只需要根据某个唯一键(如 id)去重。这时可以维护一个记录 id 的集合。
# 场景一:按字典中的指定字段有序去重
user_list = [
    {"id": 101, "name": "Alice"},
    {"id": 102, "name": "Bob"},
    {"id": 101, "name": "Alice (Duplicate)"}
]

seen_ids = set()
unique_users = []

for user in user_list:
    if user["id"] not in seen_ids:
        unique_users.append(user)
        seen_ids.add(user["id"])

print("字段去重结果:", unique_users)2. 整个对象完整比对:如果要求字典内容完全相同才判定为重复,可以在去重前将字典转换为不可变的元组(Tuple)或有序键值对,使其满足哈希条件。
# 场景二:整个字典完全去重(转为可哈希格式)
raw_dicts = [
    {"name": "Alice", "role": "admin"},
    {"name": "Bob", "role": "user"},
    {"name": "Alice", "role": "admin"}
]

seen_signatures = set()
deduped_dicts = []

for d in raw_dicts:
    # 转换为排序后的元组签名以支持哈希
    signature = tuple(sorted(d.items()))
    if signature not in seen_signatures:
        deduped_dicts.append(d)
        seen_signatures.add(signature)

print("完全去重结果:", deduped_dicts)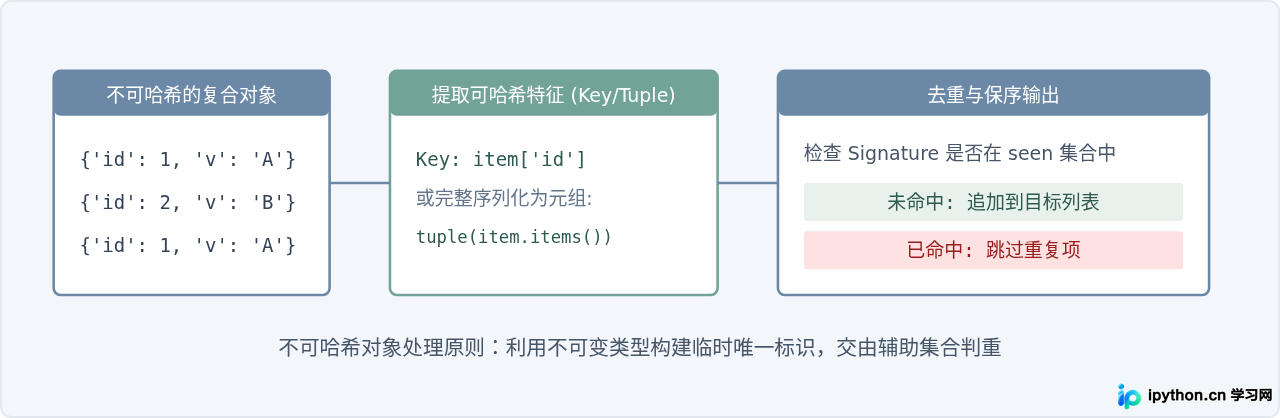
不同去重方式的对比与选择
除了上述方法,有时还会看到利用原有列表索引排序的做法(例如 sorted(set(lst), key=lst.index))。这种写法虽然直观,但隐藏了严重的性能缺陷:对每个集合元素调用 lst.index 会进行全列表线性扫描,导致算法时间复杂度飙升至 O(n²),在数据量超过数千条时会出现明显的卡顿。
各方案的核心指标对比如下:
| 去重实现方式 | 是否保序 | 时间复杂度 | 适用场景与限制 |
|---|---|---|---|
list(set(x)) |
否 | O(n) | 对顺序无要求的普通数据快速去重 |
list(dict.fromkeys(x)) |
是 | O(n) | 首选推荐。代码简短,性能最佳,要求元素可哈希 |
推导式 + seen = set() |
是 | O(n) | 需要在去重过程中执行过滤或特定业务判断 |
sorted(set(x), key=x.index) |
是 | O(n²) | 不建议使用。数据量增大时性能急剧下降 |
| 特征签名 + 辅助集合 | 是 | O(n) ~ O(n log m) | 列表中元素为字典、列表等不可哈希类型 |
总结
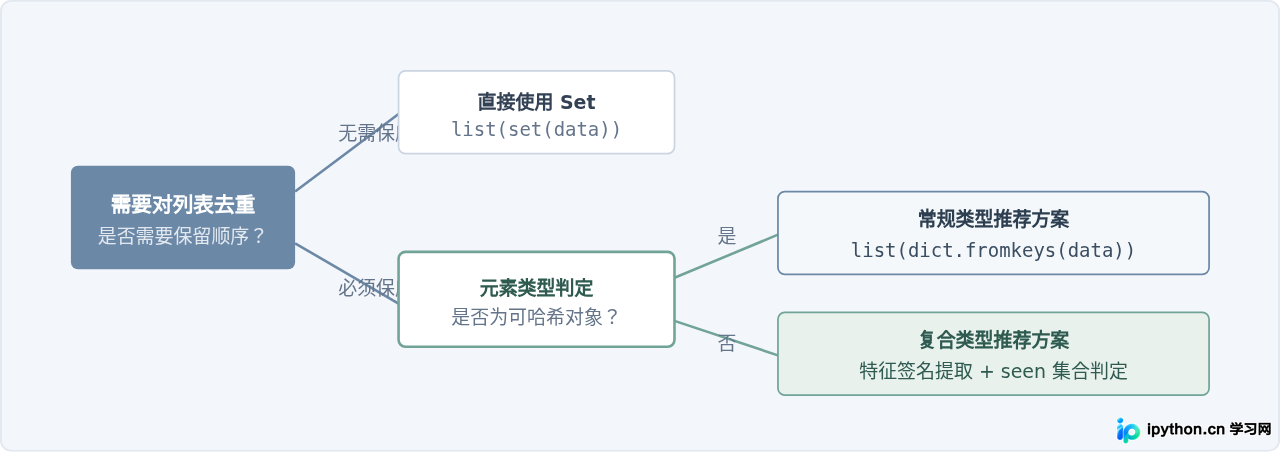
面对“列表转集合去重后顺序丢失”的情况,核心解决原则是:不要使用无序的 set 作为中间承载容器。对于包含字符串、数字、元组等常规数据的列表,直接将 list(set(x)) 替换为 list(dict.fromkeys(x)) 是兼顾性能与可读性的最佳解法;如果数据项是字典等复合数据结构,则配合提取唯一标识与辅助集合,即可在维持 O(n) 高性能的前提下完成有序去重。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















