


Python中调用父类方法的两种实现方式对比

在Python面向对象编程中,子类调用父类方法是常见操作。主要存在两种实现路径:使用内置的 super() 函数,以及直接通过父类名称调用。这两种方式在单继承中表现相似,但在涉及多重继承时,其行为机制和潜在风险存在显著差异。理解其背后的 MRO(方法解析顺序)机制,对于编写健壮的多继承代码至关重要。
两种调用方式的基本语法
Python 提供了两种显式调用父类方法的语法结构:
- 使用
super()函数:这是推荐的标准做法。在 Python 3 中,通常直接调用super().method(args)即可,无需显式传入类名和实例。 - 直接调用父类方法:显式指定父类名称,语法为
Parent.method(self, args)。
尽管两者在简单的单继承场景中功能等价,但在复杂的继承体系中,直接调用父类会破坏方法解析的连贯性。
Python 版本与类定义的演变
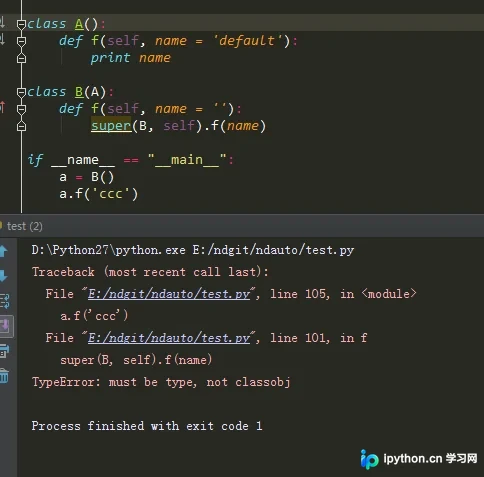
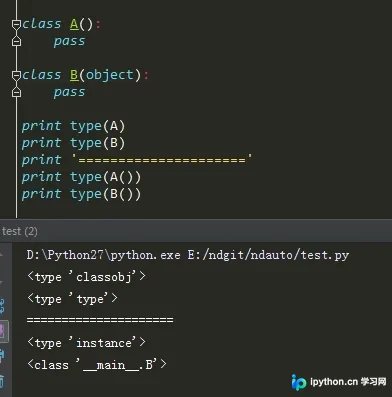
理解这两种方式的区别,需要回顾 Python 中类的定义历史。在早期的 Python 2 中,类分为“老式类”和“新式类”:
- 老式类:未显式继承
object的类。例如:
在老式类中使用class A: passsuper()可能会报错,提示找不到classobj。 - 新式类:显式继承
object的类。例如:
新式类支持class A(object): passsuper()并引入了 MRO 机制。
自 Python 3 起,所有类均隐式继承自 object,老式类概念已被移除。这意味着在现代 Python 开发中,super() 的使用不再受限于类的定义方式,且始终基于新式类的 MRO 机制运行。
核心机制:MRO 与 super() 的工作原理
super() 的核心价值在于它与 MRO(Method Resolution Order,方法解析顺序)的紧密绑定。MRO 决定了在多重继承中,Python 查找属性或方法的顺序。
从实现原理上看,super() 的工作流程如下:
- 获取当前实例所属类的 MRO 列表:
mro = inst.__class__.mro()。 - 在 MRO 列表中找到当前类(
cls)的位置。 - 返回 MRO 列表中当前类之后的下一个类:
mro[mro.index(cls) + 1]。
这意味着 super() 并不是简单地指向“父类”,而是指向 MRO 序列中的“下一个类”。这种机制确保了在多重继承图中,方法调用的路径是确定且唯一的。
多重继承中的关键差异
在涉及多重继承的场景中,两种调用方式的区别尤为明显,主要体现在基类构造函数(__init__)的执行次数上。
使用 super():确保执行一次
当所有子类都正确使用 super() 时,Python 的 C3 线性化算法会生成一个唯一的 MRO 序列。这保证了无论继承结构多么复杂,每个基类的 __init__ 方法只会被调用一次。例如,在一个菱形继承结构中:
class E(B, C, D):
 def __init__(self):
  # code...
  super().__init__()  # 正确调用,遵循 MRO
通过 super() 链式调用,系统会自动跳过已经处理过的类,避免重复初始化。
直接调用:可能导致重复执行
如果在多重继承中,子类直接通过父类名称调用方法(如 B.__init__(self)),则绕过了 MRO 机制。这会导致:
- 重复初始化:如果多个子类都直接调用同一个基类,该基类的
__init__可能会被多次执行。 - 状态不一致:重复执行构造函数可能导致资源浪费或状态覆盖,引发难以排查的 Bug。
总结与建议
在 Python 开发中,尤其是在涉及多重继承时,强烈建议始终使用 super() 来调用父类方法。它依赖于 MRO 机制,能够智能地处理复杂的继承关系,确保基类逻辑仅执行一次。直接调用父类方法虽然在简单场景下可行,但破坏了继承体系的完整性,容易在复杂项目中引入隐蔽的错误。
以上就是Python实现父类调用两种方法的不同内容的详细总结,更多关于Python面向对象编程及继承机制的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















