


Python爬虫入门:Beautiful Soup网页元素定位详解

本文详细介绍Python爬虫中如何使用Beautiful Soup模块快速定位网页元素。涵盖模块安装、基础用法、四大核心对象(BeautifulSoup、Tag、NavigableString、Comment)解析,以及find与find_all方法的参数详解与实战代码示例,帮助初学者掌握高效的数据提取技巧。
实战场景
对于初学Python爬虫的用户而言,采集目标通常锁定在网页数据上。因此,如何快速且准确地定位到网页中的具体内容,成为了大家面临的首要难题。本文将详细解析最基础且易上手的网页元素定位方法,确保读者学完即可上手应用。
本文的核心工具是Beautiful Soup模块。为了演示测试,我们选择其官方网站作为采集目标(注:当前网络环境对爬虫采集的限制日益严格,许多网站已禁止抓取,因此建议初学者以官方文档站点为练习对象,避免被封禁)。
官方站点:
www.crummy.com/software/BeautifulSoup/Beautiful Soup在Python爬虫领域享有极高声誉,且易于使用。它是一款Python解析库,主要功能是将HTML标签转换为Python对象树,从而允许用户从该对象树中便捷地提取所需数据。
该模块的安装过程非常简单:
pip install bs4 -i 国内任意源即可建议未来安装任何Python模块时,均使用国内镜像源,以确保下载速度快且连接稳定。
需要注意的是,该模块在pip中的包名称为bs4,安装时请务必确认此名称。
基础用法如下所示:
import requests
from bs4 import BeautifulSoup
def ret_html():
    """获取HTML元素"""
    res = requests.get('https://www.crummy.com/software/BeautifulSoup/', timeout=3)
    return res.text
if __name__ == '__main__':
    html_str = ret_html()
    soup = BeautifulSoup(html_str, 'lxml')
    print(soup)
在使用时,需特别注意模块的导入代码。在实例化 soup 对象时,需向 BeautifulSoup 类的构造函数中传递两个关键参数:一是待解析的HTML字符串,二是解析器。官方推荐使用 lxml 作为解析器,因其具备较高的解析速度。
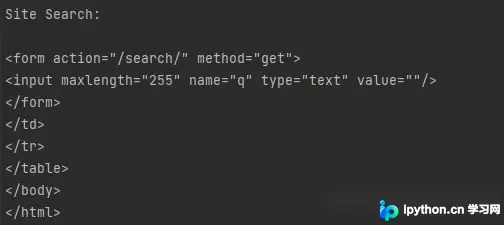
上述代码执行后输出的内容如下所示,其外观与普通HTML代码文件无异。
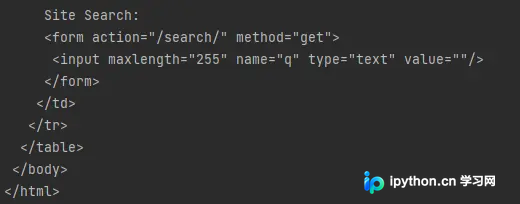
此外,我们可以调用 soup 对象的 soup.prettify() 方法,对HTML标签进行格式化排版。这样在将结果存储到外部文件时,可使输出的HTML代码更加美观易读。
BeautifulSoup 模块的对象说明
BeautifulSoup 类负责将HTML文本解析为Python对象树,其中包含四种最重要的对象类型,分别是 Tag,NavigableString,BeautifulSoup,Comment 对象。接下来我们将逐一介绍这些对象的具体特性。
BeautifulSoup 对象
该对象代表整个HTML页面。在实例化该对象时,Beautiful Soup会自动补全缺失的HTML代码结构,确保解析的完整性。
    html_str = ret_html()
    soup = BeautifulSoup(html_str, 'lxml')
    print(type(soup))
Tag 对象
Tag意为标签,Tag对象即代表网页中的标签或网页元素。例如,获取bs4官网的h1标签对象的代码如下所示:
if __name__ == '__main__':
    html_str = ret_html()
    soup = BeautifulSoup(html_str, 'lxml')
    # print(soup.prettify())  # 格式化 HTML
    print(soup.h1)
执行后将得到网页中的h1标签内容:
<h1>Beautiful Soup</h1>使用Python内置的type函数,可以查看其数据类型,代码如下:
    print(soup.h1)
    print(type(soup.h1))
此时返回的结果并非字符串,而是一个Tag对象。
<h1>Beautiful Soup</h1>
<class 'bs4.element.Tag'>
既然获取的是Tag对象,它便具备一些特定的属性值供我们调用。
获取标签名称
    print(soup.h1)
    print(type(soup.h1))
    print(soup.h1.name)  # 获取标签名称
通过Tag对象可以获取标签的属性值。
 print(soup.img)  # 获取网页第一个 img 标签
 print(soup.img['src'])  # 获取网页元素DOM的属性值
利用attrs属性,可以获取标签的所有属性信息。
print(soup.img)  # 获取网页第一个 img 标签
print(soup.img.attrs)  # 获取网页元素的所有属性值,以字典形式返回
以上代码的所有输出结果如下所示,读者可任意选择标签进行练习以加深理解。
<h1>Beautiful Soup</h1>
<class 'bs4.element.Tag'>
h1
<img align="right" src="10.1.jpg" width="250"/>
{'align': 'right', 'src': '10.1.jpg', 'width': '250'}
NavigableString 对象
NavigableString对象用于获取标签内部的文字内容。例如,针对p标签,在下述代码中提取的是我是橡皮擦。
<p>我是橡皮擦</p>获取该对象也非常容易,只需使用Tag对象的string属性即可。
    nav_obj = soup.h1.string
    print(type(nav_obj))
输出结果如下所示:
<class 'bs4.element.NavigableString'>
如果目标标签是一个单标签(无闭合标签),则会获取到None数据。
除了使用对象的string方法外,还可以使用text属性和get_text()方法来获取标签内容。
    print(soup.h1.text)
    print(soup.p.get_text())
    print(soup.p.get_text('&'))
其中 text是获取所有子标签内容的合并字符串,而get_text()也是相同的效果。不过使用get_text()可以增加一个分隔符,例如上述代码中的&符号。此外,还可以使用strip=True参数来去除字符串两端的空格。
Comment 对象
BeautifulSoup对象和Tag对象均支持标签查找方法,具体内容如下所示。
find() 方法和 find_all() 方法
调用BeautifulSoup对象和Tag对象的find()方法,可以在网页中找到指定的对象。
该方法的语法格式如下:
obj.find(name,attrs,recursive,text,**kws)方法的返回结果是查找到的第一个元素;如果未查询到匹配项,则返回None。参数说明如下:
name:标签名称;attrs:标签属性;recursive:默认搜索所有后代元素;text:标签内容。
例如,我们继续在上文请求的网页中,查找a标签,代码如下:
html_str = ret_html()
soup = BeautifulSoup(html_str, 'lxml')
print(soup.find('a'))也可以使用attrs参数进行查找,代码如下:
html_str = ret_html()
soup = BeautifulSoup(html_str, 'lxml')
# print(soup.find('a'))
print(soup.find(attrs={'class': 'cta'}))find()方法还提供了一些特殊的参数,便于直接查找。例如可以使用id=xxx,查找属性中包含 id的标签;可以使用class_=xxx,查找属性中包含class的标签。
print(soup.find(class_='cta'))与find()方法成对出现的是find_all()方法。从名称即可知,其返回结果是全部匹配标签,语法格式如下:
obj.find_all(name,attrs,recursive,text,limit)其中重点说明一下limit参数,它表示最多返回的匹配数量。find()方法可以看作limit=1,这样就变得容易理解了。
到此这篇关于Python爬虫网页元素定位术的文章就介绍到这了,更多相关Python元素定位内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















