


Python Pandas中iloc与loc切片用法详解

发布时间:2026-10-15 |
5人浏览过
本文详细解析Python Pandas库中iloc与loc两种切片方法的实现机制。文章首先阐述含正负号下标的切片规则,随后对比iloc基于整数位置与loc基于标签索引的核心区别。通过具体代码示例,演示如何利用两者提取指定行、列、全表数据,以及基于条件的行筛选操作,帮助开发者准确掌握数据选取技巧。
一、含正负号的下标
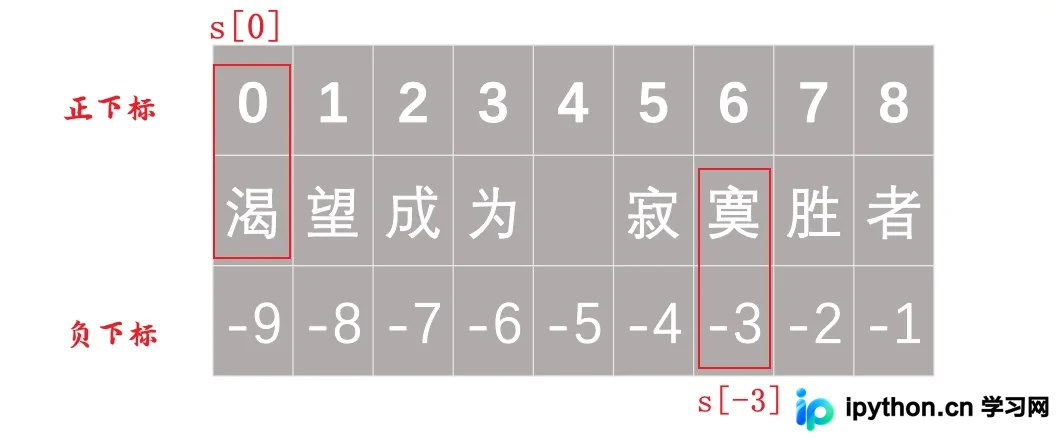
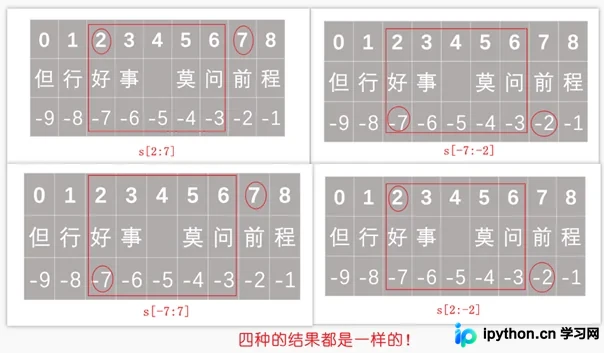
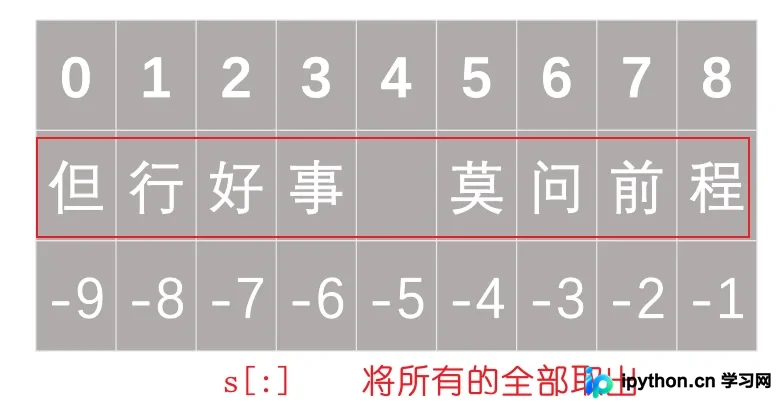
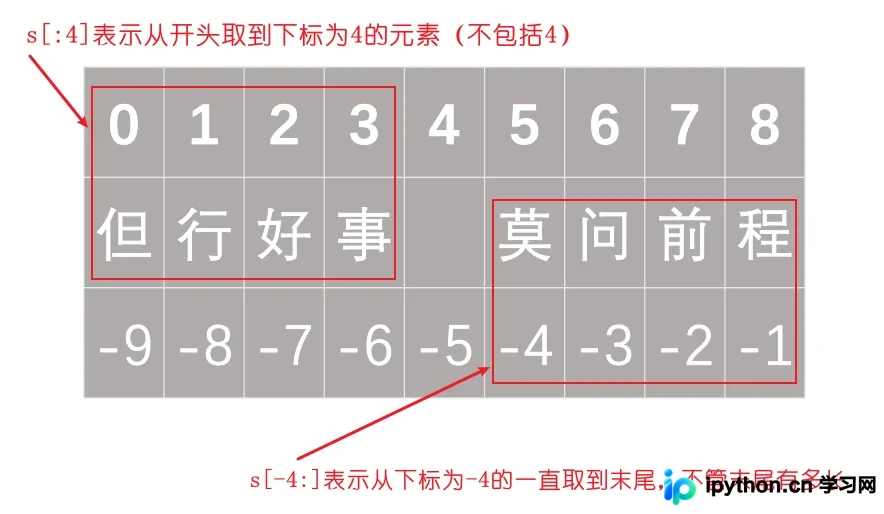
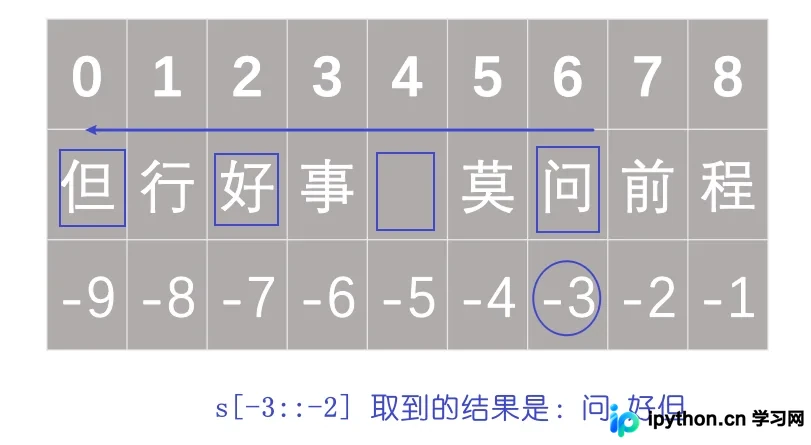
在Python切片操作中,正数下标从0开始计数,而负数下标则从-1开始倒数。需要注意的是,切片操作遵循“包含起始位置,不包含结束位置”的原则,即左闭右开区间。
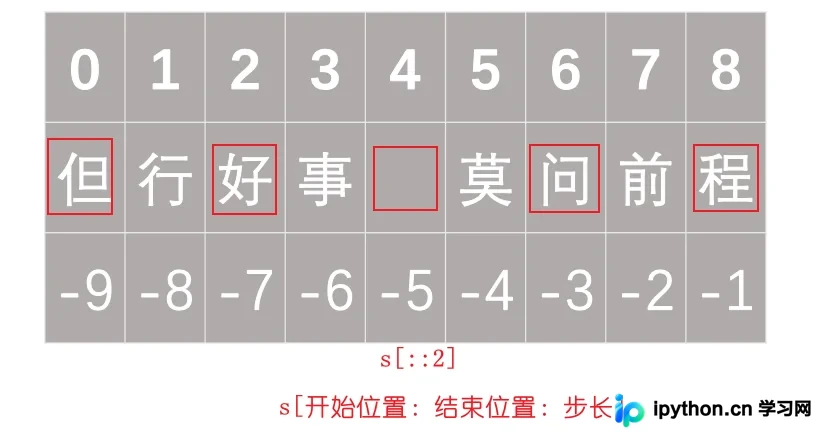
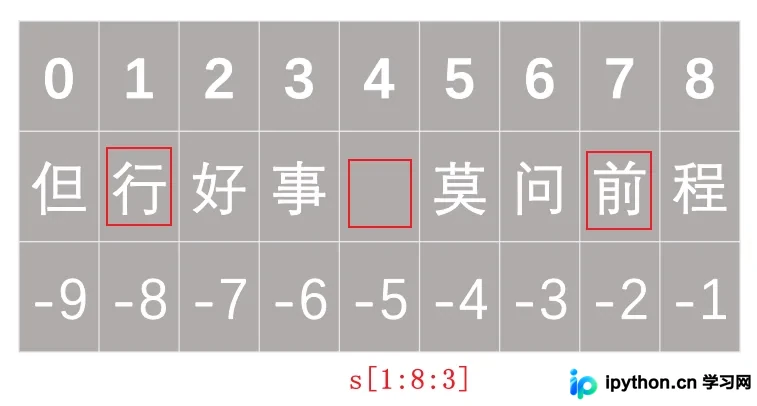
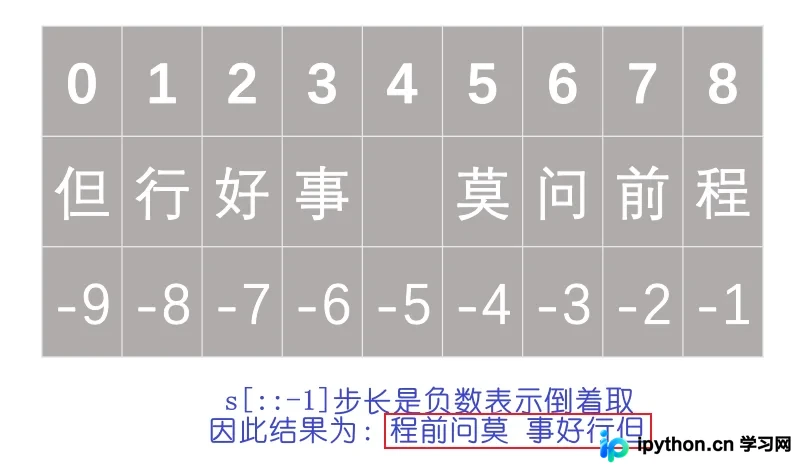
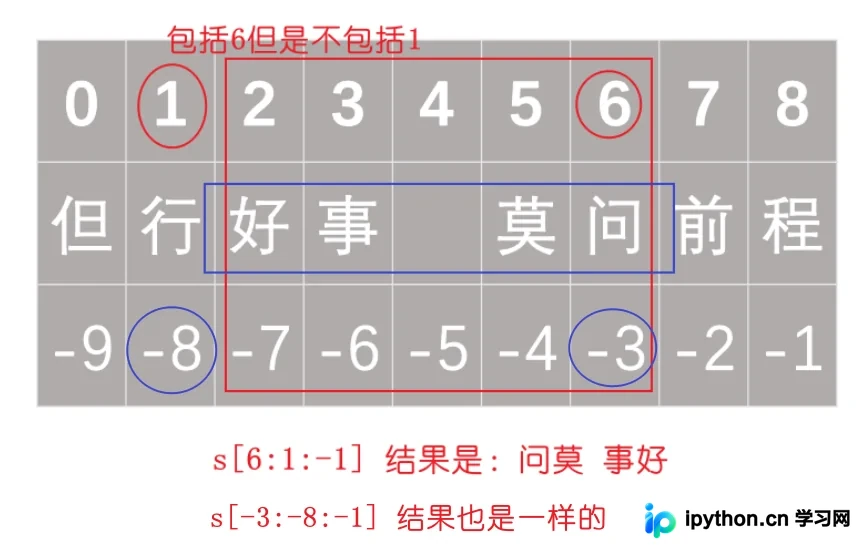
二、loc和iloc
loc是location(位置)的缩写,而iloc中的i代表integer(整数)。两者虽然都用于数据选取,但索引依据不同。
【1】iloc:该方法依据标签在数据中的物理位置进行选取,计数从0开始。操作时先指定行索引,再指定列索引。
【2】loc:该方法依据DataFrame中具体的标签名称(如字符串索引)来选取行列,同样遵循先指定行标签、后指定列标签的顺序。
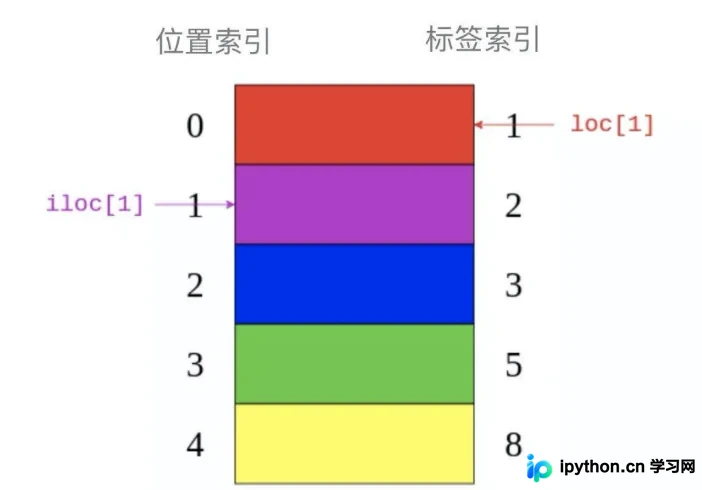
通过对比示例可以看出:iloc[:4,2]与loc[:4,2]的结果存在差异。前者选取的行不包括索引为4的行(即只取0到3),而后者选取的行包括标签为4的行(若存在)。
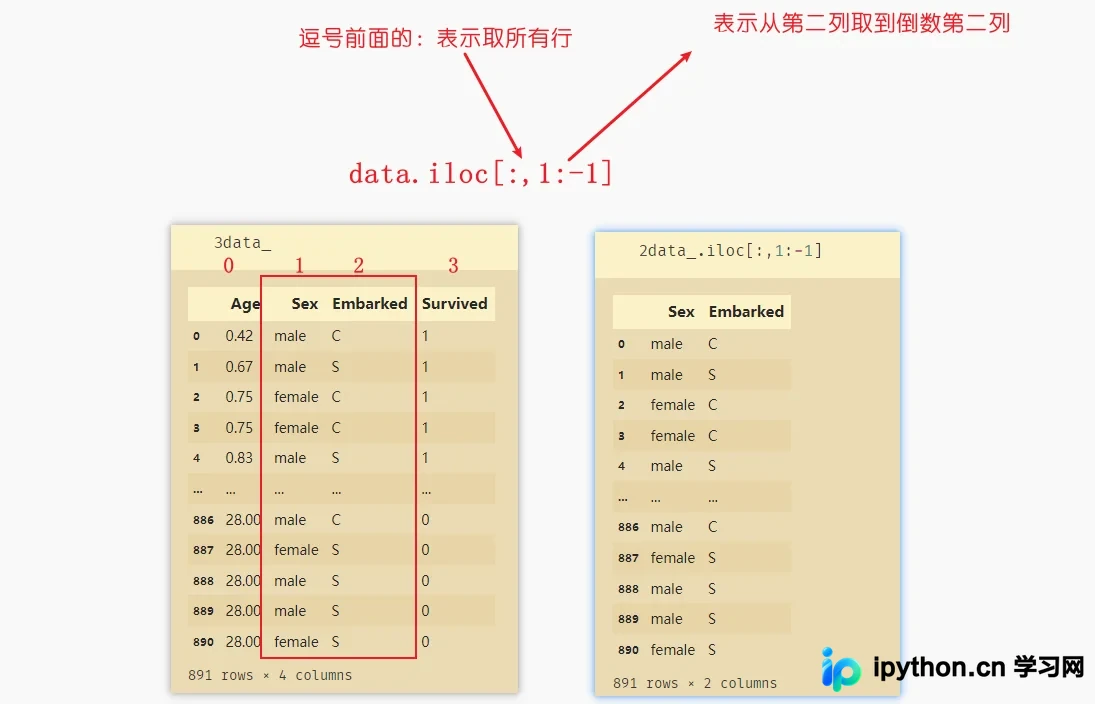
lypdfdata=lypdf.iloc[:,1:-1].values
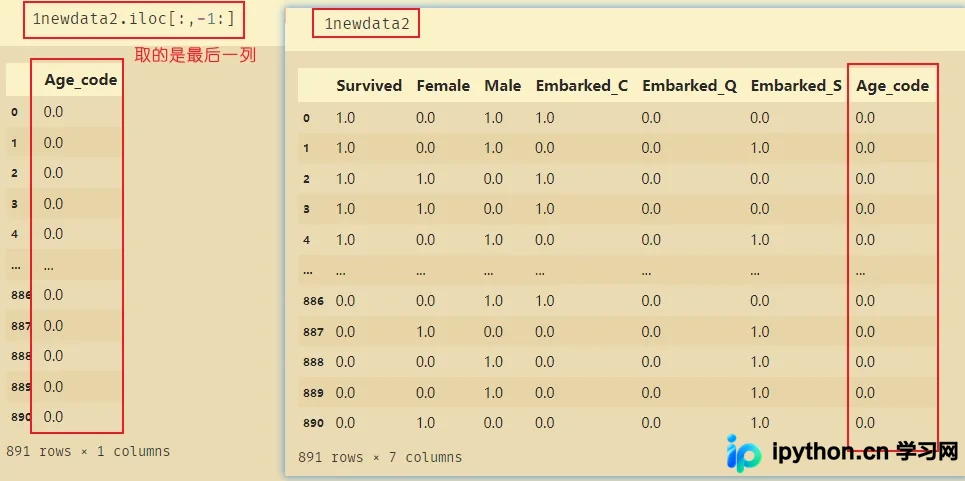
lypdftarget=lypdf.iloc[:,:-1].values
# 逗号前面是属于行,后面是属于列
1. 利用loc、iloc提取行数据
import numpy as np
import pandas as pd
#创建一个Dataframe
data=pd.DataFrame(np.arange(16).reshape(4,4),index=list('abcd'),columns=list('ABCD'))

In[1]: data
Out[1]:
    A   B   C   D
a   0   1   2   3
b   4   5   6   7
c   8   9  10  11
d  12  13  14  15

#取索引为'a'的行
In[2]: data.loc['a']
Out[2]:
A    0
B    1
C    2
D    3

#取第一行数据,索引为'a'的行就是第一行,所以结果相同
In[3]: data.iloc[0]
Out[3]:
A    0
B    1
C    2
D    3
2. 利用loc、iloc提取列数据
In[4]:data.loc[:,['A']] #取'A'列所有行,多取几列格式为 data.loc[:,['A','B']]
Out[4]:
    A
a   0
b   4
c   8
d  12

In[5]:data.iloc[:,[0]] #取第0列所有行,多取几列格式为 data.iloc[:,[0,1]]
Out[5]:
    A
a   0
b   4
c   8
d  12
3.利用loc、iloc提取指定行、指定列数据
In[6]:data.loc[['a','b'],['A','B']] #提取index为'a','b',列名为'A','B'中的数据
Out[6]:
   A  B
a  0  1
b  4  5

In[7]:data.iloc[[0,1],[0,1]] #提取第0、1行,第0、1列中的数据
Out[7]:
   A  B
a  0  1
b  4  5
4.利用loc、iloc提取所有数据
In[8]:data.loc[:,:] #取A,B,C,D列的所有行
Out[8]:
    A   B   C   D
a   0   1   2   3
b   4   5   6   7
c   8   9  10  11
d  12  13  14  15

In[9]:data.iloc[:,:] #取第0,1,2,3列的所有行
Out[9]:
    A   B   C   D
a   0   1   2   3
b   4   5   6   7
c   8   9  10  11
d  12  13  14  15
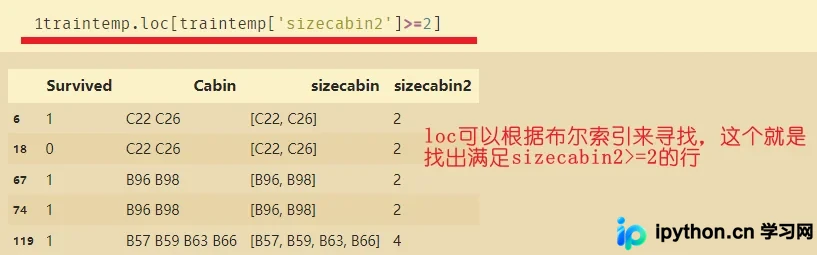
5.利用loc函数,根据某个数据来提取数据所在的行
In[10]: data.loc[data['A']==0] #提取data数据(筛选条件: A列中数字为0所在的行数据)
Out[10]:
   A  B  C  D
a  0  1  2  3

In[11]: data.loc[(data['A']==0)&(data['B']==2)] #提取data数据(多个筛选条件)
Out[11]:
   A  B  C  D
a  0  1  2  3
到此这篇关于python iloc和loc切片的实现的文章就介绍到这了,更多相关python iloc和loc切片内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















