


Python基础详解:内置函数、Lambda表达式与递归应用

本文系统梳理Python核心编程概念,详细解析abs、sorted、map、filter等常用内置函数的用法与特性。深入探讨Lambda匿名函数的定义场景及其与高阶函数的配合使用。重点讲解递归的原理、限制条件及栈溢出风险,结合文件处理与斐波那契数列实例,展示递归在实际开发中的应用与注意事项。
一、内置函数
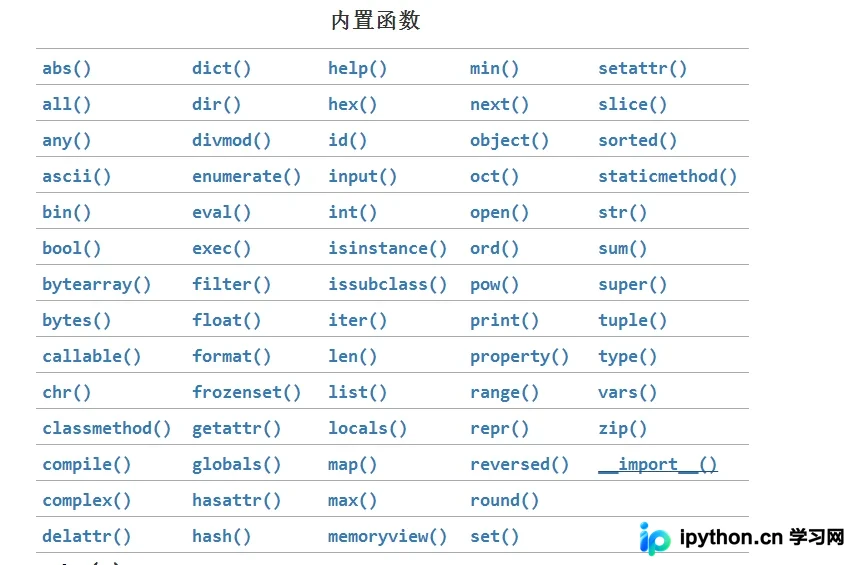
以下对部分常用内置函数进行简要介绍:
1. abs():用于计算并返回数值的绝对值。
2. all():接收一个可迭代对象(iterable)作为参数。若该对象中所有元素均为真值(truthy),或者该可迭代对象为空,则返回 True。
3. any():接收一个可迭代对象作为参数。若该对象中至少有一个元素为真值,则返回 True;若可迭代对象为空,则返回 False。
4. callable():用于检测对象是否可调用。如果参数 object 是可调用对象(如函数、类或实现了 __call__ 方法的实例),则返回 True,否则返回 False。
5. divmod():接收两个非复数数字作为参数,返回一个包含商和余数的元组。对于整数运算,其结果等同于 (a//b, a%b)。对于浮点数运算,结果形式为 (q, a%b),其中 q 通常等于 math.floor(a/b),但在某些情况下可能小于 1。
6. enumerate():接收一个可迭代对象作为参数,返回一个枚举对象(迭代器)。该迭代器输出元素及其对应的索引值,常用于需要同时获取索引和值的循环场景。
7. eval():接收一个字符串参数,解析该字符串并将其作为 Python 表达式执行,返回执行结果。
8. frozenset():用于创建一个不可变集合(frozenset)。与 set 不同,frozenset 定义后不支持添加或删除元素的操作,适用于需要集合不可变性的场景。
9. globals():返回表示当前全局符号表的字典。该字典始终指向定义该函数的模块(即在函数或方法内部调用时,返回的是定义该函数所在的模块字典,而非调用它的模块)。
10. round():对数值参数进行四舍五入处理,返回最接近的整数值或指定位数的小数值。
11. sorted():对可迭代对象进行排序,返回一个新的已排序列表,原列表保持不变。
l=[1,2,4,9,-1]
print(sorted(l)) #从小到大
print(sorted(l,reverse=True)) #从大到小
12. zip():拉链函数。
该函数创建一个迭代器,用于聚合来自多个可迭代对象的元素。
它返回一个元组迭代器,其中第 i 个元组包含来自每个参数序列或迭代器的第 i 个元素。当最短的输入可迭代对象耗尽时,迭代器停止生成。若仅提供一个可迭代参数,则返回包含 1 元组的迭代器;若无参数,则返回空迭代器。
13. max():
该函数返回可迭代对象中的最大项,或返回两个及以上参数中最大的一个。
如果仅提供一个位置参数,该参数应为可迭代对象,函数返回该迭代中的最大项。如果提供两个或多个位置参数,则直接比较这些参数并返回最大值。
max() 函数支持指定 key 参数,用于指定比较时使用的键函数,从而自定义排序或比较逻辑。
14. map():映射函数。
该函数返回一个迭代器,它将指定的 function 应用到 iterable 的每个项目上,并产生结果。
l=[1,2,3,4]
m=map(lambda x:x**2,l)
print(list(m))    ----->[1, 4, 9, 16]
15. reduce():合并函数。
from functools import reduce

res=0
for i in range(100):
  res+=i
print(res)
16. filter():过滤函数,用于保留布尔值为 True 的元素。
names=['alex_sb','yuanhao_sb','wupeiqi_sb','egon']
print(list(filter(lambda name:name.endswith('_sb'),names)))--->['alex_sb', 'yuanhao_sb', 'wupeiqi_sb']
如需查阅更详细的内置函数介绍,可参考以下文档:https://www.rddoc.com/doc/Python-3.6.0/library/functions/
二、匿名函数(lambda表达式)
def func(x):
  return x**2
print(func(2))

lambda x:x**2    #上边的函数就可以直接写成这种形式
lambda 函数默认自带返回值,无需显式使用 return 语句。
匿名函数通常仅用于替代逻辑非常简单的函数,且主要与其他高阶函数(如 map、filter)搭配使用。
此外,在某些场景下,若定义的函数仅使用一次且后续不再需要,不删除会占用内存空间,而显式删除又较为繁琐,此时使用匿名函数是一种简洁的处理方式。
三、递归
递归是指在调用一个函数的过程中,直接或间接地调用了函数本身。
递归的执行效率通常较低,因为在进入下一次递归时需要保留当前状态。与某些其他编程语言不同,Python 不支持尾递归优化,但为了防止无限递归导致栈溢出,Python 设置了递归深度限制。
递归具有以下几个主要特点:
1. 必须包含一个明确的结束条件(基准情况),否则递归将无法终止。
2. 每次进入更深一层的递归时,问题的规模应相比上一次递归有所减少,逐步逼近结束条件。
3. 递归效率相对较低,且递归层数过多会导致栈溢出(Stack Overflow)错误。
示例:
# 1 文件内容如下,标题为:姓名,性别,年纪,薪资
#
# egon male 18 3000
# alex male 38 30000
# wupeiqi female 28 20000
# yuanhao female 28 10000
#
# 要求:
# 从文件中取出每一条记录放入列表中,
# 列表的每个元素都是{'name':'egon','sex':'male','age':18,'salary':3000}的形式
#
# 2 根据1得到的列表,取出薪资最高的人的信息
# 3 根据1到的列表,取出最年轻的人的信息
# 4 根据1得到的列表,将每个人的信息中的名字映射成首字母大写的形式
# 5 根据1得到的列表,过滤掉名字以a开头的人的信息
# 6 使用递归打印斐波那契数列(前两个数的和得到第三个数)
#   0 1 1 2 3 4 7...

with open('b.txt',encoding='utf-8')as f:

  l=[{'name': line.split()[0], 'sex': line.split()[1], 'age': line.split()[2], 'salary': line.split()[3]} \
      for line in f]
#2.
print(max(l,key=lambda i:i['salary']))

#3.
print(min(l,key=lambda i:i['age']))

#4.
m=map(lambda x:x['name'].capitalize(),l)
print(list(m))
#5.
print(list(filter(lambda x:not(x['name'].startswith('a')),l)))
#6.
def f(n):
  if n==0:
    return 0
  elif n==1:
    return 1
  else:
    if n==1000:
      return f(1000)
    else:
      return f(n-2)+f(n-1)

for i in range(150):
  print(f(i))
以上关于Python基础内置函数与递归的介绍即为全部内容,希望能为读者提供参考,并欢迎大家支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















