


Python合并RepeatMasker预测结果中染色体的overlap区域

发布时间:2026-10-15 |
4人浏览过
本文介绍如何使用Python脚本处理RepeatMasker预测的重复序列结果,通过提取关键列、去重排序及滑动窗口双指针比对,合并染色体上的重叠区域。特别设定gap=50bp,将间距小于此值的序列视为重叠进行合并,最终生成新的预测结果文件,优化重复序列注释数据。
前言
RepeatMasker是一款利用已有数据库预测重复序列的工具,能够筛选DNA序列中的散在重复序列和低复杂序列,是进行重复序列注释的重要软件。
问题
我们需要对RepeatMasker预测的结果文件进行重复序列的合并处理,即去除染色体之间的重叠区域,同时将基因间距小于50个bp的序列也视为重叠部分。那么,应该如何利用Python处理这些数据并生成新的预测结果呢?
思路
- 首先需要对文件进行预处理,提取出需要处理的列,其中'//'标记可以忽略。
- 接着,对相同染色体序列按照升序进行归并排序。
- 最后,分别针对相应染色体,按照滑动窗口的思路进行双指针比对,注意设置gap=50。
1. 预处理
我们这里只需要结果文件的前三列,可以使用awk命令获取。
    awk '{for(i = 1; i <= 3; i++)
         printf("%s ", $i);
         printf("\n")}' result.txt >  pretreatment.txt
         #result.txt为结果文件,pretreatment.txt为预处理结果文件
2. 将pretreatment.txt作为输入文件,
with open ('pretreatment.txt','r')as f:
    for i in f.readlines():
        if i.strip() == '//':
            continue
        c = i.strip().split('\t')
        b.append(c[0])
        a.append((c[0],int(c[1]),int(c[2])))
print ("全部染色体数量: "+str(len(a)))
3.去重+归并排序
c = [i for i in b_set if b.count(i) == 1]
for i in a:
    if i[0] not in c:
        continue
    a.remove(i)
    result.append((i[0],int(i[1]),int(i[2])))
print ("去重后染色体数量: "+str(len(a)))
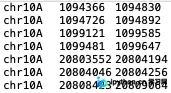
a.sort(key = lambda x : (x[0], x[1], x[2]))
#按照第一列,第二列,第三列分别排降升序
4.开始比对,gap=50
q = ''
start = 0
end = 0
tem1 = []
tem2 = []
gap = 50
for i in a:
    if i[0] != q:
        if tem1:
            if tem1 not in tem2:
                tem2.append(tem1)
                tem1 = []
        q = I[0]
        start = int(i[1])
        end = int(i[2])
        continue
    if int(i[1]) < end or int(i[1]) - end < gap:
        if int(i[2]) > end:
            end = int(i[2])
            continue
        else:
            continue
    tem1.append([q,start,end])
    start = int(i[1])
    end = int(i[2])
5.将new_result.txt作为输出文件,生成结果
with open ('new_result.txt','w')as f:
    for i in tem2:
        for o in I:
            print (o[0],o[1],o[2],file=f)
    for i in result:
        print (i[0],i[1],i[2],file=f)
6. 完整代码
a = []
b = []
with open ('pretreatment.txt','r')as f:
    for i in f.readlines():
        if i.strip() == '//':
            continue
        c = i.strip().split('\t')
        b.append(c[0])
        a.append((c[0],int(c[1]),int(c[2])))
print ("全部染色体数量: "+str(len(a)))
b_set = set(b)
result = []
c = [i for i in b_set if b.count(i) == 1]
for i in a:
    if i[0] not in c:
        continue
    a.remove(i)
    result.append((i[0],int(i[1]),int(i[2])))
print ("去重后染色体数量: "+str(len(a)))
a.sort(key = lambda x : (x[0], x[1], x[2]))
q = ''
start = 0
end = 0
tem1 = []
tem2 = []
gap = 50
for i in a:
    if i[0] != q:
        if tem1:
            if tem1 not in tem2:
                tem2.append(tem1)
                tem1 = []
        q = I[0]
        start = int(i[1])
        end = int(i[2])
        continue
    if int(i[1]) < end or int(i[1]) - end < gap:
        if int(i[2]) > end:
            end = int(i[2])
            continue
        else:
            continue
    tem1.append([q,start,end])
    start = int(i[1])
    end = int(i[2])
with open ('new_result.txt','w')as f:
    for i in tem2:
        for o in I:
            print (o[0],o[1],o[2],file=f)
    for i in result:
        print (i[0],i[1],i[2],file=f)
以上就是Python合并RepeatMasker预测结果中染色体overlap区域的详细内容,更多关于Python处理RepeatMasker预测overlap的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















