


Python爬虫实战:模拟登录与批量下载Pixiv图片详解

本文详细介绍如何使用Python爬取Pixiv图片。内容涵盖通过抓包分析模拟登录流程,动态获取post_key,利用Session保持状态,以及通过BeautifulSoup和正则表达式提取图片链接。针对Pixiv的防盗链机制,文章提供了处理Referer、动态构建真实图片URL及解决403/404错误的完整代码方案。
Python爬取Pixiv图片实战教程
接触Python后,我一直希望能实现Pixiv图片的爬取。此前因网络环境限制一直未行动,近期更换网络工具后,便立即着手尝试。
爬虫的核心逻辑通常是通过requests库获取HTML页面,再利用正则表达式或BeautifulSoup等工具提取目标数据,Pixiv的爬取原理亦不例外。
模拟登录Pixiv账号
首先需实现模拟登录。尽管多数场景无需登录,但会员账号在登录与未登录状态下可见内容存在差异。具体思路为:通过抓包分析登录时的POST请求,解析Pixiv构建的POST数据格式,据此构建表单数据,调用POST方法发起请求并将结果保存至Session对象中。后续访问相关页面时,直接使用Session替代普通的requests请求即可。
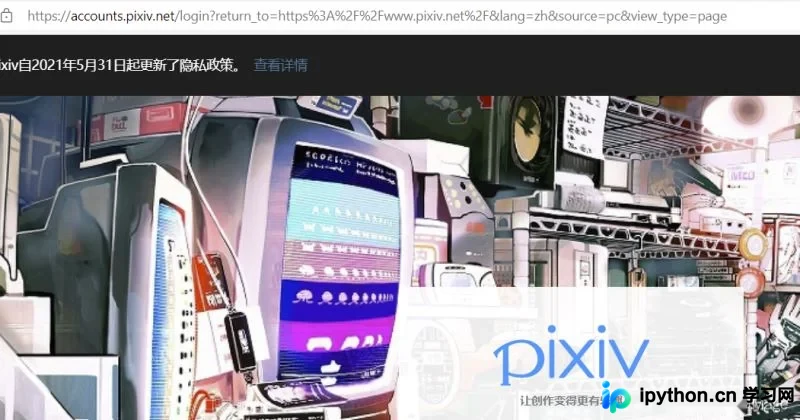
Pixiv的登录网址如下,可直接复制使用:
通过抓包工具定位提交数据的请求接口:
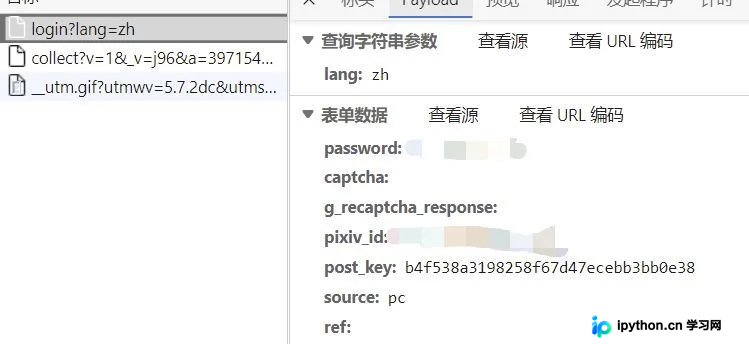
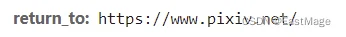
观察表单数据可知,主要包含若干字段。经过多次测试,模拟登录时仅需构建password、pixiv_id、post_key以及return_to(参考第二张截图)这四个参数。其中,pixiv_id对应账号名,password为密码,return_to可直接照填,但post_key是动态生成的随机值。
针对动态生成的post_key,我们可在每次访问登录页面时预先爬取该页面,从中解析出postkey的值。
参考下图红圈标注位置:
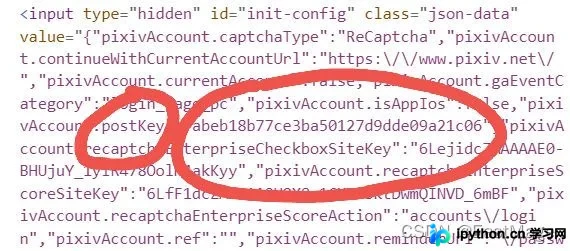
我们可以直接使用正则表达式进行爬取:
def get_postkey():
    login_url='https://accounts.pixiv.net/login?return_to=https%3A%2F%2Fwww.pixiv.net%2F&lang=zh&source=pc&view_type=page'
    response=requests.get(url=login_url,headers=headers,verify=False)
    html=response.text
    # print(html)
    postkey=re.findall('"pixivAccount.postKey":"(.*?)","pixivAccount.recaptchaEnterpriseCheckboxSiteKey"',html)
    return postkey[0]
随后即可构建数据包:
pixiv_id="账号" # 你的pixiv账号
password='xxxxx' # 你的pixiv密码
return_to='https://www.pixiv.net/'
post_key=get_postkey()
实例化Session对象,提交POST请求即可完成模拟登录:
session=requests.Session()

form_data={
    'pixiv_id':pixiv_id,
    'password':password,
    'return_to':return_to,
    'post_key':post_key
}
login_url1='https://accounts.pixiv.net/login?return_to=https%3A%2F%2Fwww.pixiv.net%2F&lang=zh&source=pc&view_type=page'
res=session.post(url=login_url1,headers=headers,data=form_data)
# 至此模拟登录成功
爬取排行榜图片及处理防盗链
至此模拟登录环节已成功,接下来开始爬取目标图片,此处以爬取排行榜为例:
打开排行榜页面,鼠标悬停在图片上并右键检查元素,即可找到对应的代码位置:
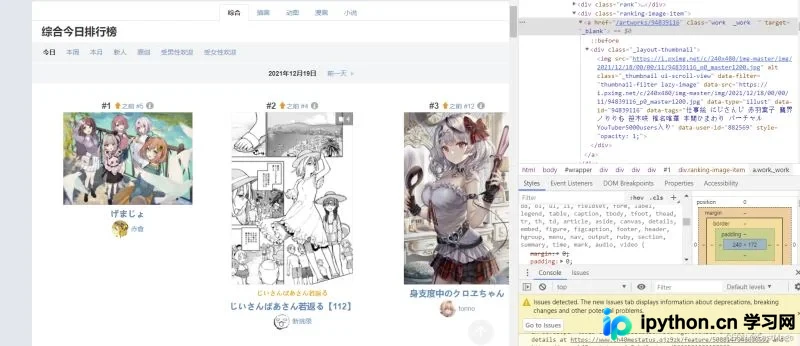
识别每张图片的相似DOM结构,利用BeautifulSoup定位节点,再通过正则表达式提取所需的网址:
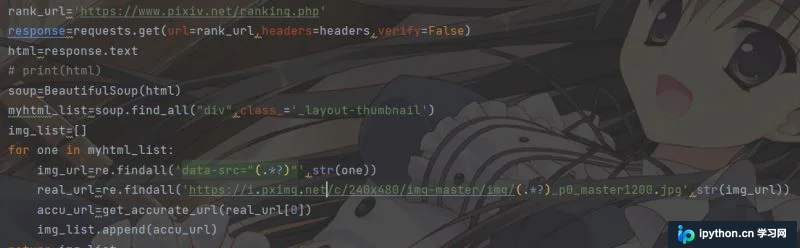
首先定位包含每张图片信息的节点,通过类名查找,随后对每个节点进行正则提取,获取图片的下载链接。需特别注意,Pixiv直接显示的图片源地址往往不可用,真正的图片链接格式应为:
https://i.pximg.net/img-original/img/xxxx/xx/xx/xx/xx/xx/xxxxxxxx_p0.png
若直接复制该网址至浏览器访问,会返回403错误,因为Pixiv限制了必须从Pixiv网页发起对该地址的请求。因此,我们首先必须在Headers中构建Referer字段,然后在从排行榜提取信息后,手动构建正确的图片网址:
headers = {'Referer': 'https://www.pixiv.net/',

           }
def get_accurate_url(url):
urll='https://i.pximg.net/img-original/img/' + str(url) + "_p0.jpg"
return urll此处代码简化处理,将所有图片统一视为jpg格式,在下载阶段再区分处理png文件。
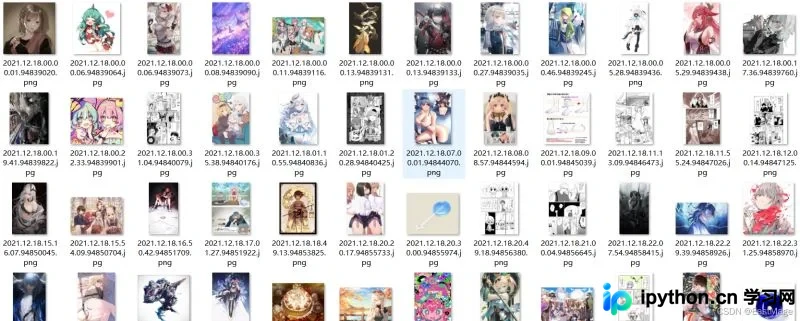
下载的具体函数实现中,我们提取每个网址的后续部分作为文件名,并随机睡眠1至4秒,以防止Pixiv识别出爬虫行为导致IP被封。随后对网址发起访问并下载,若返回状态码为404,则说明该图片实际为png格式,需重新构建正确的png网址进行下载:
def download(list,filename):
    i=1
    for url in list:
        pic_name=re.findall("https://i.pximg.net/img-original/img/(.*?)_p0.jpg",str(url))
        pic_name1=str(pic_name[0]).replace("/",".")
        r = random.randint(1, 4)
        time.sleep(r)
        response=requests.get(url=url,headers=headers,verify=False)
        if(response.status_code==404):
            the_url='https://i.pximg.net/img-original/img/' + str(pic_name[0]) + "_p0.png"
            response = requests.get(url=the_url, headers=headers, verify=False)
            with open(path + filename + '/' + str(pic_name1) + '.png', 'wb') as f:
                f.write(response.content)
                print("第" + str(i) + "张图片已下载成功!!")
        else:
            with open(path + filename + '/' + str(pic_name1) + '.jpg', 'wb') as f:
                f.write(response.content)
                print("第" + str(i) + "张图片已下载成功!!")
        i+=1
最终成功下载排行榜图片:
常见问题与注意事项
此外,在爬取过程中发现,Pixiv部分网页(包括各Tag页面及单个ID图片页面)会隐藏body部分内容。起初怀疑是未登录导致,但登录后该现象依然存在。推测可能是body内容通过子网页或JavaScript动态生成,前端实现方式多样,此部分后续再研究具体爬取方法。
总结
本文介绍了Python爬取Pixiv图片的实战项目,包括模拟登录与图片下载的核心步骤。更多相关Python爬取Pixiv图片的内容,欢迎搜索本站历史文章或继续浏览后续文章,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















