


Python常用编码的区别介绍

发布时间:2026-10-15 |
5人浏览过
本文详细解析Python中常见的四种编码格式:ASCII、Unicode、UTF-8及GBK。从Python2默认ASCII到Python3默认UTF-8的演变出发,阐述各编码的字节占用、适用范围及存储效率差异,帮助开发者理解字符编码原理并解决乱码问题。
Python编码基础与演变
Python 2版本默认使用ASCII编码处理内容,而Python 3版本则默认采用UTF-8编码。编码差异并非Python独有,所有编程语言均可能面临乱码挑战。本文重点梳理四种常见编码格式的核心区别。
主要涉及以下编码类型:
常见编码格式详解
1、ASCII
ASCII码采用单字节编码,涵盖范围主要限于英文字母、数字及部分特殊符号,总计包含256个字符。
2、Unicode
Unicode俗称万国码,旨在将所有语言的字符统一纳入单一编码体系,从而克服ASCII码的限制并解决乱码问题。
Unicode编码通常使用两个字节表示一个字符,对于特别生僻的字符则使用四个字节表示。
3、UTF-8
统一使用Unicode编码虽消除了乱码问题,但若文本主要为英文,Unicode编码所需的存储空间是ASCII编码的两倍,导致存储和传输效率低下。
UTF-8应运而生,它是一种可变长编码方式:英文字符采用ASCII编码,占用一个字节;常用汉字占用三个字节;生僻字则占用4至6个字节。
4、GBK
GBK专用于汉字编码,全称为《汉字内码扩展规范》,采用双字节编码方式。
编码对比总结
介绍完上述四种编码后,通过一张包含五种常见编码的对比图,可以更直观地理解它们之间的区别。
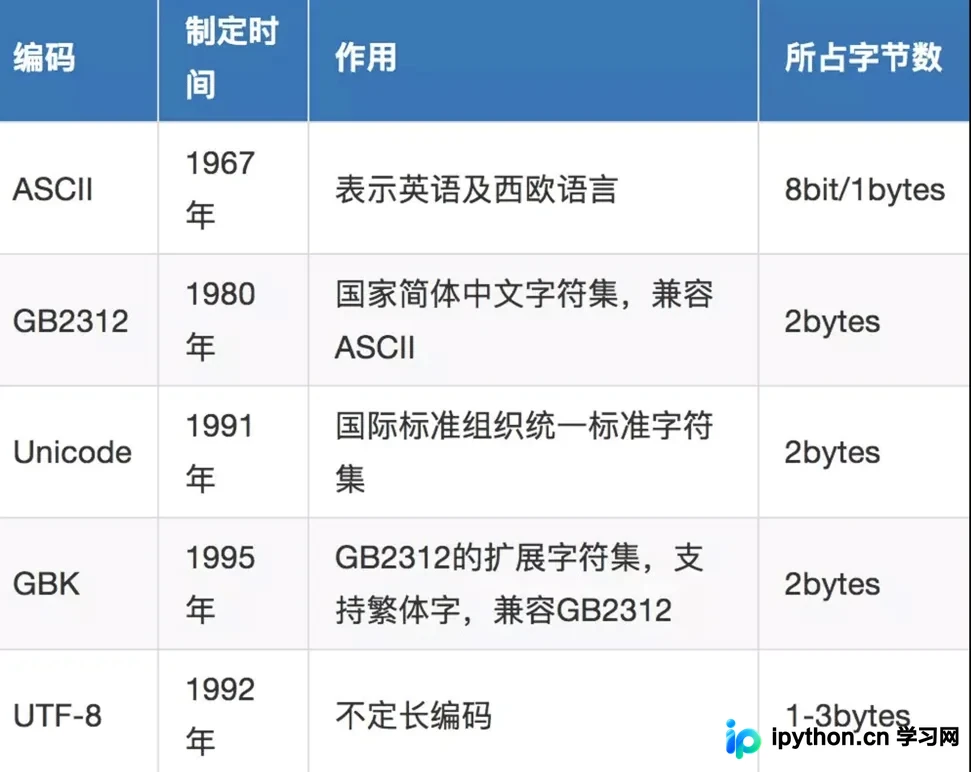
至此,关于Python常用编码区别的介绍已完成。希望本文能对您的学习有所帮助,也欢迎大家继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















