


利用Python通过商品条形码查询商品信息的实现示例

本文介绍如何使用Python编写爬虫程序,通过调用第三方条形码查询网站接口来获取商品信息。文章详细讲解了日志模块的配置、利用ddddocr库识别数字验证码的方法,以及处理HTTP请求和JSON响应的完整代码逻辑。通过具体案例演示了从输入条形码到获取商品名称、厂商及价格的全过程,旨在帮助开发者练习网络爬虫技术并了解商品信息查询的实现原理。
需要说明的是,本文侧重于技术原理的讲解,因此代码结构为了清晰展示被拆分。如果需要直接使用完整的可运行代码,请访问提供的链接进行下载:完整代码下载
一 商品条形码
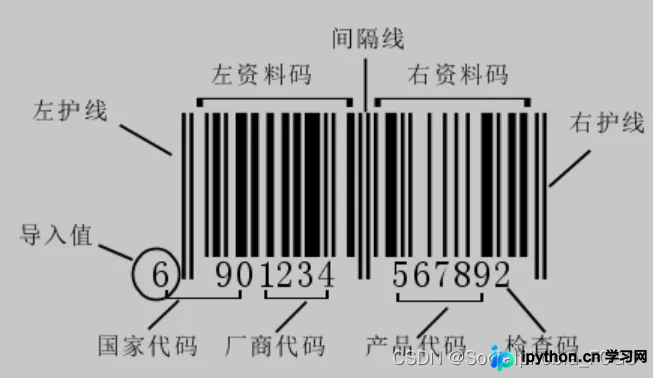
在日常生活中,消费者购买的各种商品,包括饮料、食品、药品及日用品等,其包装上通常都印有条形码。
商品条形码体系涵盖了零售商品、非零售商品、物流单元以及位置代码和条码标识。我国采用国际通用的商品代码及条码标识体系,并大力推广商品条形码的应用,以建立完善的国内商品标识系统。
零售商品特指在零售终端通过POS机扫描结算的商品。其条码标识由全球贸易项目代码(GTIN)及对应的条码符号构成,主要采用EAN/UPC条码格式。例如,一听啤酒、一瓶洗发水和一瓶护发素的组合包装,可作为单一零售商品向最终消费者销售。
总体而言,市面上流通的每一种商品都拥有其专属的商品条形码。
二 查询商品条形码的目的
从技术角度而言,本示例利用Python通过商品条形码查询商品信息,主要目的是练习网络爬虫技术。从实际应用角度,该项目可用于验证所购商品的信息,确保商品来源及成分的真实可靠。
三 Python实现
3.1 爬取网站介绍
目标网站链接如下:条形码查询网站。网站界面截图如下:
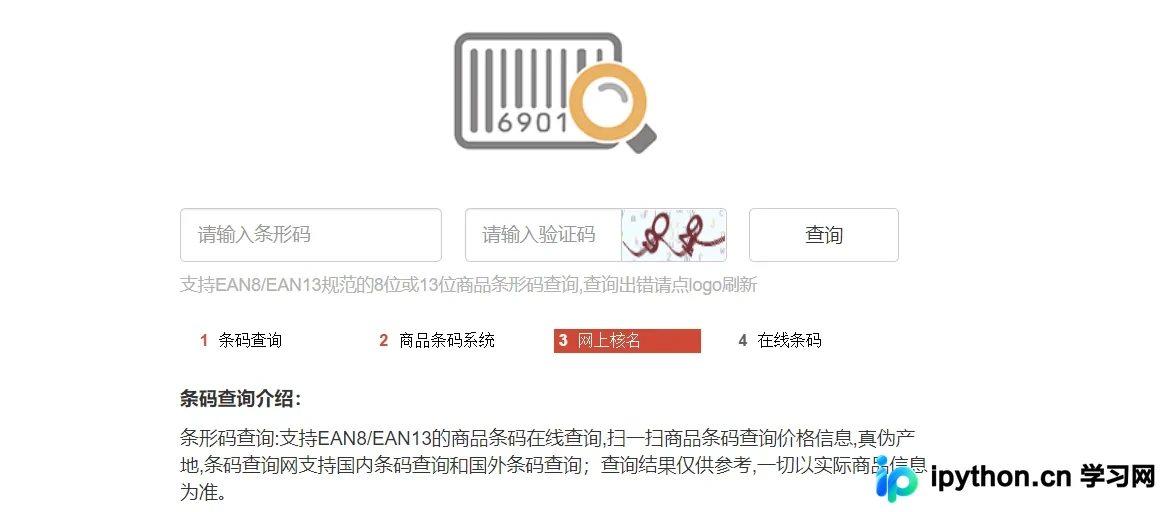
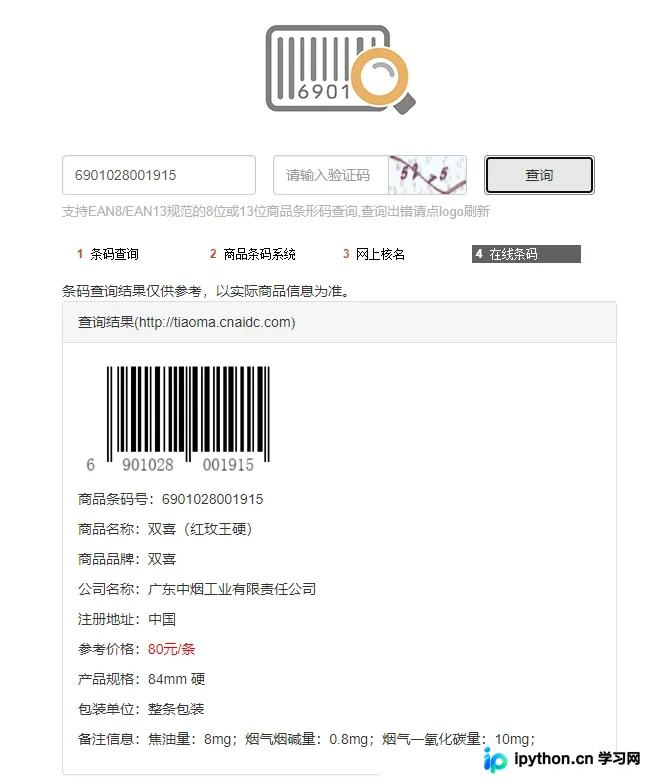
观察可知,在该网站中查询商品信息时,需输入商品条形码及验证码,随后点击查询按钮即可获取结果。以条形码“6901028001915”为例进行一次查询,截图如下:
3.2 python代码实现
3.2.1 日志模块
为了保存操作记录,项目中引入了日志模块,具体代码如下:
import logging
import logging.handlers
'''
日志模块
'''
LOG_FILENAME = 'msg_seckill.log'
logger = logging.getLogger()


def set_logger():
    logger.setLevel(logging.INFO)
    formatter = logging.Formatter('%(asctime)s - %(process)d-%(threadName)s - '
                                  '%(pathname)s[line:%(lineno)d] - %(levelname)s: %(message)s')
    console_handler = logging.StreamHandler()
    console_handler.setFormatter(formatter)
    logger.addHandler(console_handler)
    file_handler = logging.handlers.RotatingFileHandler(
        LOG_FILENAME, maxBytes=10485760, backupCount=5, encoding="utf-8")
    file_handler.setFormatter(formatter)
    logger.addHandler(file_handler)

set_logger()
3.2.2 查询模块
根据前述截图,网站查询功能需要数字验证码验证,因此本例使用ddddocr包来识别验证码。相关包的导入代码如下:
from logging import fatal
import ddddocr
import requests
import json
import os
import time
import sys
from msg_logger import logger
以下是项目的核心代码,整个操作逻辑已在代码注释中详细说明:
headers = {'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/94.0.4606.81 Safari/537.36'}
path = os.path.abspath(os.path.dirname(sys.argv[0]))

# json化
def parse_json(s):
    begin = s.find('{')
    end = s.rfind('}') + 1
    return json.loads(s[begin:end])

# 创建目录
def mkdir(path):
     # 去除首位空格
    path = path.strip()
    # 去除尾部 \ 符号
    path = path.rstrip("\\")
    # 判断路径是否存在
    isExists=os.path.exists(path)
    # 判断结果
    if not isExists:
        os.makedirs(path)
        logger.info(path + ' 创建成功')
        return True
    else:
        # 如果目录存在则不创建,并提示目录已存在
        logger.info(path + ' 目录已存在')
        return False

# 爬取 "tiaoma.cnaidc.com" 来查找商品信息
def requestT1(shop_id):
    url = 'http://tiaoma.cnaidc.com'
    s = requests.session()

    # 获取验证码
    img_data  = s.get(url + '/index/verify.html?time=',  headers=headers).content
    with open('verification_code.png','wb') as v:
        v.write(img_data)

    # 解验证码
    ocr = ddddocr.DdddOcr()
    with open('verification_code.png', 'rb') as f:
        img_bytes = f.read()
    code = ocr.classification(img_bytes)
    logger.info('当前验证码为 ' + code)
    # 请求接口参数
    data = {"code": shop_id, "verify": code}
    resp = s.post(url + '/index/search.html',headers=headers,data=data)
    resp_json = parse_json(resp.text)
    logger.info(resp_json)

    # 判断是否查询成功
    if resp_json['msg'] == '查询成功' and resp_json['json'].get('code_img'):
        # 保存商品图片
        img_url = ''
        if resp_json['json']['code_img'].find('http') == -1:
            img_url =  url + resp_json['json']['code_img']
        else:
            img_url =  resp_json['json']['code_img']

        try:
            shop_img_data  = s.get(img_url,  headers=headers, timeout=10,).content
             # 新建目录
            mkdir(path + '\\' + shop_id)
            localtime = time.strftime("%Y%m%d%H%M%S", time.localtime())
            # 保存图片
            with open(path + '\\' + shop_id + '\\' + str(localtime) +'.png','wb') as v:
                v.write(shop_img_data)
            logger.info(path + '\\' + shop_id + '\\' + str(localtime) +'.png')
        except requests.exceptions.ConnectionError:
            logger.info('访问图片URL出现错误!')

    if resp_json['msg'] == '验证码错误':
        requestT1(shop_id)

    return resp_json
3.2.3 运行结果
if __name__ == "__main__":
    try:
        dict_info = requestT1('6901028001915')['json']
        print(dict_info['code_sn'])
        print(dict_info['code_name'])
        print(dict_info['code_company'])
        print(dict_info['code_address'])
        print(dict_info['code_price'])
    except:
        print('商品无法查询!')
尝试运行代码,以“6901028001915”为例,查看运行结果:
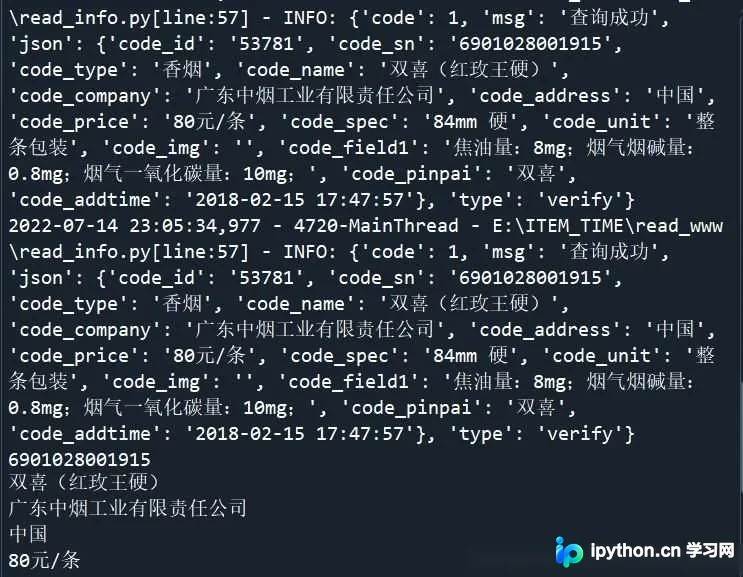
结果显示商品信息已成功查询并输出。
至此,关于利用Python通过商品条形码查询商品信息的介绍完毕。如需了解更多相关内容,请搜索本站过往文章或继续浏览后续文章。感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















