


Pandas sort_values() 参数详解与排序实战

发布时间:2026-10-15 |
3人浏览过
本文深入解析Pandas中sort_values()函数的核心用法,涵盖by、axis、ascending等关键参数的配置细节。通过Series与DataFrame的实例演示,展示单列、多列及混合升降序的排序技巧,并补充处理缺失值、原地修改及索引重置等高级操作,帮助开发者高效实现数据排序需求。
sort_values() 参数详解
sort_values() 是 Pandas 中用于对数据进行排序的核心方法。
DataFrame.sort_values(by,
               axis=0,
               ascending=True,
               inplace=False,
               kind='quicksort',
               na_position='last', # last,first;默认是last
               ignore_index=False,
               key=None)
该函数支持丰富的参数配置,具体说明如下:
- by:指定排序依据的列名或索引,支持传入单个字符串或多个字符串组成的列表。
- axis:定义排序方向,0 表示按行排序(即对列索引操作),1 表示按列排序,默认值为 0。
- ascending:控制排序顺序,True 为升序,False 为降序,默认按升序排列。
- inplace:布尔值,若为 True 则直接在原数据对象上修改,不返回新对象;若为 False 则返回排序后的新对象,默认值为 False。
- kind:指定排序算法,可选值包括 'quicksort'(快排)、'mergesort'(归并)、'heapsort'(堆排)和 'stable'(稳定排序),默认使用 'quicksort'。
- na_position:决定缺失值(NaN)的位置,可选 'first' 或 'last',默认将缺失值置于末尾。
- ignore_index:布尔值,若为 True 则忽略原有索引,新生成的数据框索引将从 0 开始重新排列;若为 False 则保留原索引,默认值为 False。
- key:接收一个函数或 lambda 表达式,在排序前对数据进行预处理或转换。
sort_values() 主要用于数值型数据的排序,数值按大小比较;对于字符型数据,则按字母顺序进行排序。
该方法同时适用于 Series 和 DataFrame 对象。
Series 与 DataFrame 排序实战
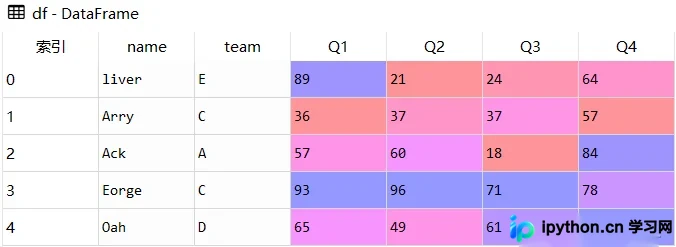
import pandas as pd

df = pd.DataFrame([['liver','E',89,21,24,64],
                   ['Arry','C',36,37,37,57],
                   ['Ack','A',57,60,18,84],
                   ['Eorge','C',93,96,71,78],
                   ['Oah','D',65,49,61,86]
                  ],
                   columns = ['name','team','Q1','Q2','Q3','Q4'])

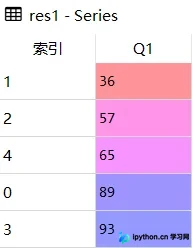
res1 = df.Q1.sort_values()

# DataFrame 需要传入一个或多个排序的列名
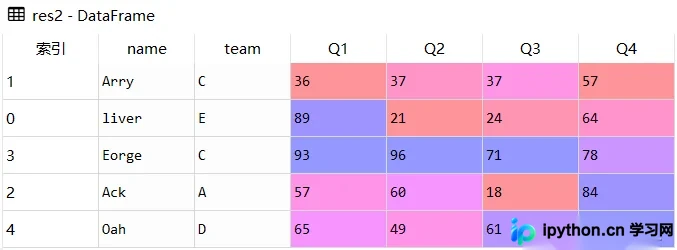
res2 = df.sort_values('Q4')

# 默认排序是升序,但可以指定排序方式
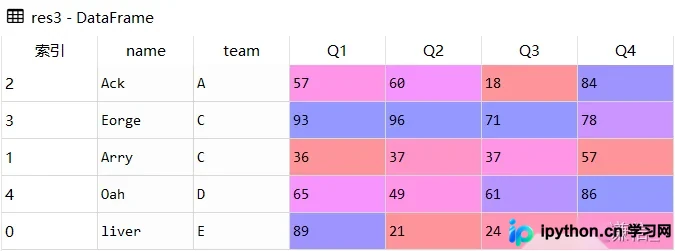
# 下例先按team升序排列,如遇到相同的team再按name降序排列
res3 = df.sort_values(by = ['team','name'], ascending = [True, False])
以下是具体的代码执行结果展示:
原始数据帧 df 如下:
对 Q1 列进行排序的结果 res1:
对 DataFrame 按 Q4 列排序的结果 res2:
先按 team 升序、再按 name 降序的多列排序结果 res3:
其他常用排序技巧与注意事项:
高级排序技巧与补充
# 其他常用方法如下:
s.sort_values(ascending = False) # 降序
s.sort_values(inplace = True) # 修改生效
s.sort_values(na_position = 'first') # 空值在前
# df按指定字段排列
df.sort_values(by = ['team'])
df.sort_values('Q1')
# 按多个字段,先排team,在同team内再看Q1
df.sort_values(by = ['mean','Q1'])
# 全降序
df.sort_values(by = ['mean','Q1'], ascending = False)
# 对应指定team升Q1降
df.sort_values(by = ['mean','Q1'], ascending = [True, False])
以上就是关于 Pandas 中 sort_values() 函数的详细用法介绍。如需了解更多相关技巧,建议查阅本站历史文章或继续关注后续更新,感谢支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















