


Python爬虫模拟登录:利用百度智能云API实现图片验证码自动识别

本文详解如何在Python爬虫中通过百度智能云文字识别API解决图片验证码问题。内容涵盖从创建应用获取凭证、安装baidu-aip库,到使用Pillow库进行图像二值化预处理以提高识别率,最后调用handwriting接口完成自动登录的全过程。
爬虫模拟登录中的验证码挑战
在使用爬虫对门户网站进行模拟登录时,经常会遇到需要输入图片验证码的情况,例如常见的图形验证码场景。
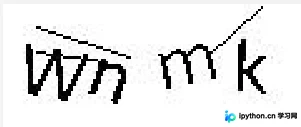
解决方案:百度智能云OCR集成
要实现全自动的模拟登录,关键在于解决验证码识别问题。本文采用百度智能云的文字识别功能,该服务每日提供数百次免费调用额度,识别效果对于一般应用场景已足够使用。
接下来介绍具体的实施步骤。
应用创建与凭证获取
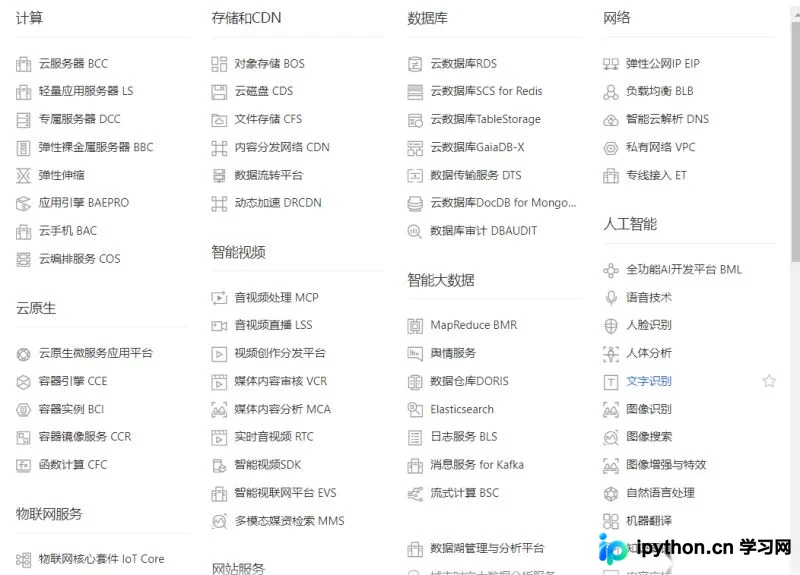
首先,访问百度智能云官网(https://cloud.baidu.com/)并登录账号。进入人工智能板块下的文字识别服务,创建一个新的应用。
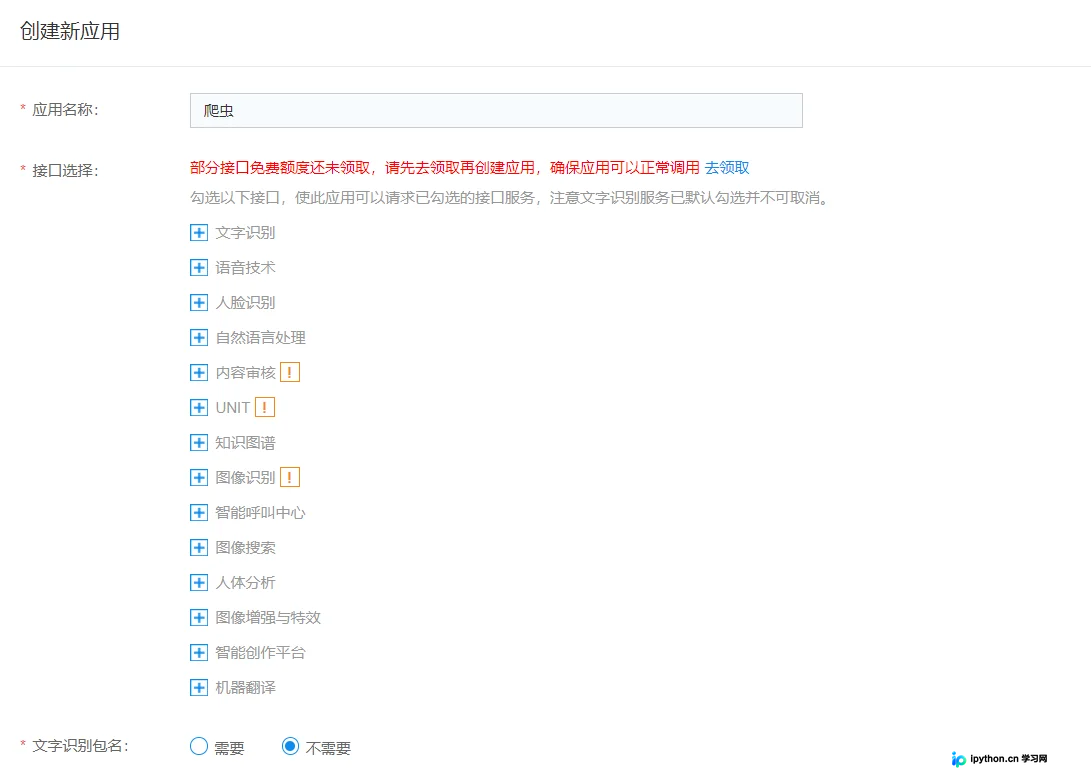
在应用创建页面,随意填写应用名称和描述,点击“立即创建”即可。
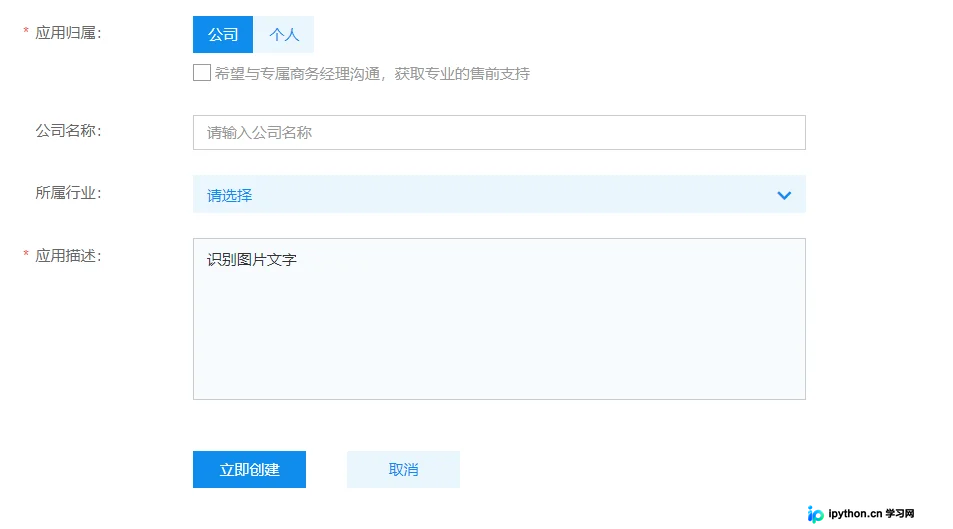
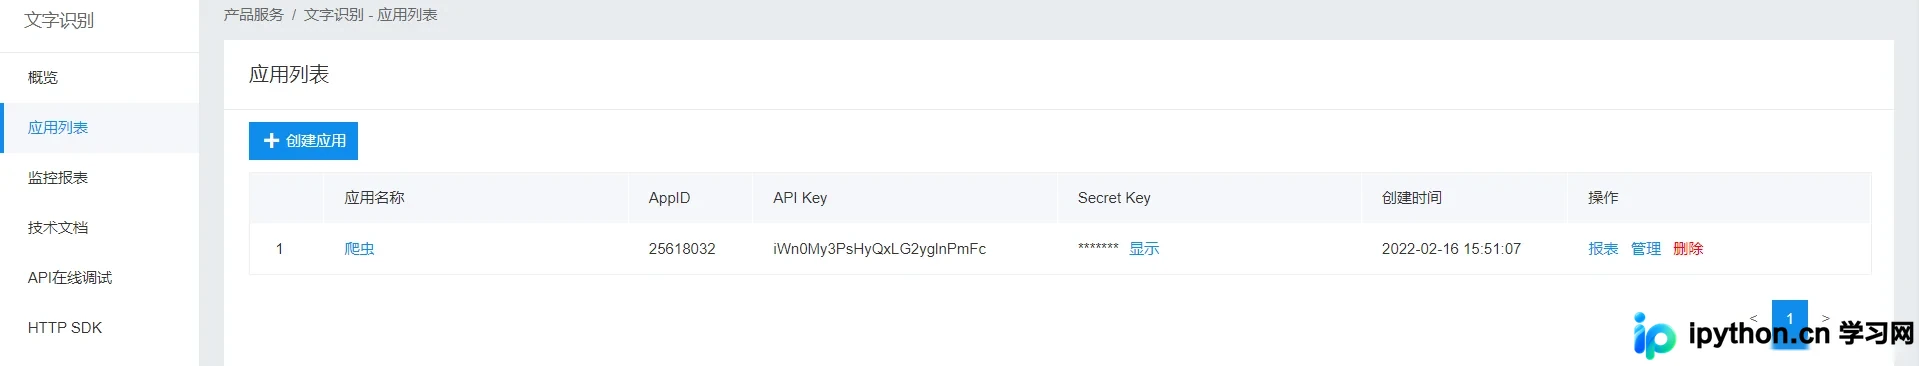
应用创建成功后,系统将生成并显示AppID、API Key和Secret Key,请妥善保存这些信息。
环境配置与API初始化
随后,在PyCharm开发环境中安装baidu-aip库,并在代码中导入AipOcr包以调用相关功能。
from aip import AipOcr #aip在baidu-aip中接下来,使用获取到的凭证初始化百度API客户端。
#百度API
APP_ID = '你的之前拿到的AppID'
API_KEY = '你的之前拿到的API Key'
Secret_Key = '你的之前拿到的Secret Key'
图像预处理:二值化处理
为了提高识别准确率,需先将下载的图片验证码进行二值化处理。
此过程需要安装pillow库,并导入其中的Image模块。
from PIL import Image #PIL在pillow库中 #图片处理
# 二值化处理 灰度阈值设为127,高于这个值的点全部填白色
img_old = Image.open('code.jpg')
img_old = img_old.convert('L') # 灰度图 模式“L” 每个像素用8个bit表示,0表示黑,255表示白
threshld = 127 #设置阈值,图片的像素范围(0,255)
table = []
for i in range(256):
if i <threshld:
table.append(0)
else:
table.append(1)
img_old = img_old.point(table,'1') # 对图像像素操作 模式“1” 为二值图像,非黑即白。但是它每个像素用8个bit表示,0表示黑,255表示白
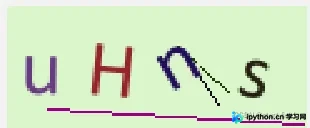
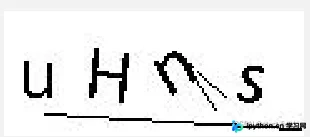
img_old.save('code.jpg')对于包含干扰线或明暗交替复杂的图片验证码,二值化处理能有效去除背景干扰,提升识别精度。
若图片中干扰线较少且无明显明暗交替,处理前后的视觉差异可能不显著,此处展示对比旨在说明处理原理。
处理前与处理后的效果对比如下所示。
调用OCR接口与完整代码示例
完成预处理后,调用baidu_aip.handwriting接口读取图片中的文字内容。
#读取处理后的验证码
with open('code.jpg','rb') as fp:
img_new = fp.read()
baidu_aip = AipOcr(APP_ID,API_KEY,Secret_Key)
result = baidu_aip.handwriting(img_new) #使用的是识别手写文字,返回一个字典,其中words_result是一个列表,里面有识别结果也是一个字典
print('验证码是:',result['words_result'][0]['words'])baidu_aip.handwriting模块提供多种文字识别方法,本文示例中使用的是手写文字识别。若该方法效果不佳,可根据实际需求选择其他识别接口。
以下是完整的实现代码。
# -- coding:UTF-8 --
import requests
from PIL import Image
from aip import AipOcr
if __name__ == "__main__":
#百度API
APP_ID = '你的之前拿到的AppID'
API_KEY = '你的之前拿到的API Key'
Secret_Key = '你的之前拿到的Secret Key'
headers = {
"user-agent": "Mozilla / 5.0(Windows NT 10.0;Win64;x64) AppleWebKit / 537.36(KHTML, likeGecko) Chrome / 97.0.4692.71Safari / 537.36Edg / 97.0.1072.55"
}
url = 'http://www.hyocr.com/captcha.php'
#下载验证码图片
session = requests.session()
img_data = session.get(url=url,headers=headers).content
with open('./code.jpg','wb') as fp:
fp.write(img_data)
    #图片处理
    # 二值化处理 灰度阈值设为127,高于这个值的点全部填白色
    img_old = Image.open('code.jpg')
    img_old = img_old.convert('L') # 灰度图 模式“L” 每个像素用8个bit表示,0表示黑,255表示白
    threshld = 127 #设置阈值,图片的像素范围(0,255)
    table = []
    for i in range(256):
        if i <threshld:
            table.append(0)
        else:
            table.append(1)
    img_old = img_old.point(table,'1') # 对图像像素操作 模式“1” 为二值图像,非黑即白。但是它每个像素用8个bit表示,0表示黑,255表示白
    img_old.save('code.jpg')
    #读取处理后的验证码
    with open('code.jpg','rb') as fp:
        img_new = fp.read()
    baidu_aip = AipOcr(APP_ID,API_KEY,Secret_Key)
    result = baidu_aip.handwriting(img_new)   #使用的是识别手写文字,返回一个字典,其中words_result是一个列表,里面有识别结果也是一个字典
    print('验证码是:',result['words_result'][0]['words'])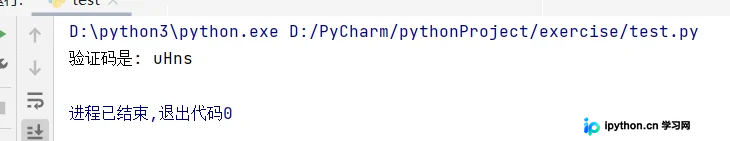
这仅是百度智能云提供的众多功能之一,建议感兴趣的用户查阅官方文档或观看相关视频教程以了解更多功能。
总结
本文介绍了Python爬虫中图片验证码的自动化识别方案。更多关于Python爬虫及图片验证码处理的技术细节,请参考本站过往文章或继续浏览后续内容,感谢支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















