


Python布尔值取反应该用not还是~

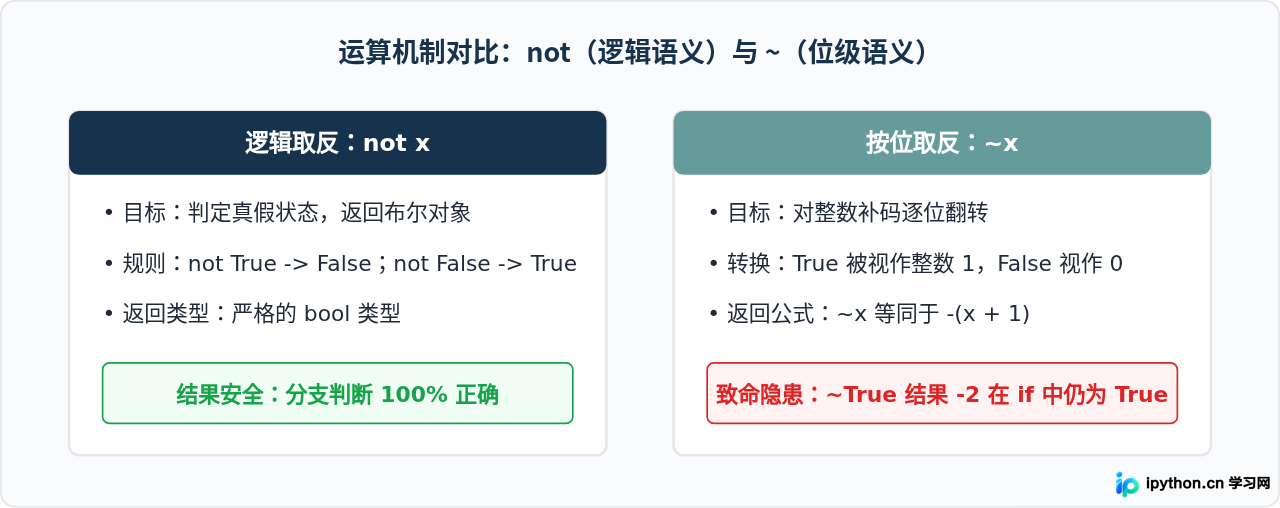
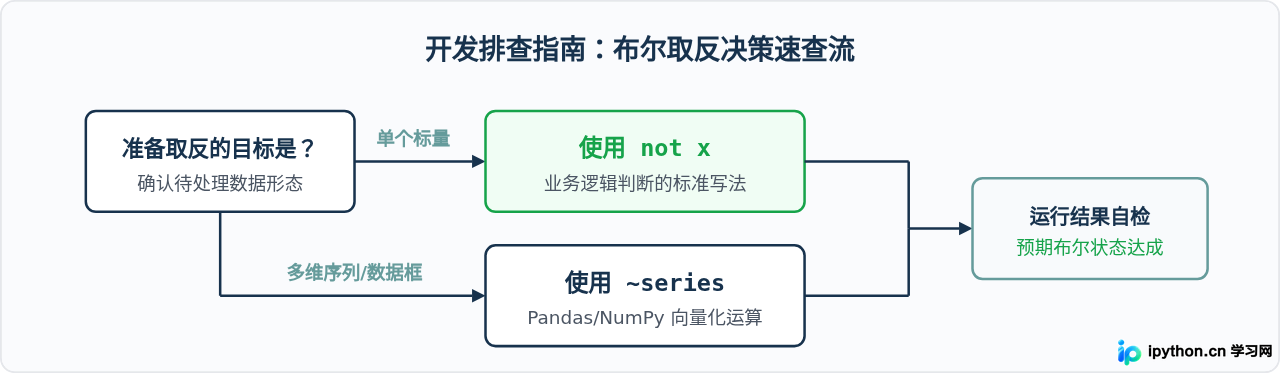
在原生Python中对单个布尔值取反,必须使用逻辑关键字 not;绝不能使用波浪号 ~。波浪号是按位取反运算符,作用于布尔值时会将其视为整数,计算结果是 -2 或 -1,而这两个非零整数在逻辑判断中都会被判定为 True,导致逻辑控制彻底失效。唯一的例外是在 NumPy 或 Pandas 中对布尔序列进行向量化取反,此时才需要使用 ~。
一、先看现象:为什么 ~True 不是 False?
很多刚从其他语言转向Python,或者刚接触位运算的开发者,容易把 ~ 当作取反符号顺手写进业务逻辑中。我们可以直接在Python交互式终端里输入以下代码,观察它们的行为差异:
# 示例代码:常规逻辑取反 vs 按位取反
val = True

print(not val)  # 输出示例: False
print(~val) # 输出示例: -2可以看到,not True 正确得到了 False,但 ~True 却输出整数 -2。更严重的问题在于随后的条件判断:
# 示例代码:条件分支判断
flag = True

if not flag:
    print("not flag 判定为真")
else:
    print("not flag 判定为假")  # 执行此处

if ~flag:
    print("~flag 判定为真")    # 竟然执行了此处!
else:
print("~flag 判定为假")运行结果显示,if ~flag 分支被执行了。这意味着原本希望在条件为假时阻断的逻辑,因为使用了 ~ 而完全失效。要理解为什么会出现这种情况,需要理清Python底层的数据模型和补码运算。
二、深层原理:bool 是 int 的子类与补码运算
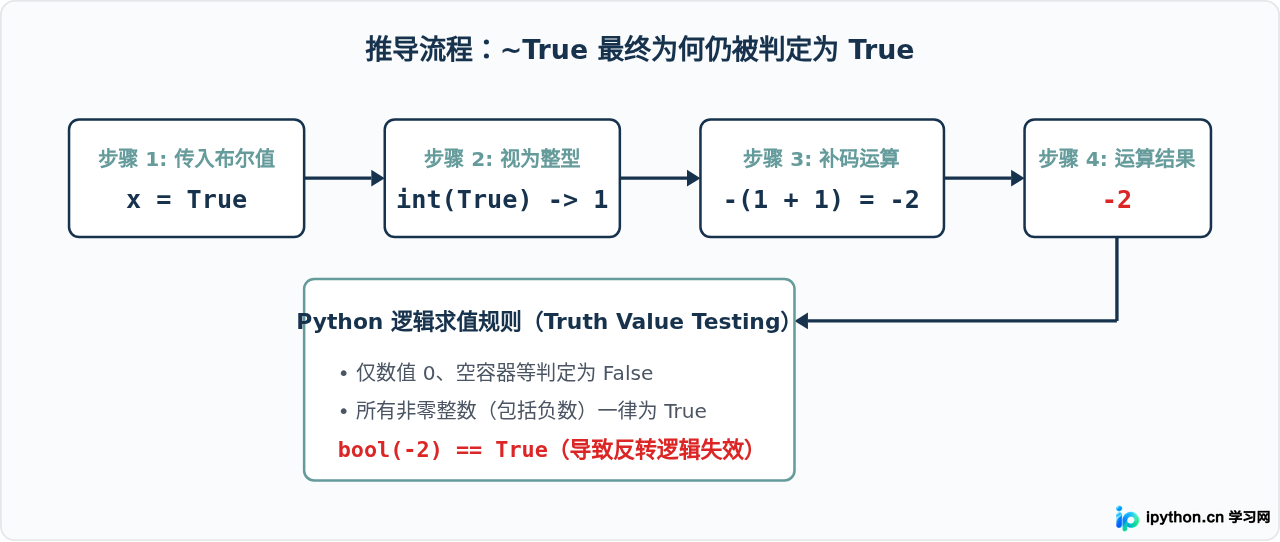
在 Python 的类型继承树中,bool 是 int 的直接子类。True 在数值上就是整型数值 1,而 False 在数值上就是整型数值 0。可以用内置函数验证这一点:
# 示例代码:验证继承关系与数值表现
print(issubclass(bool, int))  # 输出示例: True
print(isinstance(True, int))   # 输出示例: True
print(True == 1)               # 输出示例: True
print(False == 0)              # 输出示例: True
当开发者对一个变量执行 ~x 时,调用的是该对象的 __invert__() 魔法方法。因为 bool 类型并没有重写这个方法,Python 会直接继承并运行 int.__invert__(),也就是经典的整数按位取反。
计算机内部使用补码表示带符号整数。对于任意整数 $x$,其按位取反的结果严格满足公式:
~x = -(x + 1)
代入布尔值的数值表现:
- 当输入为
True(即1)时:~1 = -(1 + 1) = -2 - 当输入为
False(即0)时:~0 = -(0 + 1) = -1
而在 Python 的真值测试规则中,除了数值 0 以外,所有的非零整数都会被视作 True。因此不管是 -2 还是 -1,放入条件语句中全部都是真。无论原值是 True 还是 False,bool(~x) 永远得出 True,这正是 bug 产生的根本原因。
三、什么时候必须使用 ~?数据科学中的向量化取反
既然 ~ 不能用于普通的单个布尔值,为什么 Python 社区中还经常见到 ~ 的代码?这主要出现在科学计算库(如 NumPy 和 Pandas)中。
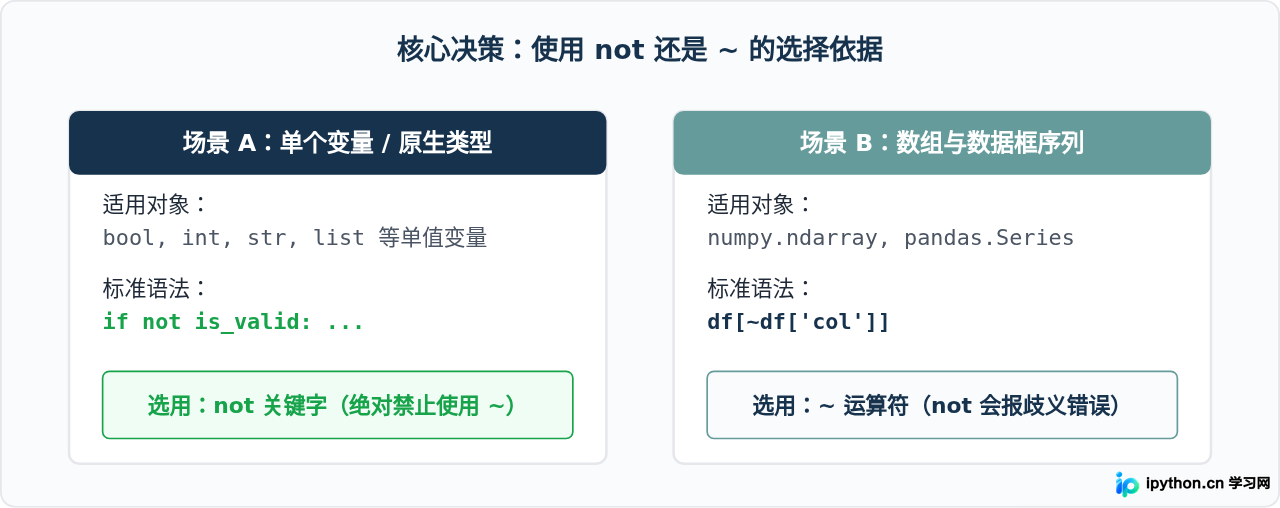
NumPy 的 ndarray 和 Pandas 的 Series 重写了 __invert__() 魔法方法。在这类数组对象上,~ 不再做标量补码取反,而是对数组中的每一个布尔元素执行并行的元素级逻辑取反。
# 示例代码:Pandas 数据筛选时的取反操作
import pandas as pd

df = pd.DataFrame({
    'name': ['Alice', 'Bob', 'Charlie'],
    'is_active': [True, False, True]
})

# 需求:筛选出未激活(is_active == False)的用户
# 正确做法:使用 ~ 进行向量化取反
inactive_users = df[~df['is_active']]
print(inactive_users)
# 输出示例:
#     name  is_active
# 1 Bob False如果把上面的代码改成
df[not df['is_active']],Python 会直接抛出错误:
ValueError: The truth value of a Series is ambiguous. Use a.empty, a.bool(), a.item(), a.any() or a.all().
因为
not 是语言级关键字,它要求将整个 Series 强制降维转化为单个布尔值,但一个包含多个元素的序列在逻辑上无法直接判定“整体是真还是假”。因此在数组级别的逐项取反中,必须使用重写过的 ~ 运算符。
四、对比与选型参考
为了在实际编码中做出正确选择,下面将两者在语法性质、底层方法、计算结果及主要用途进行对照:
| 对比维度 | not 关键字 |
~ 运算符 |
|---|---|---|
| 语法类别 | Python 内置逻辑关键字 | 一元位运算符(按位取反) |
| 底层调用 | 执行逻辑真假判断(基于 __bool__) |
调用 __invert__() 魔法方法 |
| 对 True 运算 | False(标准布尔值) |
-2(非零整数) |
| 对 False 运算 | True(标准布尔值) |
-1(非零整数) |
| 在 if 语句中 | 按逻辑值正确执行分支 | 由于结果均为非零整数,恒为 True |
| 序列向量化支持 | 不支持(抛出 ValueError) |
支持(NumPy/Pandas 逐元素逻辑翻转) |
五、总结与编码规范
回到最初的问题:“Python布尔值取反应该用not还是~?”结论非常明确:
- 常规业务开发:只要变量是常规的布尔值或普通对象,永远使用
not。编写not is_empty、not flag是语义最清晰、行为最稳定的官方标准做法。 - 禁止误用
~:切勿在单值判断中使用~,因为~True产生整数-2,其布尔真值仍然是True,会导致整个条件判断形同虚设。 - 数据分析场景:在使用 NumPy 数组或 Pandas Series 进行切片和过滤时,必须使用重写了逻辑的
~进行按位反转,因为not无法处理多元素序列。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















