


Python提取PDF表格数据实战:pdfplumber库使用指南

本文介绍如何使用Python第三方库pdfplumber从PDF文件中高效提取表格数据。通过对比pdfminer,展示pdfplumber在布局一致性和易用性上的优势。提供完整代码示例,演示如何将PDF中的获奖名单自动转换为Excel格式,并封装为可复用的函数处理多文件批量任务。
前言
本文介绍一款Python工具,用于从PDF文件中读取表格数据,核心依赖第三方库pdfplumber。
pdfplumber简介
pdfplumber是一款基于pdfminer、完全由Python开发的PDF文档解析库。它不仅能获取字符、矩形框、线条等对象的详细信息,还能直接抽取文本和表格。目前,该库仅支持可编辑的PDF文档。
尽管pdfminer也能解析可编辑的PDF文档,但相比之下,pdfplumber具备以下优势:
- 两者均可获取字符、矩形框、线条等对象的具体信息,但pdfplumber在pdfminer的基础上进行了封装和处理,生成的对象更易于使用,对用户更加友好。
- 两者均能解析文本,但pdfminer输出的文本在布局上可能与原文存在较大差异,而pdfplumber抽取的文本与原文具有更高的一致性。
- pdfplumber实现了表格抽取逻辑,基于最基本的字符、线框等对象的位置信息,定位并识别PDF文档中的表格。
首先安装
pip install pdfplumber实战案例
本次实战的目标是提取PDF中的获奖队伍信息,并将其保存到Excel表格中。
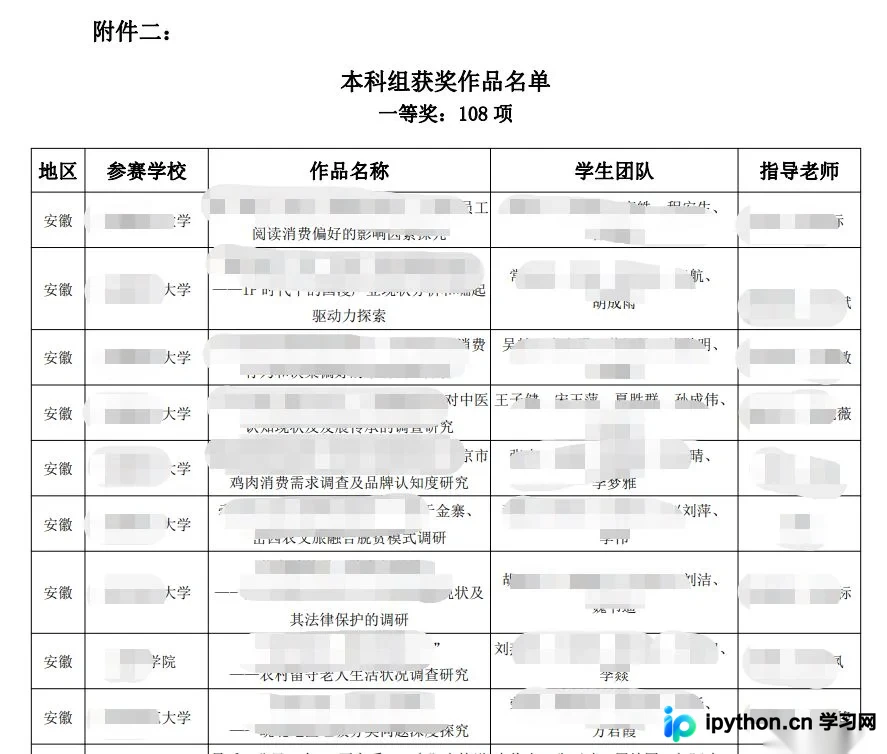
原始PDF文件中大多包含如图所示的表格,为保护个人隐私,此处已对图片进行打码处理。
接下来开始编写代码以提取表格数据。
import pandas as pd
import pdfplumber

pdf = pdfplumber.open("第十届“正大杯”国奖名单.pdf")
df = pd.DataFrame()
for i in range(3,53):  # 这里3是指表格信息是从第4页开始的(程序计数是从0开始,所以这里第4页对应程序中的3),53是结束位置
    page = pdf.pages[i]  # 读取pdf中的每一页
    table = page.extract_table()  # 从页数据中提取表格数据
    df = df.append(table)  # 将提取的数据转换为DataFrame二维表格形式
df.drop_duplicates(inplace=True)   # 删除重复值
df.to_excel("第十届“正大杯”国奖名单.xlsx", header=False, index=False)  # 将提取的数据保存为excel
这里使用循环来提取多页数据,其中3表示表格信息从第4页开始(程序计数从0开始,因此第4页对应索引3),53表示结束位置。
运行后的结果如下:
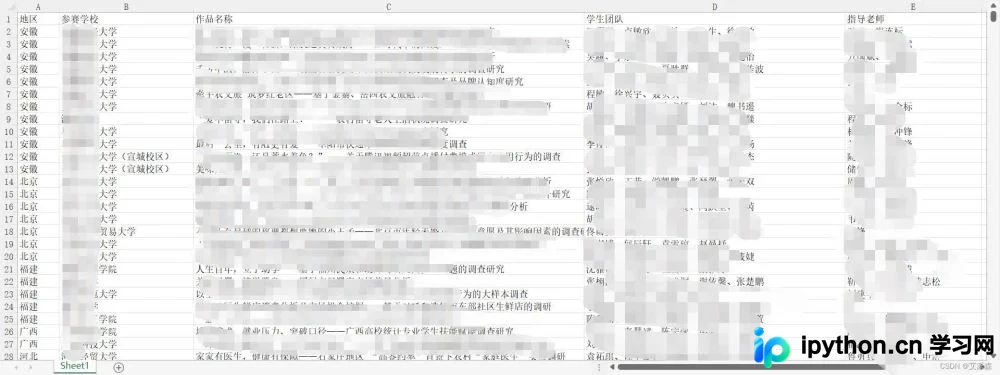
通过上述步骤,即可简单地将PDF中的表格提取出来。
至此,仅完成了一个PDF数据的提取。由于还有几个类似的PDF需要处理,因此将上述代码功能进行了简单封装(功能尚较简陋,可根据实际需求进行扩展)。
def pdf_to_excel(file_path,start:int,end:int,excel_name=None):
    '''
    params:
        file_path:需要提取表格的pdf文件的绝对路径
        start:出现表格的起始页码
        end:表格结束页码
        excel_name:最后保存excel文件的文件名(默认为原始pdf文件名)
    '''
    pdf = pdfplumber.open(file_path)
    if not excel_name:
        excel_name = file_path.split('\\')[-1].split('.')[0]
    df_result = pd.DataFrame()
    for i in range(start-1,end):
        page = pdf.pages[i]
        table = page.extract_table()
        df_result = df_result.append(table)
    df_result = df_result.drop_duplicates(inplace=True)
    df_result.to_excel(excel_name+'.xlsx',index=False)

pdf_to_excel(file_path=r'C:xxx.pdf',start=4,end=53)
以上就是本次分享的Python小工具,希望对有同样需求的读者有所帮助!
到此这篇关于如何利用Python提取pdf中的表格数据的文章就介绍到这了,更多相关Python提取pdf表格数据内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















