


Python格式化输出方法汇总:f-string、format与%操作符对比

%操作符、Python 2.6引入的str.format()方法,以及Python 3.6加入的格式化字符串字面值f-string。本文直接拆解这三种方式的具体语法规则、数字与对齐格式化控制,并从可读性、执行性能与维护成本三个维度明确它们的选择界限。
1. 演进脉络与三种语法概览
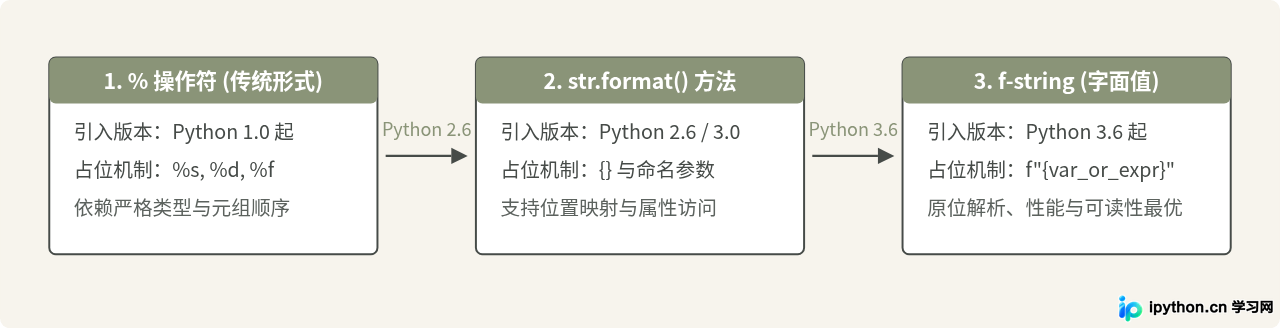
字符串格式化的本质是把数据填充至占位符中,并按照指定精度、宽度和类型进行渲染。三种语法的演进目标非常明确:从依赖参数位置匹配,逐步演变为支持命名匹配,最终发展为直接嵌入表达式求值,代码编写负担越来越低。
2. 三种格式化方式的详细用法
2.1 % 操作符(printf 风格)
% 操作符是 Python 最早的格式化方式,其语法继承自 C 语言的 printf。它使用 %s 表示字符串、%d 表示整型、%f 表示浮点型。如果需要填充多个变量,右侧必须放在一个元组(tuple)中。
name = "Alice"
score = 92.5
rank = 1

# 单个变量可以省略元组,多个变量必须封装在元组中
message = "考生:%s,得分:%d,名次:%d" % (name, score, rank)
print(message)
# 示例输出:考生:Alice,得分:92,名次:1
由于 % 操作符将右侧的元组直接展开为参数列表,当你本意是将“一个元组本身”作为一个值填入 %s 占位符时,必须将其二次打包成单元素元组,否则会抛出 TypeError: not enough arguments for format string。
point = (10, 20)
# 错误写法:会把 point 解包成两个参数,匹配单个 %s 时报错
# print("坐标是:%s" % point)

# 正确写法:嵌套一层单元素元组
print("坐标是:%s" % (point,))
# 示例输出:坐标是:(10, 20)
2.2 str.format() 方法
为了解决元组解包歧义和较差的可维护性,Python 2.6 引入了 str.format() 方法。它使用花括号 {} 作为占位符,支持按位置顺序填充、按索引位置多重引用,以及使用关键字参数传值。
item = "笔记本"
price = 45.0
qty = 3

# 1. 默认位置匹配
info1 = "商品:{},单价:{},数量:{}".format(item, price, qty)

# 2. 索引位置复用(在同一个模板中多次使用同一变量)
info2 = "{0}售价为{1}元。确认购买{0}吗?".format(item, price)

# 3. 关键字传参(清晰直观,不再依赖参数先后顺序)
info3 = "商品:{i},总价:{total}".format(i=item, total=price * qty)

print(info1)
print(info2)
print(info3)
# 示例输出:
# 商品:笔记本,单价:45.0,数量:3
# 笔记本售价为45.0元。确认购买笔记本吗?
# 商品:笔记本,总价:135.0
2.3 f-string(格式化字符串字面值)
自 Python 3.6 开始支持的 f-string(Formatted string literals)允许在字符串前添加前缀 f 或 F。在大括号 {} 内部,读者可以直接书写当前作用域内的变量名、字典取值、方法调用甚至是数学运算表达式。
user = {"username": "Bob", "role": "admin"}
login_count = 5

# 直接在表达式中访问字典、运算与调用方法
summary = f"用户 {user['username'].upper()}(身份:{user['role']}),登录次数:{login_count + 1}"
print(summary)
# 示例输出:用户 BOB(身份:admin),登录次数:6
自 Python 3.8 起,f-string 还增加了一个针对调试的实用语法:在变量或表达式后添加等号 =,即可同时输出表达式文本与计算结果,无需重复书写变量名。
x = 10
y = 25
print(f"{x=}, {y=}, {x+y=}")
# 示例输出:x=10, y=25, x+y=35
3. 精度控制、补零与对齐规范
无论是输出报表表格、格式化浮点金额,还是生成固定位数的流水号,都需要明确的格式规范说明符(Format Specifiers)。str.format() 和 f-string 遵循同一套格式规范迷你语言(在冒号 : 后定义),而 % 操作符使用其独立的标记方式。
| 需求场景 | % 操作符写法 | str.format() 写法 | f-string 写法 | 示例输出 |
|---|---|---|---|---|
| 保留两位小数 | "%.2f" % 3.14159 |
"{:.2f}".format(3.14159) |
f"{3.14159:.2f}" |
3.14 |
| 数字前置补零(宽5位) | "%05d" % 42 |
"{:05d}".format(42) |
f"{42:05d}" |
00042 |
| 千分位分隔符 | 不支持原生标记 | "{:,}".format(1000000) |
f"{1000000:,}" |
1,000,000 |
| 转为百分比(保留1位) | "%.1f%%" % (0.856 * 100) |
"{:.1%}".format(0.856) |
f"{0.856:.1%}" |
85.6% |
| 左对齐 / 居中 / 右对齐 | 仅支持 %-10s 左对齐 |
"{:<10}".format("txt")"{:^10}".format("txt")"{:>10}".format("txt") |
f'{"txt":<10}'f'{"txt":^10}'f'{"txt":>10}' |
指定字符宽度与方向 |
4. 运行时处理机制差异
为了理解为什么不同方式的性能与安全性存在差异,我们需要查看它们在 Python 解释器内部的执行链路。
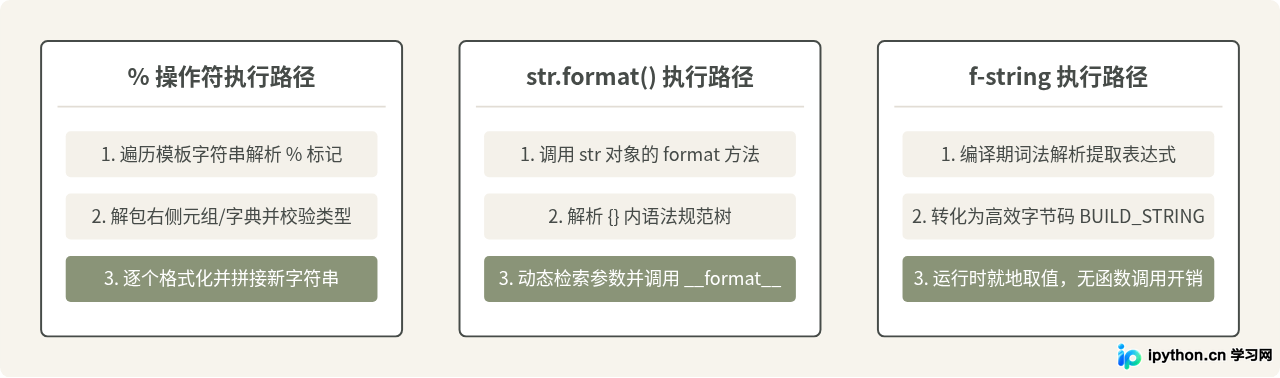
f-string 的执行速度显著优于 str.format() 和 %,原因在于它不是运行时的普通函数调用或字符串模板扫描,而是直接在编译期解析为专属的字节码指令(如 FORMAT_VALUE 和 BUILD_STRING)。解释器能够直接从局部变量表或全局变量表中加载变量并完成转换,跳过了复杂的字符串解析与参数打包流程。
5. 常见认知辨析与典型场景选择
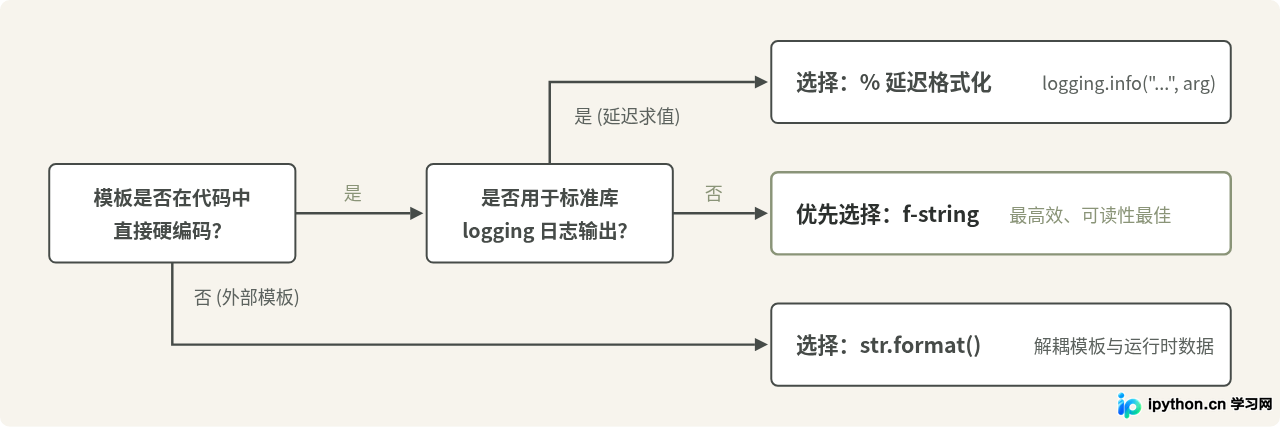
在日常开发中,常有“f-string 推出后,其他两种方式应当完全淘汰”的说法。这一观点看似合理,因为在绝大多数常规代码编写中,f-string 的直观性与性能确实处于绝对优势;但若推导为“完全不用其他两种”,则忽略了以下两个不可替代的特定条件:
-
模板需要延迟渲染或从外部加载:
f-string属于代码字面值,其内部的大括号必须在代码执行到该行时立即完成求值。如果模板文本保存在配置文件、数据库中,或者需要由系统管理员在前端界面自定义(例如国际化多语言文案、邮件通知模板),f-string无法直接作为模板读取。此时必须使用str.format()或安全模板引擎完成延迟填充。 -
标准库 logging 模块的日志记录: 在 Python 官方日志模块中使用
logging.info("User %s logged in", username)时,底层使用的是%操作符风格的延迟格式化。如果提前使用f-string拼接好字符串传给日志函数,当当前日志级别低于输出阈值(例如在生产环境禁用了 DEBUG)时,字符串拼接的 CPU 计算开销依然被提前消耗了。
6. 方案对比与总结
为了在架构设计与日常编码中快速对齐标准,三种方案的技术特征与权衡对比如下:
| 对比维度 | % 操作符 | str.format() | f-string |
|---|---|---|---|
| 支持的最低版本 | Python 1.0 | Python 2.6 / 3.0 | Python 3.6 |
| 可读性与维护度 | 较低(占位符与变量位置割裂) | 中等(命名参数时清晰) | 极高(所见即所得,支持表达式) |
| 执行效率 | 中等 | 较慢(涉及方法调用开销) | 极快(编译期优化,专用字节码) |
| 模板分离与延迟加载 | 支持 | 完整支持(适合外部配置) | 不支持(立即在当前行求值) |
| 推荐场景 | 遗留系统维护、logging 参数传值 | 配置文件读取、国际化多语言渲染 | 常规业务逻辑、数据清洗、控制台输出 |
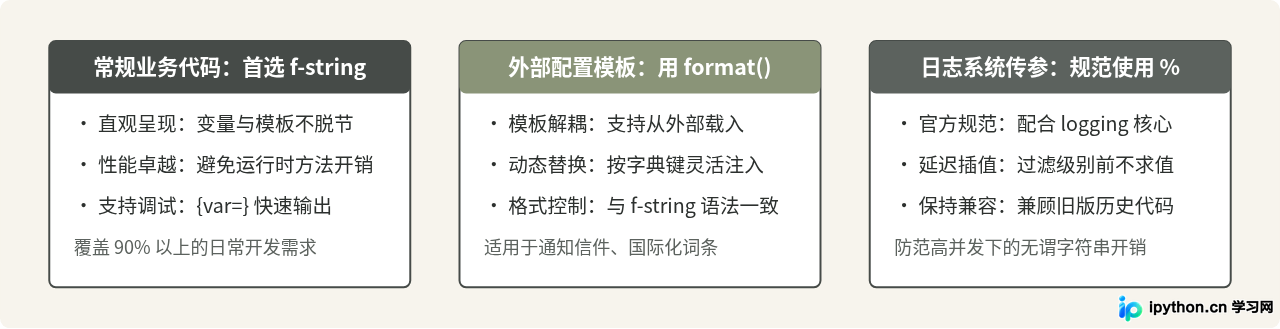
掌握 Python 格式化输出的重点不在于记住每种方式的所有边缘语法,而在于建立清晰的选型基准:在需要编写直观、快速且在当前上下文中完成的业务逻辑时,全面采用 f-string;在模板与数据分离的配置场景中,合理使用 str.format();在日志记录系统中,保留 % 参数式调用的延迟计算特性。这样既能保证代码整洁度,也能兼顾系统运行性能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















