


Python 脚本输出中文乱码与编码声明详解

发布时间:2026-10-12 |
2人浏览过
在编写 Python 脚本时,如果代码中包含中文字符,可能会遇到编码错误。本文详细解析如何通过添加编码声明和使用正确的 print 语法来输出中文,解决常见的乱码问题。
Python 脚本中的编码问题
Python 作为脚本语言,在保存文件时会检查代码的编码格式。如果脚本中包含中文字符,但未指定正确的编码声明,解释器可能会抛出编码错误。解决这一问题的核心在于明确指定文件的字符集。
添加编码声明
要在文件首行添加编码声明,以指定保存时的字符集。常见的声明方式包括:
# -*- coding: cp936 -*-:指定使用 CP936 编码,即 GBK 编码。# -*- coding: UTF-8 -*-:指定使用 UTF-8 编码,这是目前最通用的编码格式。
通过添加上述声明,可以确保 Python 解释器在读取脚本时正确识别中文字符,从而避免编码错误。
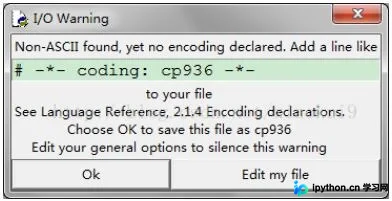
Python 输出中文的语法示例
在指定编码后,可以使用 print 语句输出中文字符串。以下是几种常见的输出方式:
print u"学习"
print (unicode("学习", encoding="utf-8"))
上述代码展示了两种输出中文的方法:一种是使用 Unicode 前缀 u,另一种是通过 unicode() 函数指定编码。这两种方法均能有效输出中文字符。
完整示例代码
以下是一个完整的 Python 脚本示例,包含编码声明和中文字符输出:
# encoding: utf-8
print 'helloworld'
print u"学习"
print (unicode("学习", encoding="utf-8"))
运行该脚本后,输出结果如下:
helloworld
学习
学习
通过上述示例,可以看到中文字符“学习”被正确输出。需要注意的是,编码声明必须位于文件的首行,否则 Python 解释器可能无法正确识别编码格式。
总结
在 Python 脚本中输出中文时,添加编码声明是解决乱码问题的关键。通过指定 UTF-8 或 GBK 编码,并结合正确的 print 语法,可以确保中文字符被正确处理和显示。希望本文能帮助开发者更好地理解和应用 Python 的编码机制。
以上就是 Python 中使用 print 输出中文的详细方法,更多关于 Python 编码与字符串处理的文章请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















