


即梦AI最新模型更新了什么?V2.0与V3.0版本功能差异解读

对于长期依赖AI进行视觉创作的用户来说,模型的迭代往往伴随着一种复杂的焦虑:是继续打磨手中已经熟悉的V2.0工作流,还是冒险跳入V3.0的新语境?这种犹豫并非多余,因为每一次底层架构的升级,都意味着提示词逻辑的重构和审美标准的迁移。即梦AI从V2.0迈向V3.0,并非简单的参数堆叠,而是一次从“听懂指令”到“理解意图”的质变。如果说V2.0是一位执行力强但偶尔死板的画师,那么V3.0则更像是一位能读懂潜台词的艺术总监。本文将剥离枯燥的技术参数,从四个核心创作场景出发,剖析这两个版本在实际应用中的真实温差。
语义理解的颗粒度:从关键词堆砌到自然语言对话
在V2.0时代,为了获得精准的画面,用户往往需要像编写代码一样罗列标签:主体、风格、光照、视角,缺一不可。一旦提示词中出现长难句或复杂的逻辑修饰,模型容易出现“顾此失彼”的现象,比如忽略了背景中的特定元素,或者混淆了主体的动作状态。这种体验迫使创作者将大量精力耗费在提示词的工程化调试上,而非创意本身。
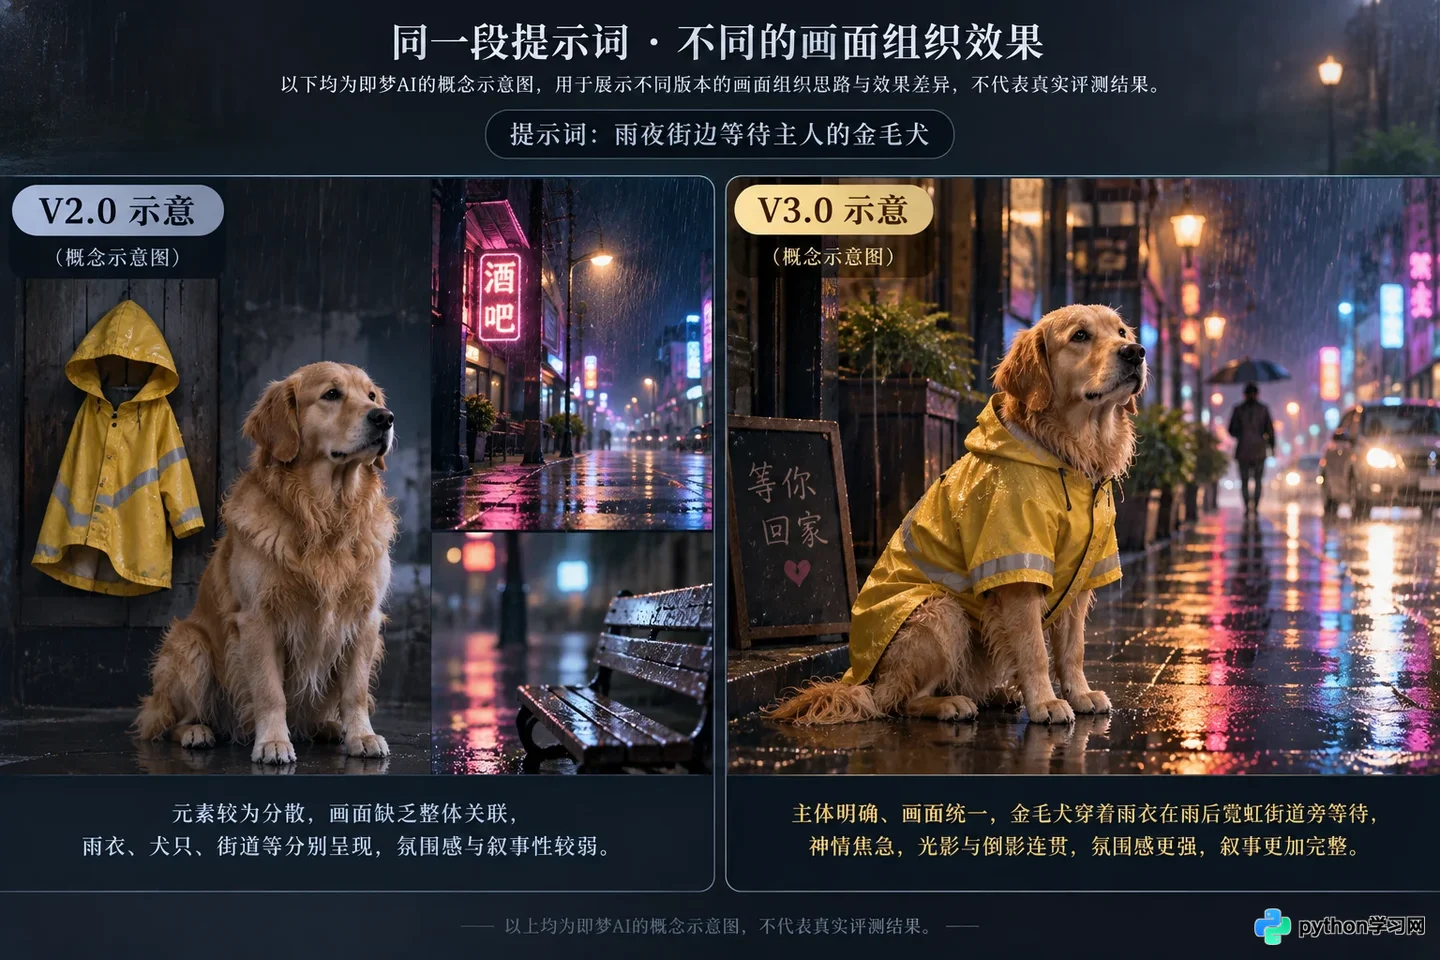
V3.0能更好地理解包含情感和复杂逻辑的自然语言描述
V3.0最直观的改进在于对自然语言的包容度。它不再机械地切割词汇,而是能够处理包含因果关系、空间方位和情感色彩的完整句子。在这种场景下,你可以尝试输入一段更具叙事性的描述,例如“一只穿着雨衣的金毛犬在雨后的霓虹街道旁等待主人,眼神中带着些许焦急”。V2.0可能会生成一只狗和一条街道,但很难同时精准呈现“雨后”、“霓虹”、“焦急眼神”这三个维度的融合;而V3.0则能更好地平衡这些要素,使画面呈现出符合语境的统一氛围。这种变化降低了入门门槛,让非专业用户也能通过日常语言表达获得高质量结果,但对于习惯精细化控制的老手而言,这意味着需要重新调整提示词的密度,避免过度描述导致的画面杂乱。
复杂构图与文字渲染:解决AI创作的“硬伤”
文字渲染和复杂手部结构一直是AI绘图的痛点。在V2.0中,虽然手部畸形率已大幅降低,但在涉及多个人物互动或精细手指动作时,仍可能出现粘连或指节错误。更明显的问题在于画面中的文字生成,V2.0通常只能生成类似文字的乱码符号,难以直接用于海报或设计稿,后期仍需依靠PS手动替换。
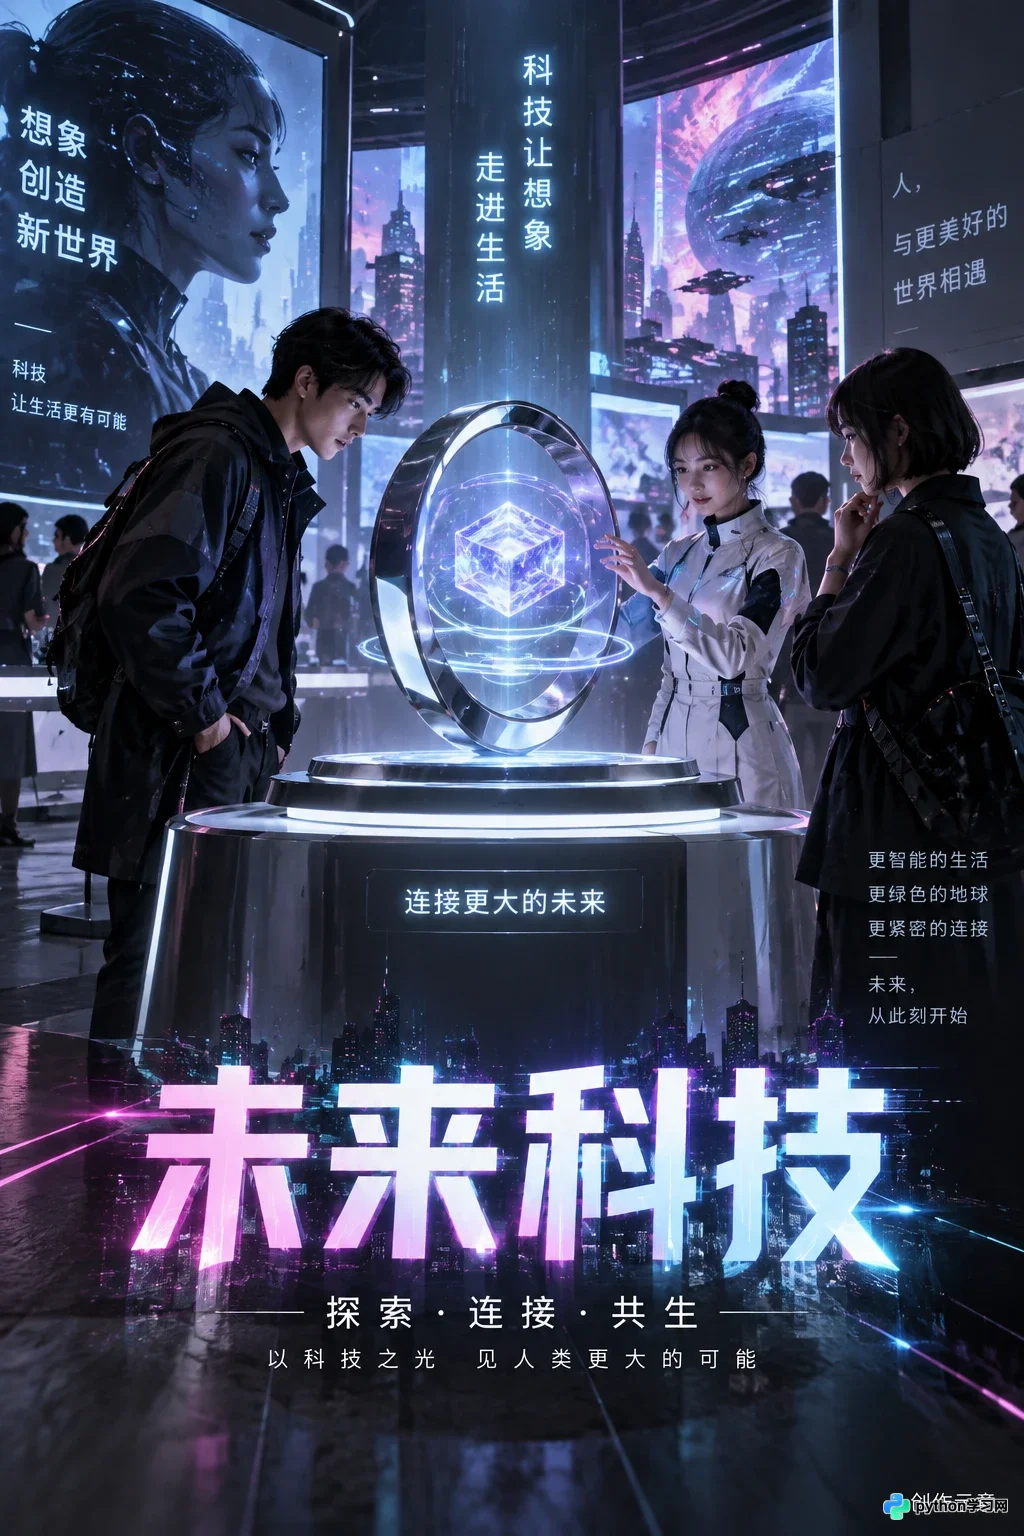
V3.0在画面文字生成和多人物空间逻辑上的改进
V3.0在这一领域引入了更强的字形控制能力。它不仅能更准确地生成指定内容的英文或简单中文字符,还能保持字体风格与画面整体艺术风格的一致性。在设计电商海报或概念图时,这一功能极大地缩短了从生成到成品的路径。此外,在处理多人物大场景时,V3.0对空间透视和人物比例的把控更加稳定。例如,在生成“会议室中五人围坐讨论”的场景时,V2.0可能会出现人物大小不一或透视扭曲的情况,而V3.0能更好地维持场景的空间逻辑,使每个人物的位置和姿态都符合物理规律。当然,这并不意味着V3.0完美无缺,在极度复杂的遮挡关系或极小字号的文字上,仍需人工介入微调,但其可用性已从“不可用”跨越到了“可用且高效”的阶段。
视频生成的连贯性:从PPT翻页到电影运镜
即梦AI的视频生成功能在V2.0时期已具备一定基础,但主要局限在于帧间闪烁和动作断裂。生成的视频往往像是一系列相似图片的快速切换,缺乏真正的运动逻辑,尤其是在人物转身或物体快速移动时,容易出现形变或背景漂移。这使得V2.0生成的视频更多适用于静态展示或短视频素材拼接,难以承担独立叙事的功能。
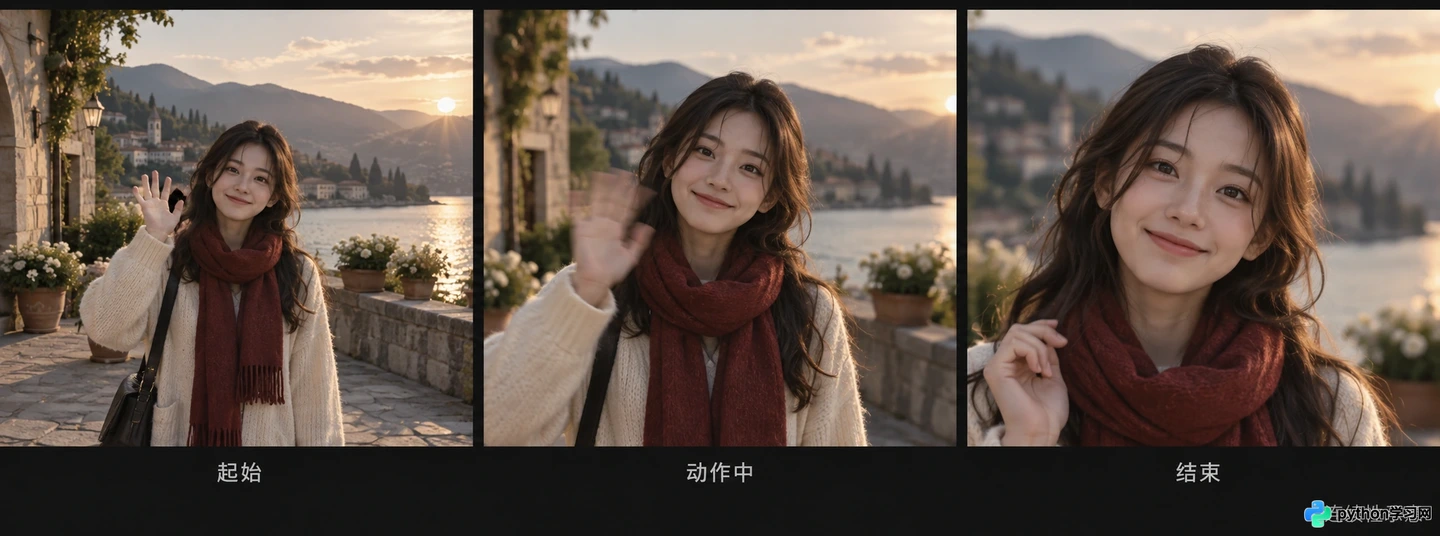
V3.0视频生成在运动逻辑和帧间稳定性上的提升
V3.0在视频生成引擎上进行了重构,显著提升了时间维度上的一致性。它不仅减少了画面的闪烁感,更重要的是增强了对运动轨迹的理解。当用户指定“镜头推近”或“人物挥手”时,V3.0能生成更平滑、符合物理惯性的动作过渡。这种改进使得AI视频开始具备初步的“电影感”,镜头语言变得更加丰富。用户可以更自信地使用运镜指令,如“环绕拍摄”或“跟随视角”,而无需担心背景崩坏。然而,视频生成的算力消耗依然巨大,且长视频的稳定性仍有上限,目前更适合生成5-10秒的高质量片段,作为创意验证或短片素材,而非直接生成长篇内容。
风格泛化与可控性:在自由与约束之间寻找平衡
V2.0提供了丰富的预设风格,如二次元、写实、油画等,但用户很难在这些固定框架外进行微调。如果想要一种“赛博朋克水墨风”的混合风格,往往需要通过多次抽卡或复杂的权重调整才能偶然命中。这种不确定性限制了商业交付的稳定性。
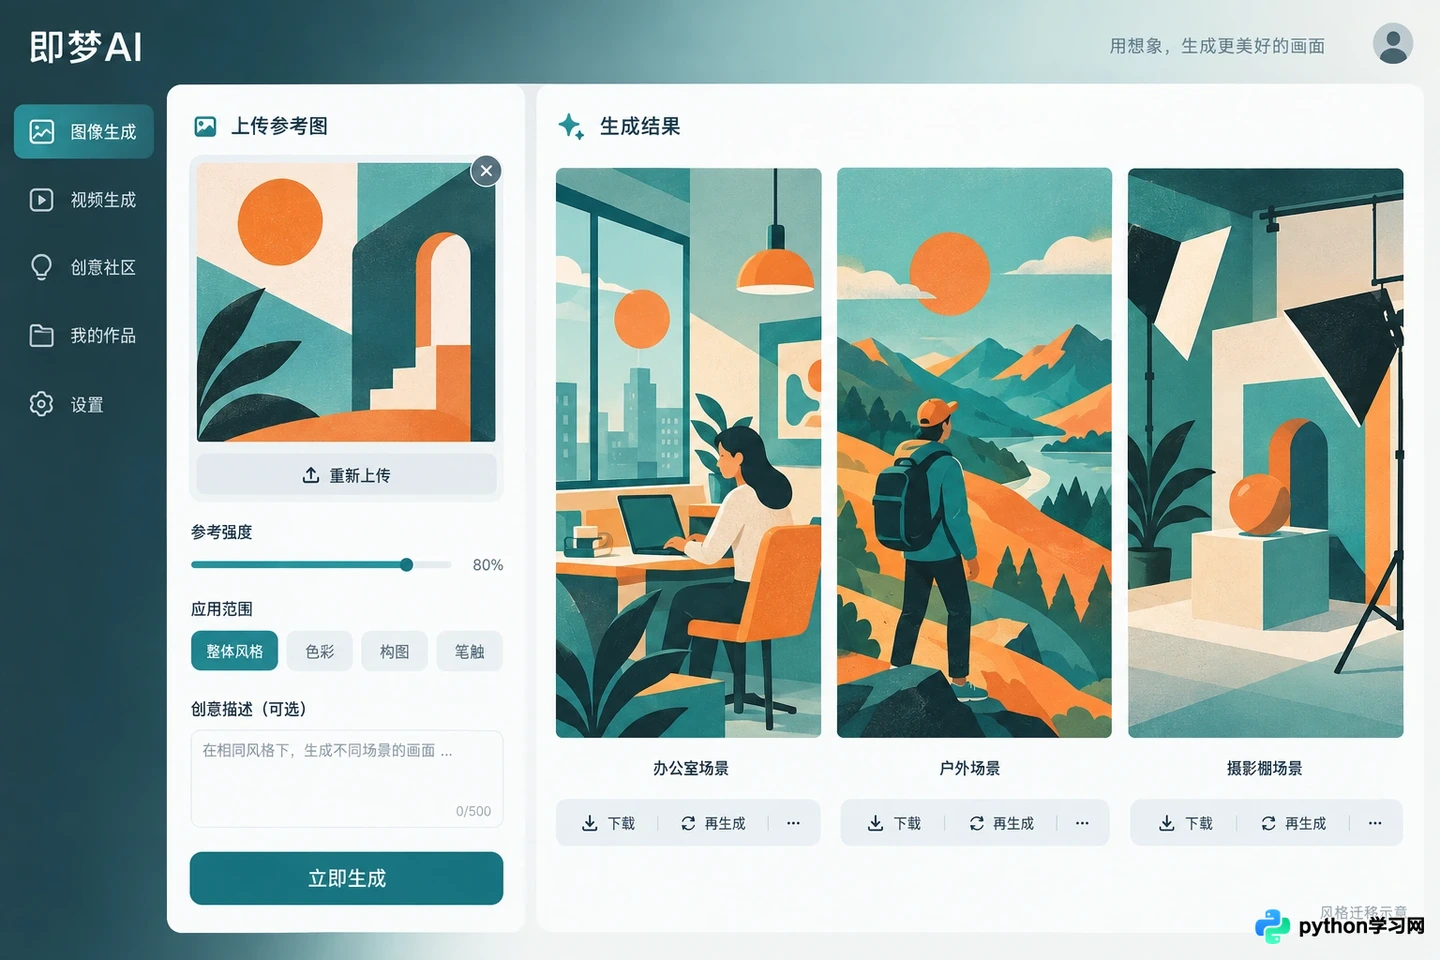
通过参考图实现品牌视觉风格的统一迁移
V3.0增强了风格参考(Style Reference)和角色一致性(Character Consistency)的功能深度。通过上传参考图,模型能更准确地提取色彩、笔触和构图特征,并将其迁移到新生成的图像中。这对于需要保持品牌视觉统一性的设计师尤为重要。你可以上传一张品牌主视觉图,然后要求V3.0生成一系列不同场景但风格一致的宣传图,其相似度远高于V2.0。此外,V3.0对负面提示词的响应也更加灵敏,能更有效地排除不想要的元素。但这种强大的可控性也带来了新的学习成本,用户需要更深入地理解参考图的选择标准和权重设置,才能充分发挥其潜力。
从V2.0到V3.0,即梦AI完成了一次从“工具”到“伙伴”的进化。V2.0适合那些追求快速出图、对细节容错率较高的轻量级用户,或者已经建立了成熟V2.0工作流且不愿轻易改变的生产团队。而V3.0则更适合对语义理解、文字渲染和视频连贯性有高要求的专业创作者,以及希望降低提示词工程门槛的新手。升级并非强制,但如果你发现自己在V2.0中花费大量时间修补手部、重绘文字或调整视频闪烁,那么V3.0带来的效率提升将远超适应新模型的成本。技术的进步最终是为了释放创意,而非束缚手脚,选择哪个版本,取决于你更愿意将时间花在调试机器,还是表达自我。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















