


Python修改Word文档时怎么保留原有格式和样式

在日常办公自动化中,使用 Python 的 python-docx 库修改现成 Word 文档时,最常遇到的问题就是原有文字被替换后,原有的字体、字号、颜色、粗体乃至对齐方式全变成了默认样式。保留格式的核心解决路径只有一条:必须严格在 Run(文本块)级别修改文字内容,或者使用基于 Word 原生标记的模板引擎,绝不能直接对整个段落的 text 属性赋新值。只要理清底层对象层级并遵循精准的更新规则,就能在完全不破坏排版的情况下安全修改文档。
一、格式丢失的根源:Word 文档的底层层级结构
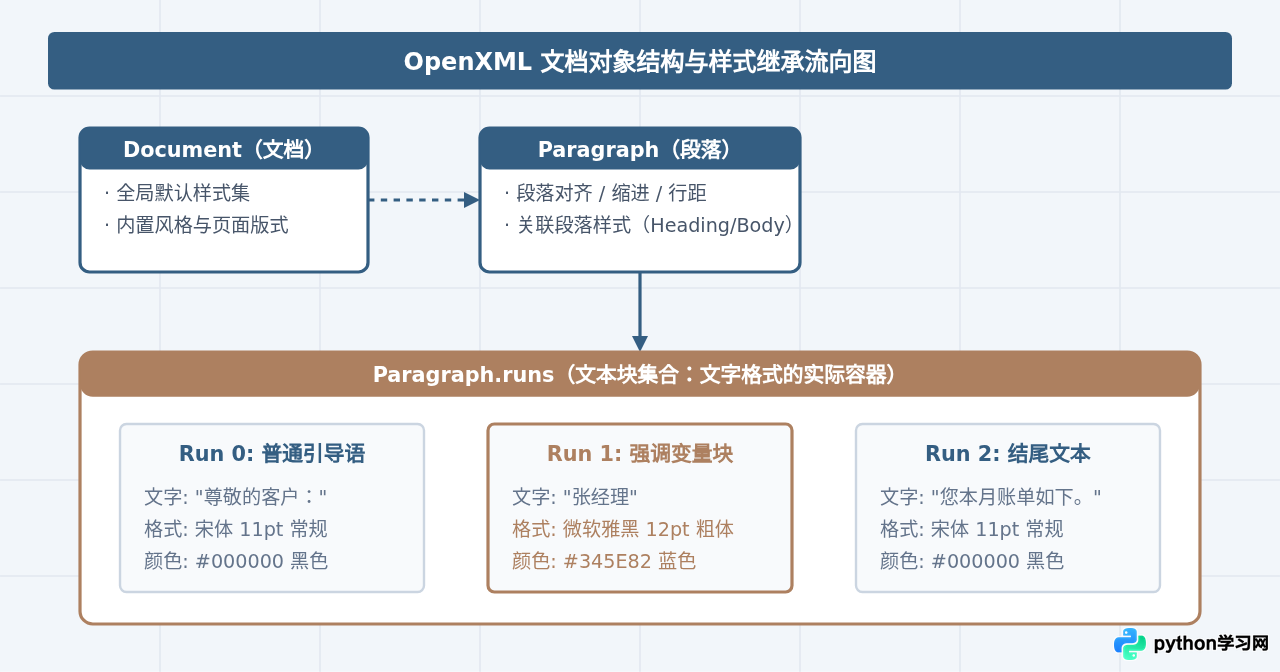
Word 文档(.docx)在底层本质上是一个遵循 OpenXML 标准的压缩包,文档中的文本并非简单的扁平字符串,而是存在严格的树状嵌套结构:Document(文档根节点)包含若干个 Paragraph(段落),而每个段落又由一个或多个 Run(文本块)拼合而成。最终的纯文字内容保存在 Run 的 w:t 节点中。
在 Word 的排版规则中,格式具有分层继承属性:
- 文档全局样式:定义预设标题、正文等基础模板。
- 段落级属性(Paragraph Format):控制段落对齐方式、首行缩进、行距以及段前段后间距。
- 文本块级属性(Run Format):控制具体一段连续文字的字体名称、字号、颜色、下划线、加粗及高亮。
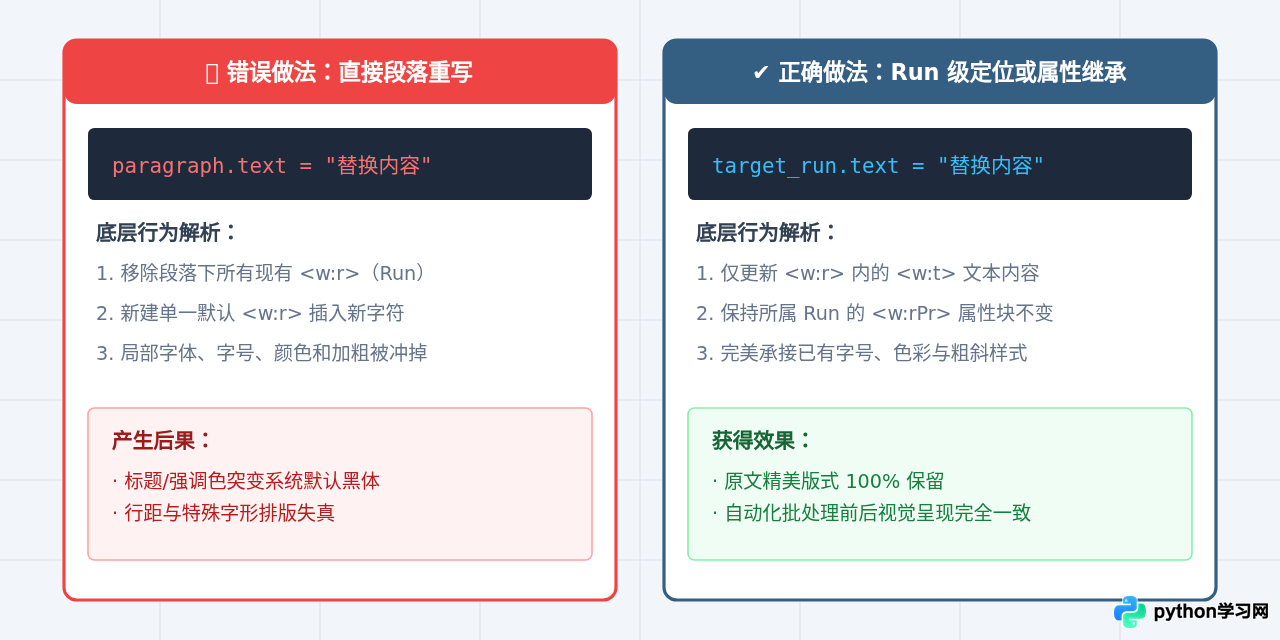
当执行 paragraph.text = "新文字" 时,python-docx 的内部行为是彻底清空该段落内所有的原有 Run 节点,然后创建一个只带有文档正文基础样式的全新 Run 节点。这就导致原作者在特定词句上花费心思设置的专属字体、强调色和字号瞬间被彻底抹除。
二、常见误区与两种修改方式的行为对比
理解了层级之后,保留样式的底层逻辑就变得非常直观。如果直接给 paragraph.text 赋值,会导致段落内所有 Run 被全量销毁。而直接定位到具体的 run 对象并只对其 .text 属性重新赋值,该 Run 已经配置好的字体、颜色、字号和粗斜体状态就会原封不动地保留下来。
三、核心实操:Run 级定位与跨 Run 占位符替换
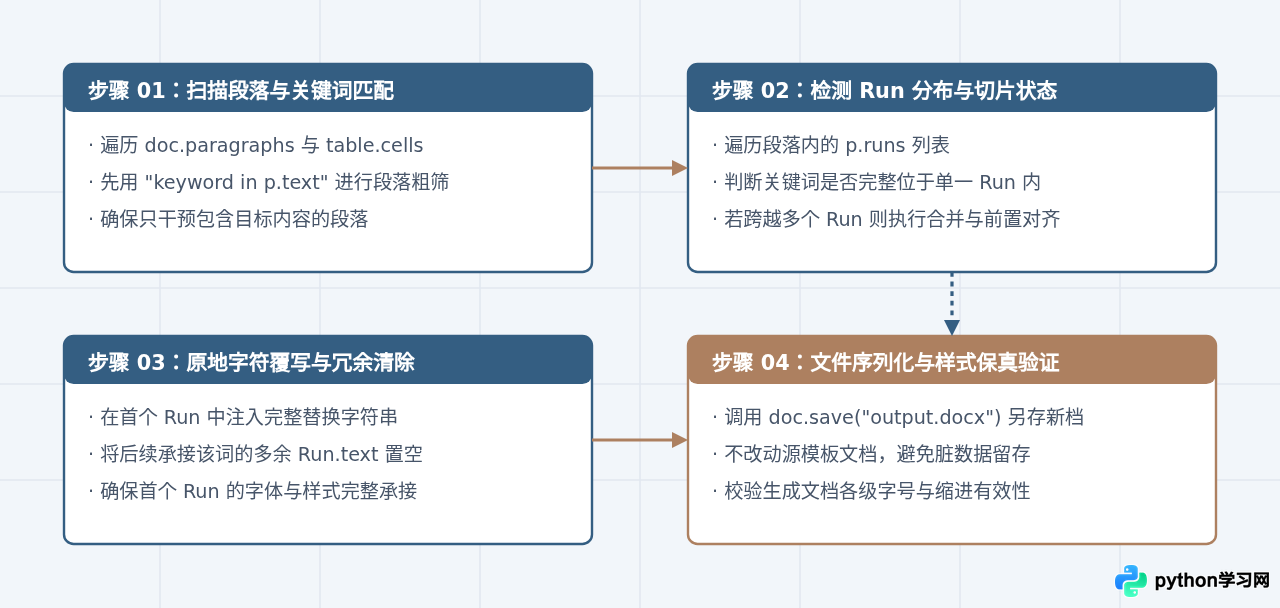
在编写代码前,必须了解 Word 编辑器的机制:当你在 Word 中多次修改一个词句,或者插入了拼写检查标记时,一段看起来连贯的文字(比如 {{username}})在底层 XML 中很有可能被 Word 切散在了两个甚至三个相邻的 Run 里面(例如 Run 0 是 {{user,Run 1 是 name}})。
要安全地在原生 python-docx 中保留格式并完成替换,必须经过四个标准步骤:
实战代码:单一 Run 与跨 Run 关键词的安全替换函数
下面给出生产环境中经过验证的通用替换代码。当遇到同一个词被 Word 拆到多个 Run 的情况时,该函数会把新文本写入第一个 Run,并将后续匹配段置空,从而完美维持前导 Run 的样式格式。
import docx

def replace_text_preserve_format(paragraph, old_text, new_text):
    """
    在段落中替换指定文字,严格保留原有 Run 的字体、颜色与样式
    """
    if old_text not in paragraph.text:
        return False

    # 情况一:关键词恰好完整落在某一个 Run 内部
    for run in paragraph.runs:
        if old_text in run.text:
            run.text = run.text.replace(old_text, new_text)
            return True

    # 情况二:关键词被 Word 拆散跨越了多个 Run
    full_text = ""
    run_ranges = []
    for idx, run in enumerate(paragraph.runs):
        start = len(full_text)
        full_text += run.text
        end = len(full_text)
        run_ranges.append((start, end, idx))

    start_pos = full_text.find(old_text)
    if start_pos == -1:
        return False
    end_pos = start_pos + len(old_text)

    # 找到覆盖该词的首个 Run 与末尾 Run
    first_run_idx = None
    for start, end, idx in run_ranges:
        if start <= start_pos < end:
            first_run_idx = idx
        if start < end_pos <= end:
            last_run_idx = idx
            break

    if first_run_idx is not None and last_run_idx is not None:
        # 重构首个 Run:保留自身前缀,加入新文本
        prefix = paragraph.runs[first_run_idx].text[:start_pos - run_ranges[first_run_idx][0]]
        suffix = paragraph.runs[last_run_idx].text[end_pos - run_ranges[last_run_idx][0]:]

        paragraph.runs[first_run_idx].text = prefix + new_text

        # 将中间跨越的 Run 清空,保留末尾 Run 的后缀文字
        for idx in range(first_run_idx + 1, last_run_idx + 1):
            if idx == last_run_idx:
                paragraph.runs[idx].text = suffix
            else:
                paragraph.runs[idx].text = ""
        return True

    return False

# 演示调用
doc = docx.Document("template.docx")
for p in doc.paragraphs:
    replace_text_preserve_format(p, "{{CONTRACT_NO}}", "HT-2026-0889")
doc.save("result.docx")
四、复杂文档批量替换的最佳实践:docxtpl 模板方案
如果需求是批量生成合同、通知书或评估报告,文档中有大量表格、加粗、下划线和特殊字号,手动用 python-docx 遍历 Run 会显得繁琐且容易因复杂的嵌套遗漏样式。此时业内最成熟的标准方案是使用 docxtpl。
docxtpl 的实现机制与普通文本替换完全不同:它直接读取 docx 内部的 word/document.xml,并把 Jinja2 模板语法注入到 XML 中。当渲染变量时,XML 标签和样式的定义节点会被完全绕过,只动态更新字面量节点,因此无论是段落样式、行内加粗、单元格高亮还是下划线,全部 100% 保持原有设计效果。
from docxtpl import DocxTemplate

# 1. 加载包含 Jinja2 标签的 Word 模板文档
# 模板中占位符写法为:{{ client_name }}、{{ total_amount }}
doc = DocxTemplate("invoice_template.docx")

# 2. 准备需要填入的数据字典
context = {
    "client_name": "华为云计算技术有限公司",
    "contract_title": "企业级数据服务采购合同",
    "effective_date": "2026年11月01日",
    "total_amount": "¥ 1,280,000.00"
}

# 3. 渲染数据并保存新文档
doc.render(context)
doc.save("generated_invoice.docx")
防坑提醒:在 Word 模板中输入 {{ variable }} 占位符时,建议一次性打完或从纯文本编辑器粘贴进去。如果在输入大括号后移动光标多次修改,Word 可能会在底层将双大括号拆分到不同的 Run 中。若发现 docxtpl 报变量未找到,只需在 Word 中全选该段落,使用“清除所有格式”重新设置一次字体即可。
五、表格单元格修改与新段落追加的样式继承技巧
除了常规段落文字替换,另外两个高频失真场景是修改表格单元格和向文档尾部追加新段落。
1. 修改表格单元格时的保真规则
Word 表格的单元格对象 cell 同样包含 paragraphs 列表。若直接写 cell.text = "新数值",单元格的垂直居中、文字内边距以及段落字体同样会被初始化。正确做法是操作单元格内的首个段落:
def set_cell_text_preserve_format(cell, new_text):
    """
    修改表格单元格文字,保留单元格内原有段落与 Run 的排版格式
    """
    if not cell.paragraphs:
        cell.text = new_text
        return

    # 获取单元格中的第一段
    p = cell.paragraphs[0]
    if p.runs:
        # 直接更新已有 Run,保留字体颜色字号
        p.runs[0].text = str(new_text)
        # 将后续多余的 Run 清空
        for r in p.runs[1:]:
            r.text = ""
    else:
        # 单元格原为空时直接写入
        p.text = str(new_text)
2. 新增段落与 Run 时的格式克隆(深拷贝)
当需要向已有文档追加内容,又希望新内容的外观与前文某一段落完全一致时,应当使用样式复制机制,将前文段落的 style 与 Run 的字体属性显式传递给新节点:
def append_run_with_source_format(target_paragraph, source_run, new_text):
    """
    以现有 Run 的样式为模板,向目标段落追加格式完全相同的新文本块
    """
    new_run = target_paragraph.add_run(new_text)

    # 逐项继承字符级格式属性
    new_run.bold = source_run.bold
    new_run.italic = source_run.italic
    new_run.underline = source_run.underline
    new_run.font.name = source_run.font.name
    new_run.font.size = source_run.font.size

    if source_run.font.color and source_run.font.color.rgb:
        new_run.font.color.rgb = source_run.font.color.rgb

    return new_run
六、策略选型与工程实践决策总结
不同的业务场景对 Word 格式保留的要求和实现复杂度差异很大。在开发自动化处理脚本前,可以根据任务属性选择最契合的开发技术路线:
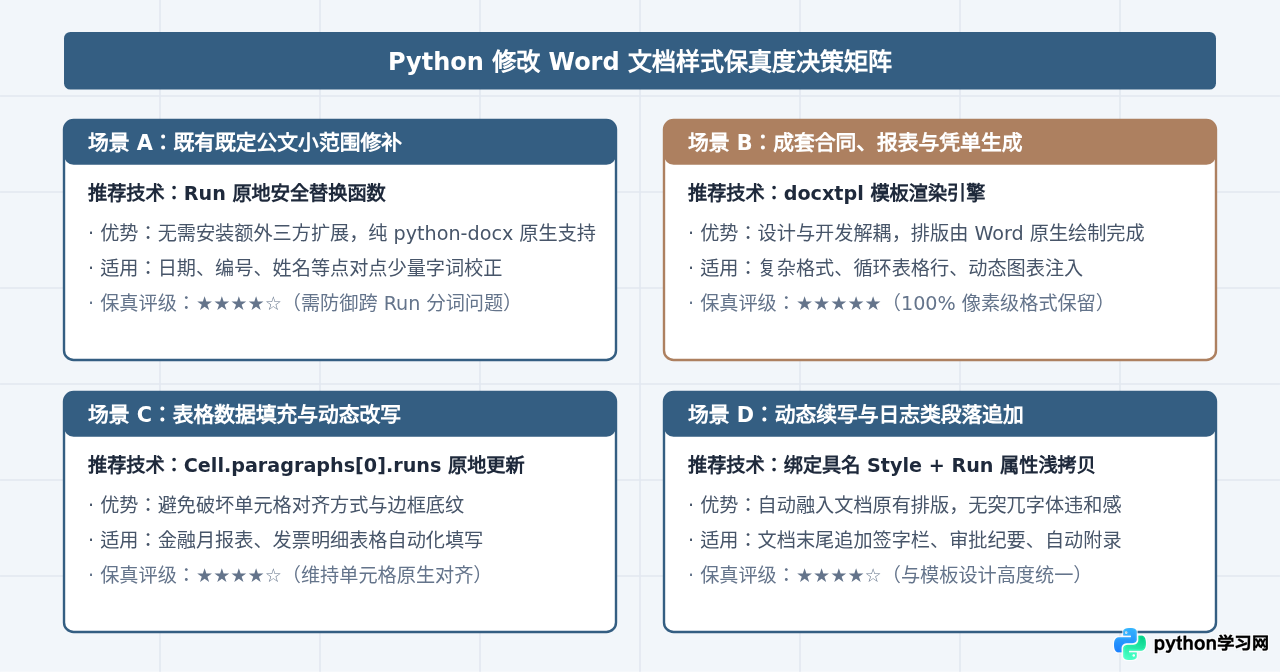
总结而言,在 Python 中处理 Word 文档并保持原有样式的核心就是永远不要使用粗暴的段落级整体覆写(paragraph.text = ...)。对于固定位置的关键字微调,采用定位首个 Run 并清空冗余 Run 的细粒度方式操作;对于结构固定的成套文档生成,优先采用 docxtpl 模板方案。只要遵循底层对象结构的设计逻辑,就能彻底杜绝排版错乱和格式丢失。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















