


企业为什么选择Python?从快速原型到大规模系统的实践

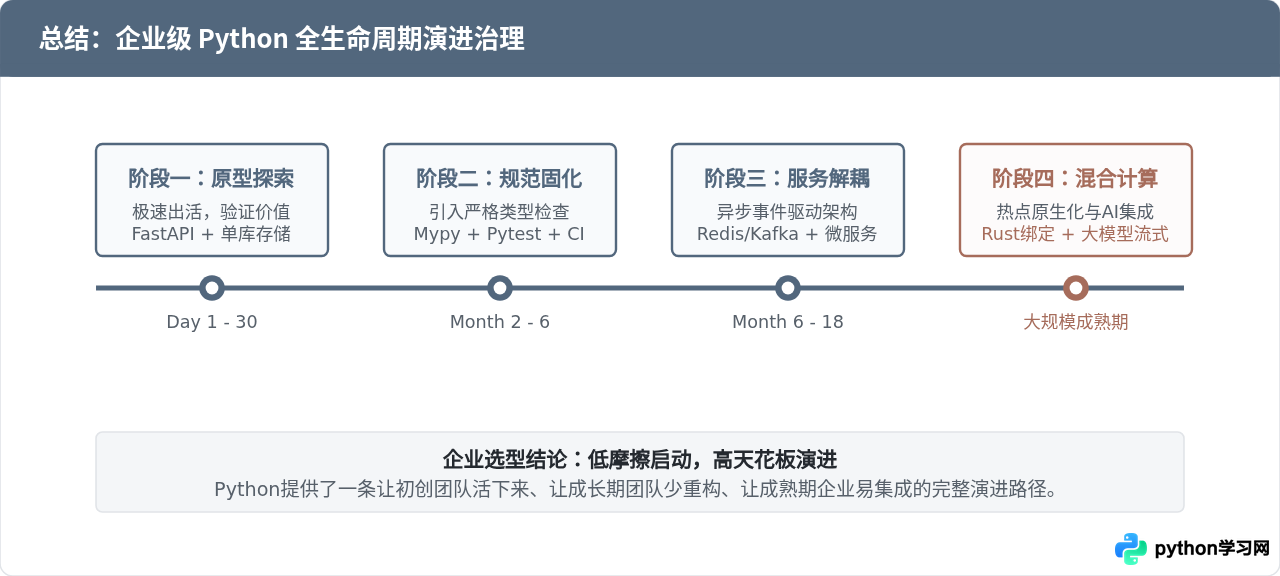
企业选择Python的核心原因并不是因为它是单核执行速度最快的语言,而是因为它在业务验证效率与系统工程演进之间找到了最佳平衡点。在商业竞争中,尽早交付可用产品验证市场假设的价值,往往远高于早期过度优化的微秒级性能收益;而当业务规模真正爆发时,现代Python生态已经拥有成熟的类型约束、异步并发机制以及微服务解耦手段,足以支撑海量并发的大规模生产环境。
一、从0到1阶段:为什么Python是验证业务原型的首选?
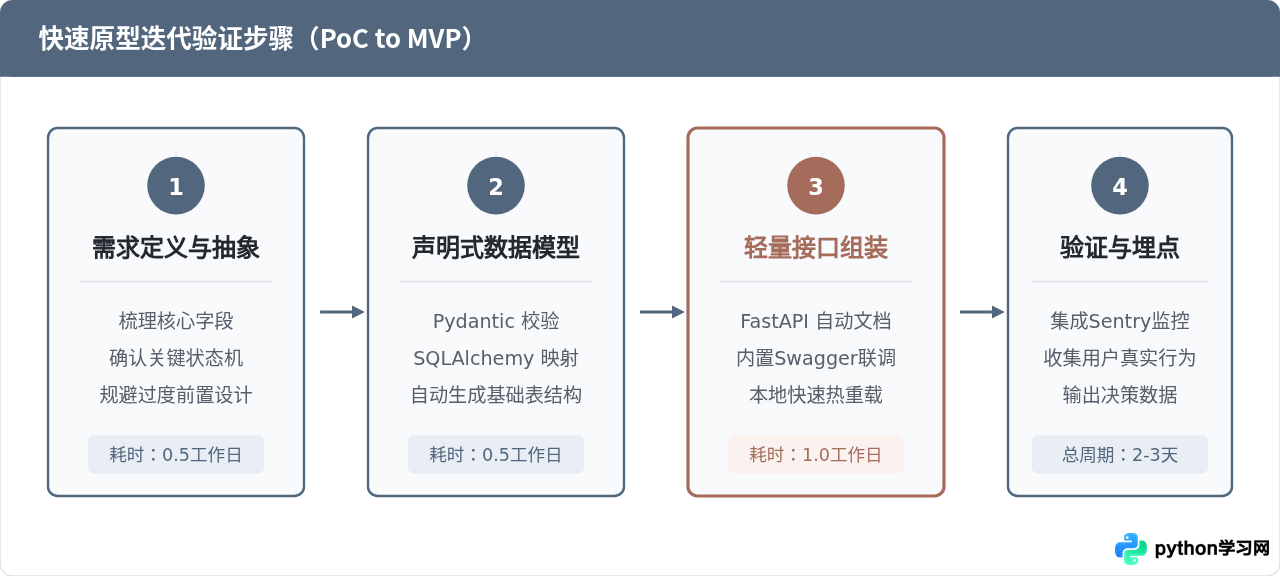
初创项目或企业新业务立项时,核心诉求是“快速将业务逻辑转化为可运行的API服务”。如果选择强样板代码的语言,开发团队的大量精力会被类型声明、底层构建配置和冗长的工程骨架牵扯。Python的代码表现力极高,能让团队专注于业务核心逻辑。
现代Python生态提供的工具链大幅降低了接口试错成本。以 FastAPI、SQLAlchemy 2.0 和 Pydantic 为代表的现代技术栈,能在数小时内构建出带有数据验证、异步支持与交互式API文档的完整服务。
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel, Field

app = FastAPI(title="用户权益原型服务")

class TierRequest(BaseModel):
    user_id: str = Field(..., description="企业用户唯一标识")
    score: int = Field(ge=0, description="综合评估积分")

@app.post("/api/v1/evaluate-tier")
async def evaluate_tier(req: TierRequest):
    if req.score >= 100:
        tier = "Enterprise"
    elif req.score >= 60:
        tier = "Professional"
    else:
        tier = "Standard"
    return {"user_id": req.user_id, "tier": tier, "status": "active"}
上述代码不仅直接运行即可提供HTTP接口,还内建了严格的参数格式校验和自动化OpenAPI文档生成。团队在数分钟内就能让前端、数据团队与客户体验到真实的原型流程。
二、打破“无法做大”的偏见:大规模系统的分层架构演进
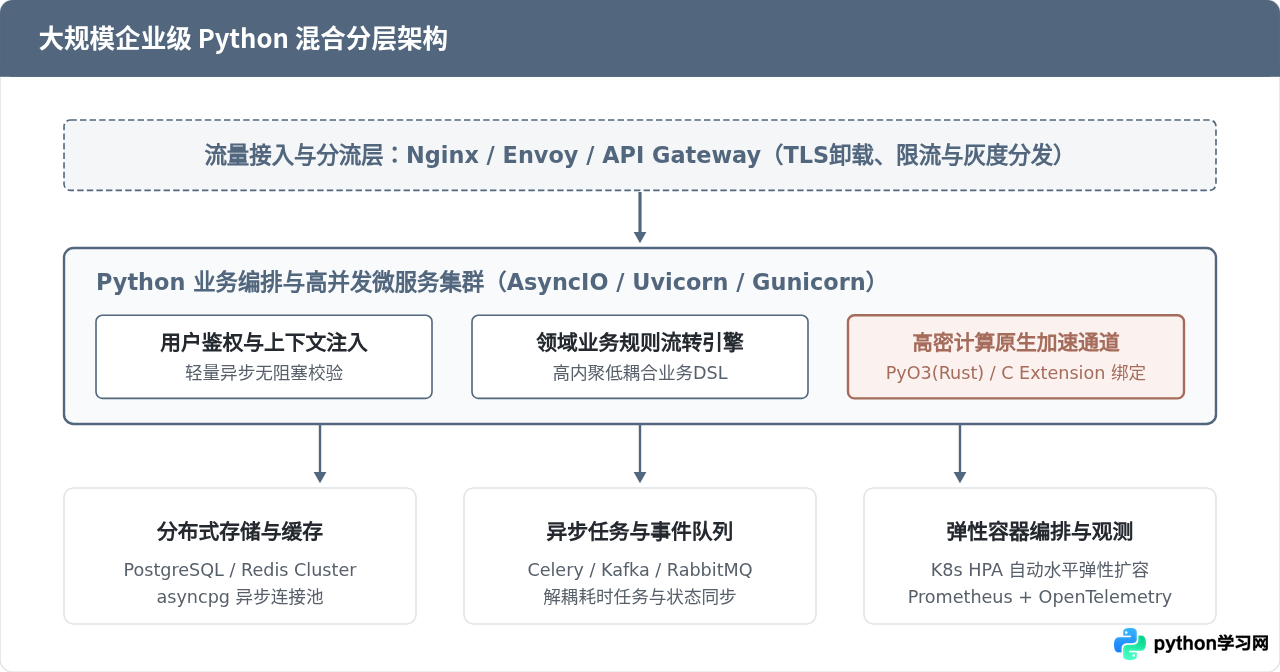
很多工程团队在项目初期担心:“Python能撑起数万乃至数十万QPS的系统吗?”真实的工业界实践表明,包括Instagram、Dropbox等国际知名平台的核心业务均长期运行在Python基础设施之上。关键在于系统架构的分层设计:让不同语言做自己最擅长的事情。
在大规模系统中,90%以上的业务代码属于I/O密集型任务——即等待数据库响应、调用远程RPC、读取缓存或组装JSON报文。在这类场景中,瓶颈通常在于网络延迟与数据库索引效率,而非解释器自身的CPU执行速度。针对极少数计算密集型的热点逻辑,团队完全可以将该模块下沉为C/C++、Rust或Go编写的原生扩展模块,而将上层灵活易变、需要频繁迭代的业务编排留给Python。
三、落地工程化规范:类型、质量与并发保障
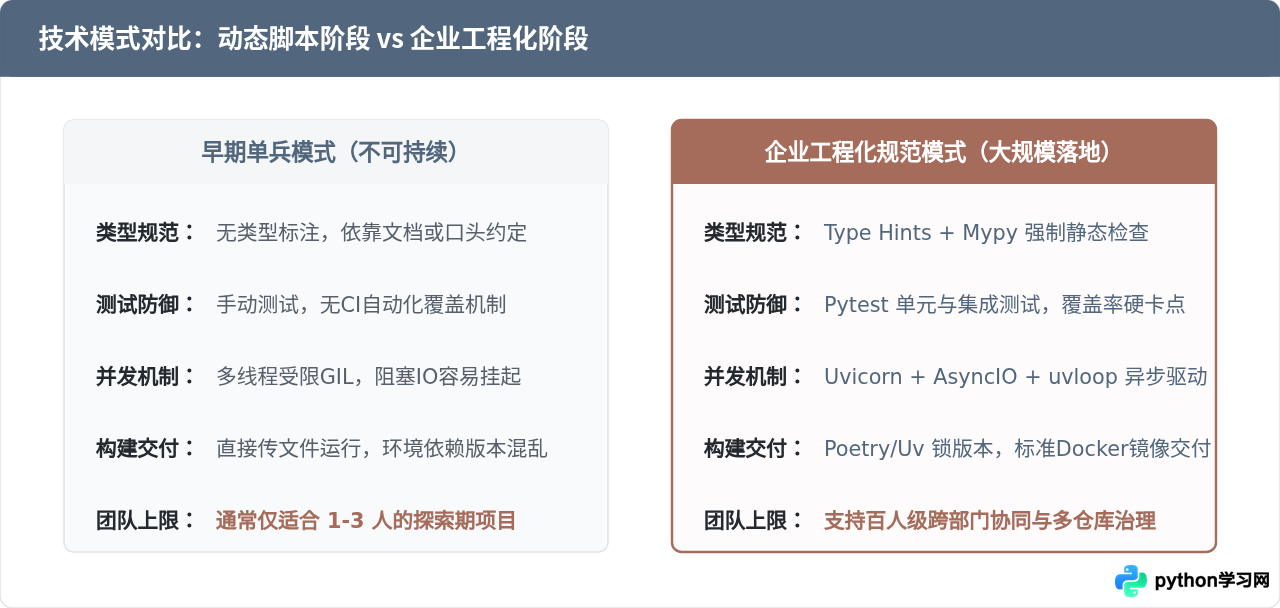
动态类型语言在团队规模扩大到数十人乃至上百人时,常被诟病存在可维护性隐患。现代Python通过严格的类型提示(Type Hints)与静态类型检查器(如 Mypy、Pyright)彻底解决了这一问题。在持续集成(CI)阶段强制执行静态分析,可以在代码合并前拦截绝大部分因为字段拼写错误、空指针(NoneType)异常导致的线上隐患。
mypy.ini 或 pyproject.toml 配置,并在CI流水线中开启 disallow_untyped_defs = true。强制公共模块与接口方法显式声明输入输出类型,将代码缺陷拦截在构建阶段。
from typing import Optional, List
from dataclasses import dataclass

@dataclass(frozen=True)
class TenantConfig:
    tenant_id: str
    rate_limit: int
    allowed_ips: List[str]

def resolve_tenant_quota(config: Optional[TenantConfig]) -> int:
    # 静态检查器会确保针对 config 为 None 的边界情况必须做防御处理
    if config is None:
        return 0
    return config.rate_limit
除了静态类型,并发模型也是大规模系统的支撑基石。传统的同步阻塞I/O在并发达到几百个请求时,就会耗尽操作系统的线程资源;而借助 asyncio 与 uvloop 事件循环,单台服务器的单个工作进程即可轻松维持数万并发连接。
四、性能调优与容量治理实践
在大规模生产环境中,针对Python特性的性能调优主要聚焦于三个层面:工作进程模型、内存治理与数据库连接池优化。
- 多进程与多Pod协同伸缩:由于全局解释器锁(GIL)的存在,单个Python进程无法通过多线程跑满多核CPU。在企业实践中,标准部署方案是在单个容器内启动与CPU核心数匹配的工作进程(通常为
Workers = 2 * CPU + 1),再通过 Kubernetes 的水平Pod自动扩缩器(HPA)根据CPU利用率或自定义QPS指标实现动态伸缩。 - 连接池与资源复用:避免在请求上下文中频繁创建数据库连接或HTTP客户端会话。必须在应用启动生命周期中初始化单例连接池(如基于
httpx.AsyncClient或 SQLAlchemy 异步 Engine),并配置严格的最大连接数与超时释放时间。 - 针对大对象的内存排查:Python的垃圾回收依赖引用计数与分代标记。在批量数据导出或报表生成任务中,应采用流式生成器(Generators),避免一次性加载百万级数据对象导致内存突增和频繁触发GC停顿。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















