


pandas、openpyxl与xlrd:Python读取Excel该选哪个库

在Python中读取Excel文件,核心选型逻辑非常直接:若目标是进行表格数据分析、清洗与矩阵运算,首选pandas;若需要保留单元格公式、操作样式排版或流式处理超大.xlsx文件,选择openpyxl;若面对的是历史遗留的二进制.xls旧文件,则必须使用xlrd(版本需严格限定且仅支持.xls)。
一、文件格式分水岭:明确 .xlsx 与 .xls 的底层差异
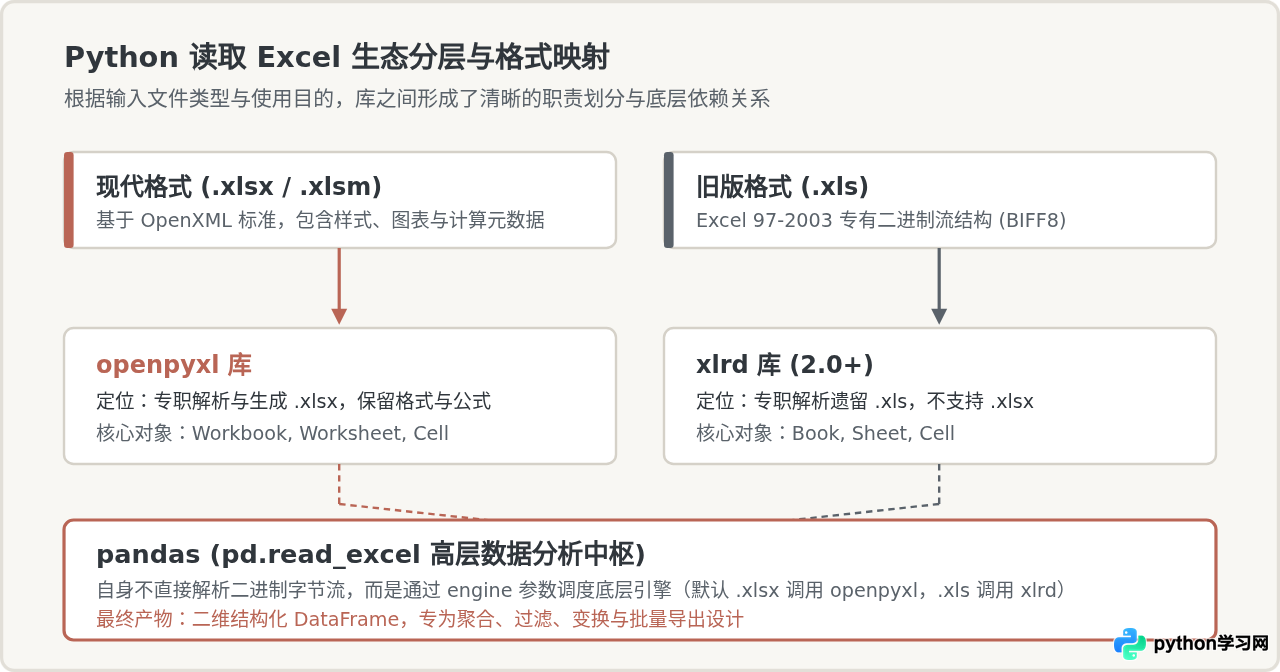
在选择具体的Python库之前,必须先厘清待处理Excel文件的真实格式。日常接触的Excel文件主要分为两大类:基于开放XML标准的现代格式(扩展名为.xlsx、.xlsm)以及早期Excel 97-2003所使用的二进制专有格式(扩展名为.xls)。
在早期Python生态中,xlrd曾是读取所有Excel文件的事实标准。然而,从2020年发布的xlrd 2.0.0版本起,官方出于安全防护与维护复杂度的考虑,彻底移除了对.xlsx格式的支持。若尝试使用现代版本的xlrd打开.xlsx文件,程序会直接抛出XLRDError: Excel xlsx file; not supported异常。这一重大版本变更直接决定了后续的技术路线:现代.xlsx文件的底层解析必须交给openpyxl(或高层封装的pandas),而xlrd则退守为专门维护旧版.xls文件的兼容性工具。
二、三大库的核心能力与典型操作步骤
为了深入理解每个库在实际业务中的具体用法,接下来逐一分析它们的核心API设计、代码范式与执行机制。
1. pandas:以数据分析为核心的高层整合
pandas是数据科学与工程领域的事实标准。通过pd.read_excel()函数,用户可以在一行代码内将Excel文件完整映射为二维表格结构DataFrame。
核心优势:提供了极高维度的抽象,内置丰富的行列筛选、类型自动推断、缺失值填充、分组聚合与多表连接能力。读取数据后无需编写嵌套循环即可直接展开分析计算。
import pandas as pd

# 读取 .xlsx 文件(默认 engine='openpyxl')
# 明确指定 sheet 名称与关键列类型,避免长数字编码丢失精度
df = pd.read_excel(
    "sales_report.xlsx",
    sheet_name="2026_Q1",
    dtype={"订单编号": str, "客户税号": str},
    usecols=["订单编号", "销售额", "下单时间"]
)

# 直接进行向量化计算与统计
total_sales = df["销售额"].sum()
print("销售总额:", total_sales)适用边界:pandas在加载时会忽略字体、背景色、边框等排版格式,并且在默认模式下会将整张表一次性载入内存。如果核心诉求是修改某个单元格的底色或提取单元格中的批注,pandas并不适用。
2. openpyxl:深度控制 .xlsx 的精细工匠
openpyxl是一个专门针对ECMA-376 OpenXML标准构建的纯Python库。它不仅能读取数据单元格的值,还能完整提取单元格公式、字体样式、边框、合并单元格范围以及工作表保护属性。
核心优势:具备极强的结构还原能力。支持通过data_only=True参数在“读取公式表达式本身”与“读取上次Excel计算保存的缓存值”之间灵活切换;对于几十万行的大型表格,还提供了read_only=True流式迭代模式,仅消耗极低的内存。
from openpyxl import load_workbook

# 加载工作簿:data_only=False 保留公式文本,True 则获取公式计算后的静态值
wb = load_workbook(filename="financial_model.xlsx", data_only=True)
sheet = wb["资产负债表"]

# 精确读取指定单元格的值与属性
cell = sheet["B5"]
print(f"单元格 B5 坐标: {cell.coordinate}, 数值: {cell.value}")

# 逐行遍历指定区域
for row in sheet.iter_rows(min_row=2, max_row=10, min_col=1, max_col=3, values_only=True):
    print(row)

# 显式关闭只读工作簿以释放文件句柄
wb.close()
3. xlrd:老旧二进制 .xls 文件的专属桥梁
xlrd在2.0版本后将重心完全收缩至旧版BIFF8规范的.xls文件。它代码小巧、依赖极少、解析旧版文件的执行速度较快。
import xlrd

# 打开遗留系统的 .xls 文件
workbook = xlrd.open_workbook("legacy_archive_2003.xls")

# 按索引获取工作表
sheet = workbook.sheet_by_index(0)

# 读取行数、列数及单元格内容
print(f"总行数: {sheet.nrows}, 总列数: {sheet.ncols}")
for row_idx in range(min(5, sheet.nrows)):
    row_values = sheet.row_values(row_idx)
    print(f"第 {row_idx + 1} 行数据:", row_values)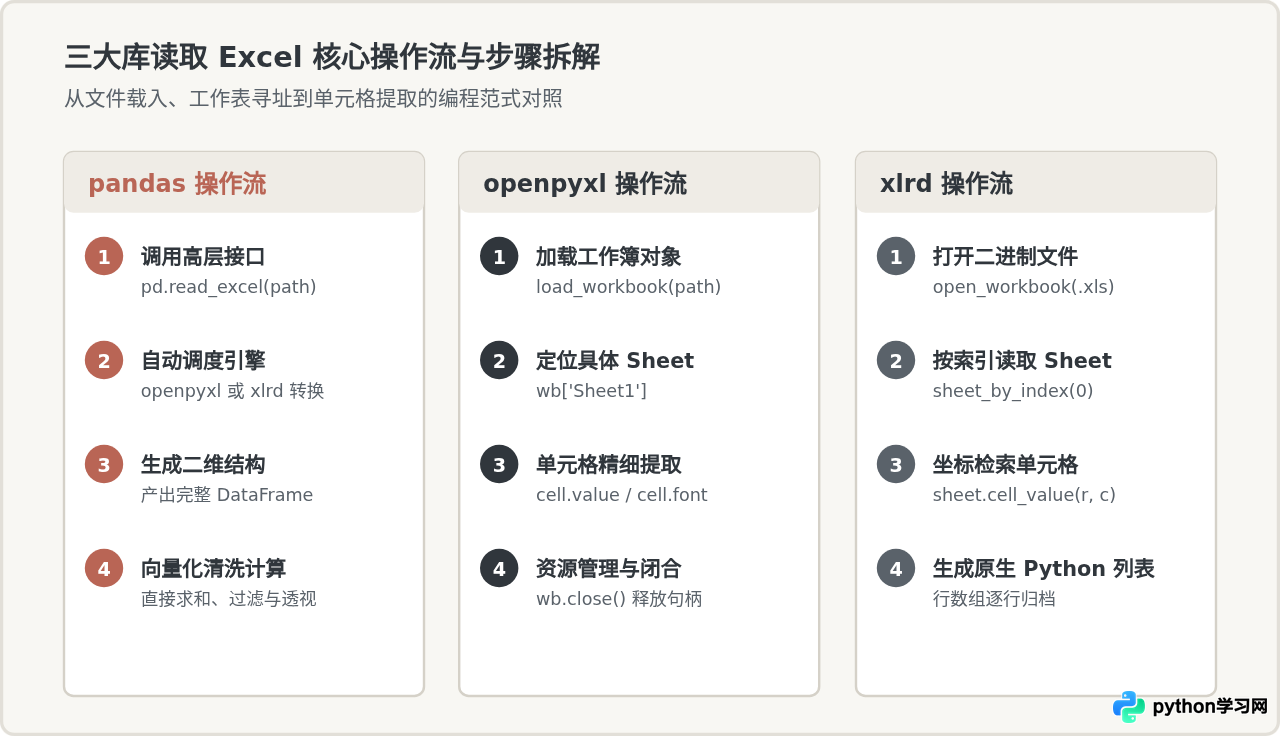
三、决策路径:如何根据具体业务场景精准选型
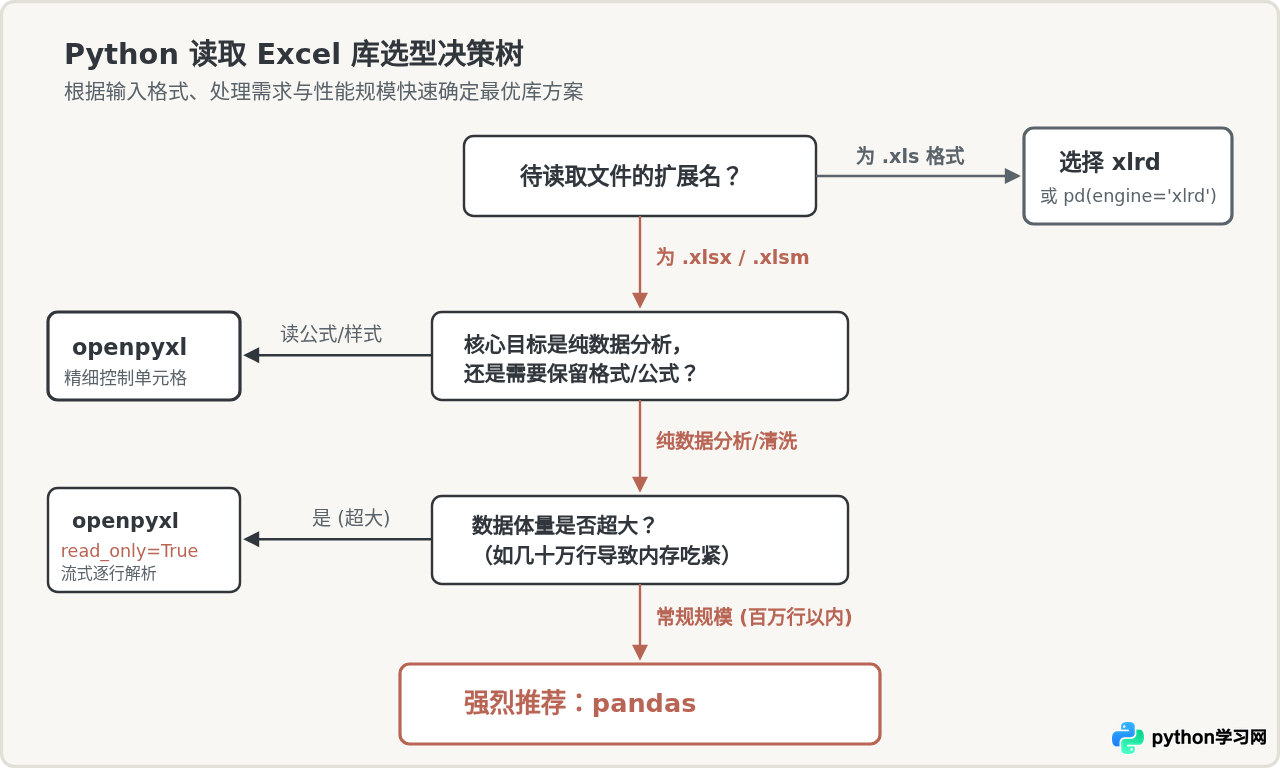
在真实工程场景中,技术选型不应停留在抽象的“各有利弊”,而应根据输入文件格式、下游消费方式与文件数据量体量建立严格的逻辑分支。
场景 1:日常数据提取、聚合分析与报表清洗
推荐选择:pandas
当业务目标是提取表格内的业务数据,随后进行排序、分组统计(Groupby)、合并汇总(Merge)、数据清洗或转存入MySQL/PostgreSQL等数据库时,pandas是唯一具备最高生产力优势的选择。手写循环使用openpyxl提取每一行再构造字典,不仅耗费数十倍的代码量,且其底层的执行效率远不及pandas针对批量数组的底层C优化。
场景 2:需要读取公式定义、单元格批注或检查样式格式
推荐选择:openpyxl
如果任务属于审计或格式验证类业务,例如:“检查财务报表中的E列是否都输入了公式而不是直接填入的死数值”、“读取单元格背景填充色为红色的异常数据行”、“提取财务主管在单元格上留下的Comment批注”,pandas完全无法满足,此时必须使用openpyxl。
场景 3:读取几十万行的大型 Excel 文件(避免内存溢出)
推荐选择:openpyxl (read_only=True) 或 pandas (chunksize)
普通模式下,openpyxl会将整个工作表的DOM树构造成Python对象加载到内存中,一个包含30万行数据、原始大小为20MB的.xlsx文件,完全加载可能会消耗数百兆甚至上千兆的内存。如果服务器内存受限,openpyxl提供了只读流式模式:
from openpyxl import load_workbook

# 开启 read_only 模式,采用基于 XML SAX 流的方式顺序读取,内存占用恒定
wb = load_workbook("huge_dataset.xlsx", read_only=True)
sheet = wb.active

for row in sheet.iter_rows(values_only=True):
    # 逐行处理并消费,不将所有行常驻内存
    process_row(row)

wb.close()
而在pandas中,若需要分批处理超大Excel,可以通过指定chunksize参数逐块读取(注意底层引擎仍需支持对应流式特性)。
场景 4:解析政府机关或老旧ERP系统导出的 .xls 报表
推荐选择:xlrd 或 pandas(engine='xlrd')
许多传统银行、高校或政企系统的导出模块多年未升级,生成的文件仍为标准的.xls二进制格式。此时使用最新版openpyxl会直接报错。必须通过pip install "xlrd>=2.0.1",并通过pandas.read_excel('file.xls', engine='xlrd')或直接调用xlrd.open_workbook()完成解析。
四、容易忽略的关键细节与高频陷阱
在实际读取Excel文件的开发过程中,经常会遇到非预期的解析行为。提前识别以下陷阱能节省大量排查时间:
1. openpyxl 读取公式单元格返回 None
当使用load_workbook(filename, data_only=True)读取含有公式的单元格时,如果返回结果为None,这通常不是openpyxl的代码错误,而是因为该文件是由第三方软件直接写入生成,尚未经过官方Microsoft Excel或WPS打开并触发计算。
data_only=True并不是在Python内存中实时运行公式引擎(openpyxl不包含Excel的公式计算器),而是直接读取XML中缓存的<v>节点计算结果。若文件未在Excel软件中被重新保存过,该缓存节点可能为空。解决办法是在生成端使用能够触发计算引擎的工具,或在业务端通过Python脚本补全公式逻辑。
2. 身份证号、工号等长数字变成浮点数或科学计数法
在使用pandas.read_excel()时,包含18位身份证号、银行卡号或前导0的编号(例如001234)常常会被自动解析为浮点数(如1.10101e+17),从而发生精度截断或丢失前导0。
避坑方案:在调用read_excel时,务必利用dtype参数显式声明对应列为字符串类型:
# 明确锁定关键列为 str,杜绝自动数字类型推断带来的截断
df = pd.read_excel("users.xlsx", dtype={"身份证号": str, "组织代码": str})
3. 日期时间被读取为浮点数时间戳
Excel在内部将日期时间存储为以1900年1月1日为基准的天数浮点数(例如44927.5代表2023年1月1日中午12点)。在底层使用xlrd或未正确推断类型的openpyxl读取时,有时会直接拿到浮点数而不是datetime对象。
对于xlrd,需调用专用辅助函数转换:xlrd.xldate_as_datetime(cell_value, workbook.datemode);而在pandas中,通常会自动转换为标准的Timestamp对象,但仍建议在读取后使用pd.to_datetime(df['日期列'])进行一次显式防御性校验。
五、全景对照与选型速查表
将上述各个维度的关键特性汇总为一张全景对照表,便于在项目架构设计时对照查阅:
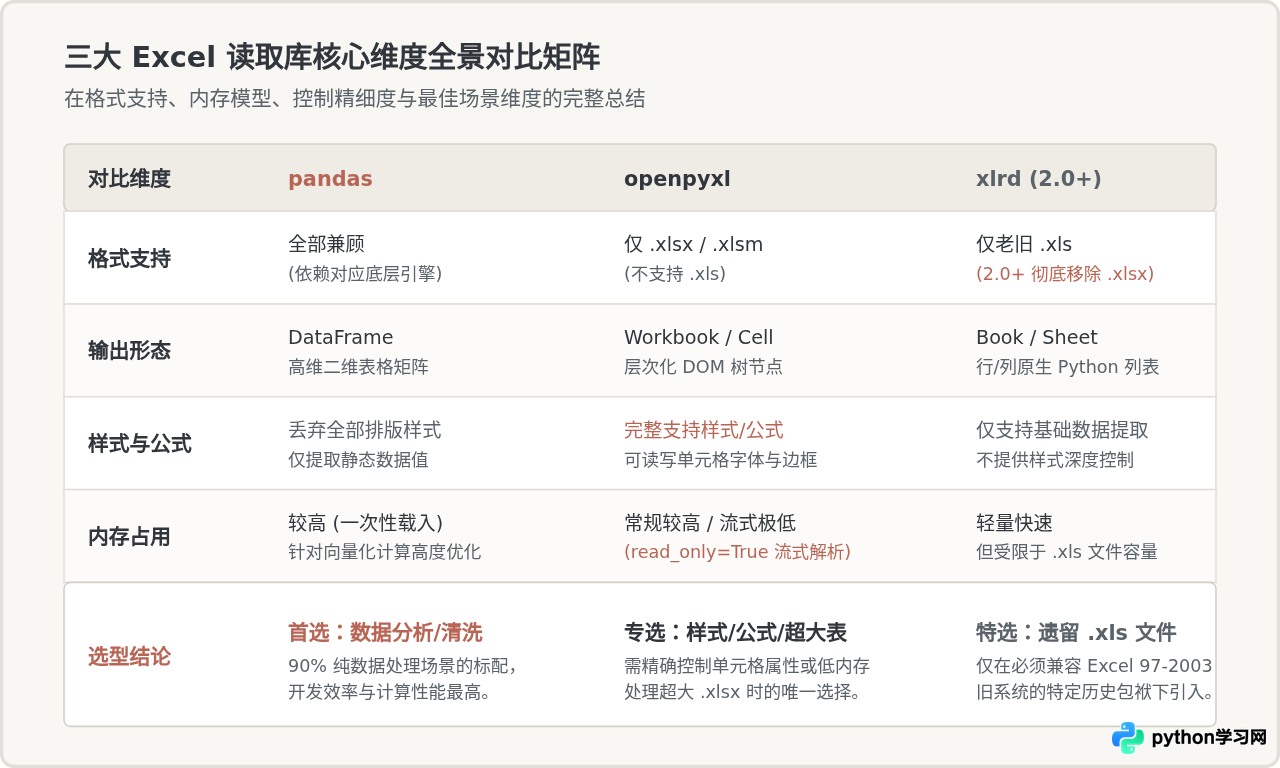
总结而言,在规划Python读取Excel的技术方案时,切忌盲目依赖单一库。推荐在项目初始化阶段明确输入文件的格式边界:常规数据管道统一封装pandas.read_excel,底层搭配openpyxl支撑.xlsx、xlrd兜底.xls;唯有在需要对单元格进行样式、公式解析或在低配置服务器流式迭代数十万行数据时,再单独引入openpyxl进行底层精细化处理。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















