


除了Matplotlib,Python还有哪些高性能交互式绘图库?

一、为什么需要替代Matplotlib?核心瓶颈解析
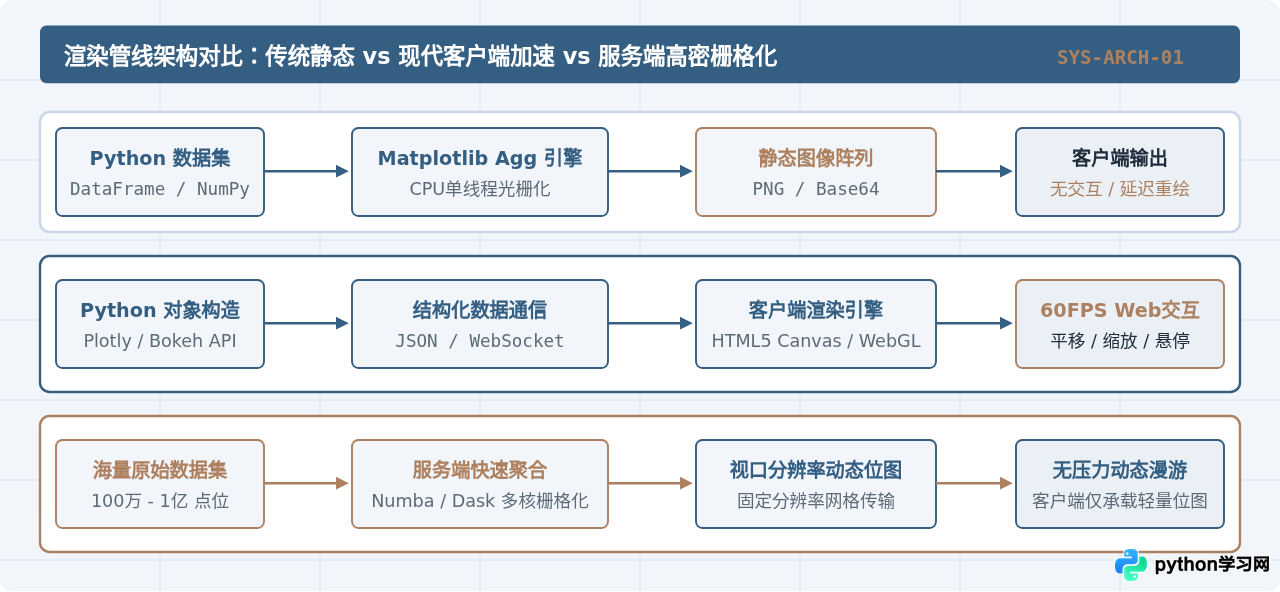
Matplotlib诞生于以桌面端和出版物静态输出为主的时期。其底层经典架构(如基于C++实现的Agg渲染器)的核心任务是将几何图元光栅化为像素阵列(PNG)或输出为矢量文件(PDF/SVG)。当用户在Jupyter Notebook或现代Web端需要交互时,Matplotlib主要通过重新生成图像切片或利用基础GUI后端截获事件,这在面对现代数据工程时暴露出两个明显短板:
- DOM节点与矢量吞吐瓶颈:若在前端直接输出SVG矢量图形,当点位超过1万到3万个时,浏览器DOM树将承受数万个独立节点的内存与重绘开销,导致页面明显卡顿甚至假死。
- 缺乏现代前后端分离通信协议:桌面GUI事件循环难以原生嵌入现代Web前端架构,缺少在浏览器客户端直接进行视口重绘、数据掩码计算和动态滤波的轻量化机制。
为了解决上述问题,现代交互式绘图库从底层改变了渲染与传输链路,主要分化出“客户端WebGL/Canvas硬件加速”与“服务端高性能矩阵栅格化”两种技术路线。
二、主流高性能交互式绘图库核心实战
1. Plotly:全功能通用交互与 WebGL 硬件加速
Plotly 是目前在工业界和科研领域应用最广泛的交互式库之一。其核心驱动是前端开源的 plotly.js,借助 D3.js 处理坐标与排版,并原生集成了基于 WebGL 的着色器渲染。
常规的 plotly.express.scatter 默认采用 SVG 渲染,在点数达到 2 万以上时会出现明显顿挫感。要激活其高性能模式,关键在于使用 scattergl 图元。WebGL 直接将坐标数组传递给 GPU 顶点着色器,使数十万点的缩放和平移依然能维持在 60 FPS。
import numpy as np
import plotly.graph_objects as go

# 生成 200,000 个随机高维样本点
n_points = 200000
x = np.random.normal(loc=0, scale=1, size=n_points)
y = np.random.normal(loc=0, scale=1, size=n_points)

# 使用 WebGL 加速的 Scattergl 图元
fig = go.Figure()
fig.add_trace(go.Scattergl(
    x=x,
    y=y,
    mode='markers',
    marker=dict(
        size=3,
        color=np.sqrt(x**2 + y**2),
        colorscale='Viridis',
        opacity=0.6,
        showscale=True
    ),
    name='GPU加速散点'
))

fig.update_layout(
    title='Plotly WebGL 硬件加速渲染 (200,000 观测点)',
    template='plotly_white',
    dragmode='pan'
)

# 导出为独立可交互的 HTML 产物,不依赖后端 Python 服务
fig.write_html('plotly_scattergl_demo.html')Scattergl 极大解放了浏览器渲染能力,但初次绘制时仍需将几十万个浮点数序列化为 JSON 传输。如果单页面中并发打开多个 WebGL 画布,需注意浏览器的 WebGL Context 数量上限(不同浏览器通常限制在 8 到 16 个上下文)。
2. Bokeh:面向数据应用的流式传输与状态联动
Bokeh 的设计目标不仅是产出图表,更侧重于构建复杂的仪表盘和数据分析应用。与大多数仅在导出时生成单向 JSON 的库不同,Bokeh 拥有专门的 Bokeh Server 架构,支持 Python 后端与前端 BokehJS 之间的双向 WebSocket 同步。
在渲染层面,Bokeh 默认采用 HTML5 Canvas API,相比 SVG 显著降低了 DOM 开销;同时 Bokeh 也提供了试验性质的 WebGL 标志位(output_backend="webgl")。对于工业物联网传感数据监控或实时量化回测,Bokeh 的 ColumnDataSource.stream() 可以做到仅追加增量数据,而无需刷新整个图表。
import numpy as np
from bokeh.plotting import figure, output_file, save
from bokeh.models import ColumnDataSource, HoverTool

# 准备 50,000 个时序采集点
n = 50000
time_series = np.linspace(0, 100, n)
sensor_val = np.sin(time_series) + np.random.normal(0, 0.2, n)

source = ColumnDataSource(data=dict(time=time_series, val=sensor_val))

# 指定 output_backend="webgl" 开启硬件加速
p = figure(
    title="Bokeh 传感器高速时序监控",
    width=800,
    height=400,
    output_backend="webgl",
    tools="pan,wheel_zoom,box_zoom,reset,save"
)

p.line('time', 'val', source=source, line_width=1, line_color="#345E82", alpha=0.8)

# 添加高效悬停检测工具
hover = HoverTool(tooltips=[("时间戳", "@time{0.00}"), ("数值", "@val{0.000}")])
p.add_tools(hover)

output_file("bokeh_realtime_demo.html")
save(p)
3. Datashader:千万级点位服务端栅格化利器
当数据量突破百万甚至达到上亿级别(例如全国出租车 GPS 轨迹、遥感影像点云、全基因组图谱)时,任何将原始坐标传输至客户端浏览器的方案都会因网络传输和内存开销而崩溃。
Datashader(属于 PyViz / HoloViz 生态)颠覆了“在前端绘制点”的传统思路。其基本原理是:将原始数据保留在服务端内存中,借助 Numba JIT 编译器在数毫秒内将点集投影并聚合到一个与用户当前屏幕分辨率一致的 2D 数组(如 1000×600 网格)中,随后利用传递函数着色生成高保真动态位图。无论原始数据是一千万点还是一亿点,发送到前端的始终只是一张几十 KB 的位图,平移或缩放时由服务端按当前视口实时重算。
import numpy as np
import pandas as pd
import datashader as ds
import datashader.transfer_functions as tf

# 生成 5,000,000 个高斯分布密集点
n = 5000000
df = pd.DataFrame({
    'x': np.random.normal(0, 1, n).astype(np.float32),
    'y': np.random.normal(0, 1, n).astype(np.float32)
})

# 定义视口画布尺寸(与屏幕像素严格对应)
canvas = ds.Canvas(plot_width=800, plot_height=450)

# 在服务端利用 Numba 多核计算进行点聚合(生成频次直方图网格)
agg = canvas.points(df, 'x', 'y')

# 根据密度分布执行对数着色,消除视觉重叠(Overplotting)
img = tf.shade(agg, cmap=['#F2F6FA', '#345E82', '#AD8060'], how='eq_hist')

# 导出生成的纯位图,通常与 HoloViews 或 Bokeh 结合实现视口拖拽无缝联动
img.to_pil().save("datashader_render_5m.png")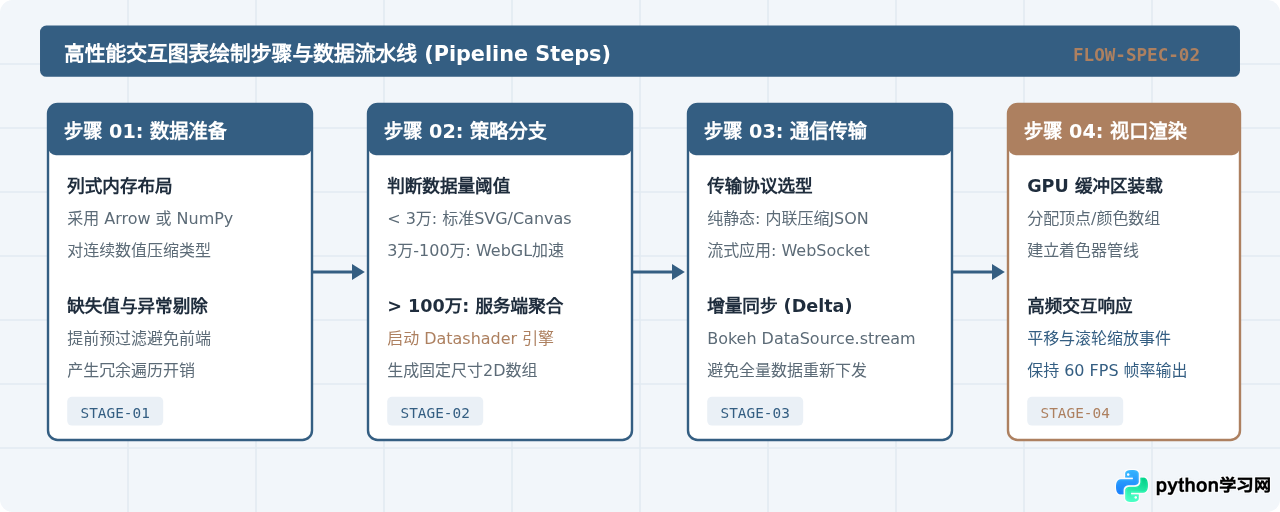
4. 补充利器:Altair 与 Pydeck
在特定细分领域,还有两个不可忽视的优秀交互式绘图工具:
- Altair(基于 Vega-Lite 声明式语法):如果读者更偏好 R 语言中
ggplot2那种图形语法(Grammar of Graphics),Altair 是首选。它用高度规范的 JSON 规范描述统计关系,天然支持“框选联动”(Linked Brushing)。其性能边界在于:由于默认将数据全量内嵌在前端 Vega 规约中,通常限制在 5,000 行以内以避免体积膨胀。 - Pydeck(基于 Uber deck.gl 的 3D 与地理空间引擎):当可视化需求涉及三维点云、建筑物多边形挤出、百万级轨迹热力图或无人驾驶传感器数据时,Pydeck 直接封装了 WebGL2 与 GPU 实例化绘制技术,是地理信息空间可视化的性能标杆。
三、核心技术特性与综合指标对比
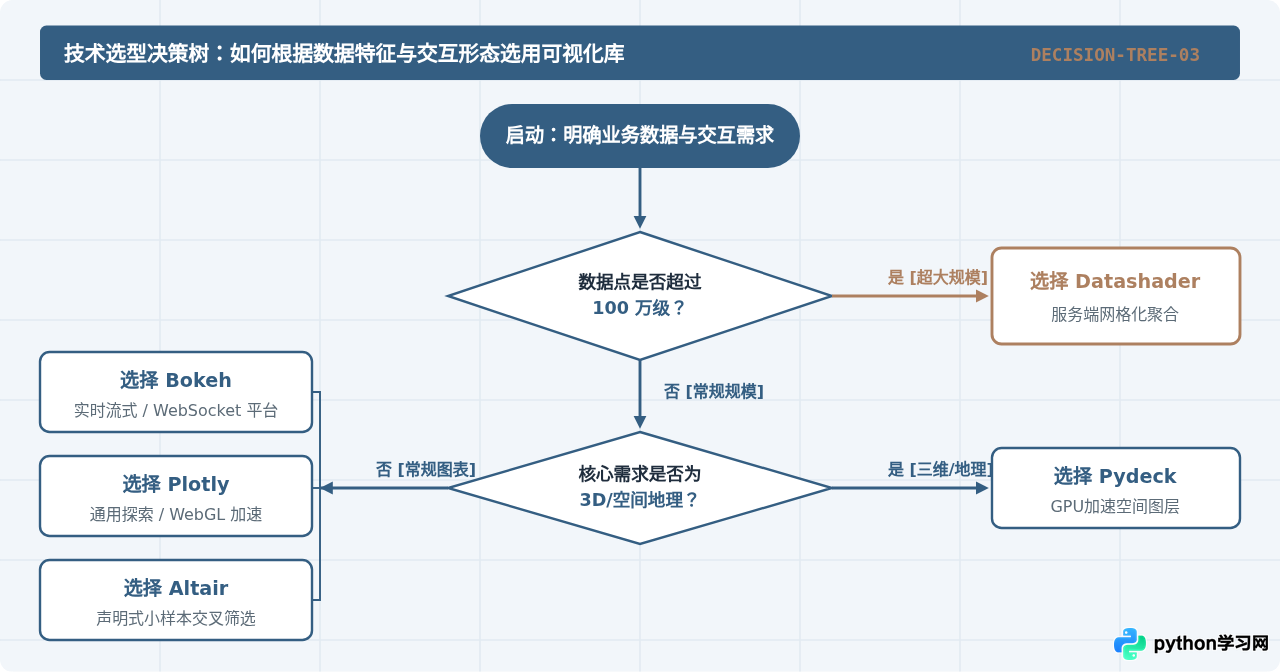
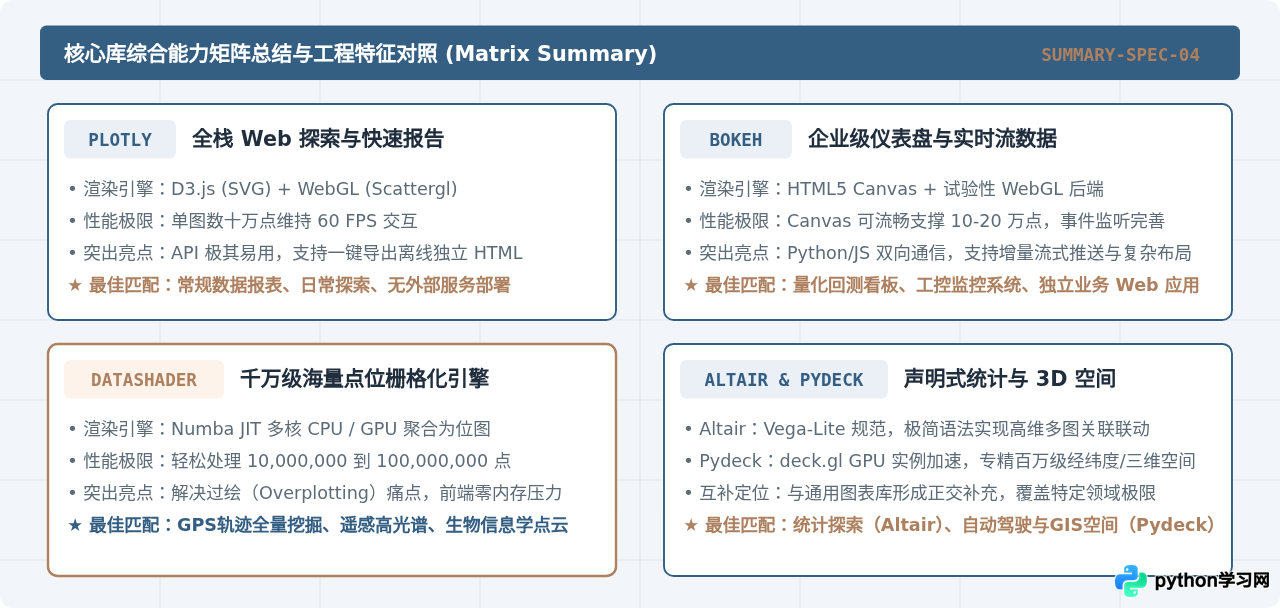
为了帮助读者根据实际项目规模进行选型,下表对 Matplotlib 及上述 5 款主流交互式绘图库的核心技术指标进行了横向归纳:
| 库名称 | 主要渲染后端 | 单图承载数据量 | 典型交互能力 | 学习曲线 | 最适合的应用场景 |
|---|---|---|---|---|---|
| Matplotlib | CPU Agg / 桌面 GUI | 约 1万点(流畅) | 基础缩放/保存(桌面端) | 中等 | 学术论文插图、静态报告排版、探索初期打印 |
| Plotly | D3.js (SVG) / WebGL | 10万 - 50万点 (Scattergl) | 悬停框选、3D旋转、动态切片 | 平缓 (Express API) | 商业仪表盘、通用探索分析、独立HTML交付 |
| Bokeh | HTML5 Canvas / WebGL | 5万 - 20万点 | 多图联动、流式追加、自定义UI控件 | 中等 | 监控大屏、WebSocket实时应用、复合数据分析平台 |
| Datashader | 服务端 Numba / Dask 网格化 | 100万 - 1亿点以上 | 视口动态重算平移缩放 | 较陡 | 大规模点云、全量轨迹挖掘、天文/气象/遥感高密数据 |
| Altair | Vega-Lite (Canvas / SVG) | 通常 < 5000 行(可结合Server) | 交互式筛选、交叉过滤、多图层联动 | 平缓 | 探索性统计分析、严谨学术图表、交互式仪表小部件 |
| Pydeck | deck.gl (WebGL2 GPU实例化) | 50万 - 500万空间图元 | 三维相机视角旋转、多层空间图元叠合 | 中等 | 智慧城市、车载轨迹定位、高密度3D柱状与网格图 |
四、工程落地避坑指南与性能调优建议
在生产环境中实际部署上述交互式绘图工具时,仅替换库名称往往不足以达到最佳性能。以下是经过验证的工程优化策略:
-
避免无节制的 JSON 数据内联:
默认情况下,
fig.write_html()会将整个 DataFrame 转换为 JSON 嵌入在 HTML 文件内部。如果数据量达到数十万条,生成的单个 HTML 文件可能突破 50 MB,极大地拖慢浏览器下载与解析时间。对于离线分发场景,应先在 Python 端使用例如 LTTB(Largest-Triangle-Three-Buckets)等保持形状的降采样算法,将绘图点数压缩至视口像素上限。 -
正确处理连续动态刷新:
在需要每秒更新多次的监控场景下,切忌在循环中反复调用
fig.show()或重新生成完整的图表对象。在 Bokeh 中应始终使用source.stream(),在 Plotly 中应结合 Dash 的extendData回调,仅在网络间发送新到达的增量切片。 -
关注移动端兼容性与 WebGL 上下文销毁:
部分低端移动设备或嵌入式 WebView 对 WebGL 顶点缓冲区的容量有限制。当多标签页或单页应用频繁切换包含
Scattergl的图表时,需手动调用图表的清空或销毁接口,防止显存泄漏导致浏览器 Tab 崩溃。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















