


大模型应用开发常见报错解析:API连接超时与速率限制处理

代码跑得好好的,突然抛出一个 ConnectionTimeout 或者冷不丁蹦出个 429 Too Many Requests,这种时刻最搞人心态。尤其是当你正急着向老板演示Demo,或者赶着上线新功能时,屏幕上一片红色的报错 traceback 简直让人头大。别慌,这通常不是你的代码逻辑崩了,而是大模型服务端的“交通状况”出了点小插曲。
遇到这类问题,最先要做的不是盲目改代码,而是看清报错的具体类型。是网络不通?还是被服务器“请”出去了?亦或是你发给它的指令它根本听不懂?分清这三者,解决思路完全不同。
1. 解决 API 连接超时:检查网络与超时设置
如果你看到的报错是 requests.exceptions.ConnectionTimeout 或类似的 ReadTimeout,这意味着你的程序发出了请求,但在规定时间内没收到服务器的回应。这就像你给朋友打电话,一直响铃却没人接。
首先,确认你的网络环境是否能访问目标 API 服务商。很多大模型服务部署在海外,本地直连可能不稳定。你可以尝试在终端 ping 一下域名,或者用 curl 简单测试连通性。如果网络本身没问题,那大概率是代码里的“耐心”不够。
大多数 HTTP 客户端库(如 Python 的 requests 或 httpx)都有默认的超时时间,通常只有几秒。对于大模型这种需要生成大量文本的任务,几秒往往不够。你需要显式地增加超时阈值。
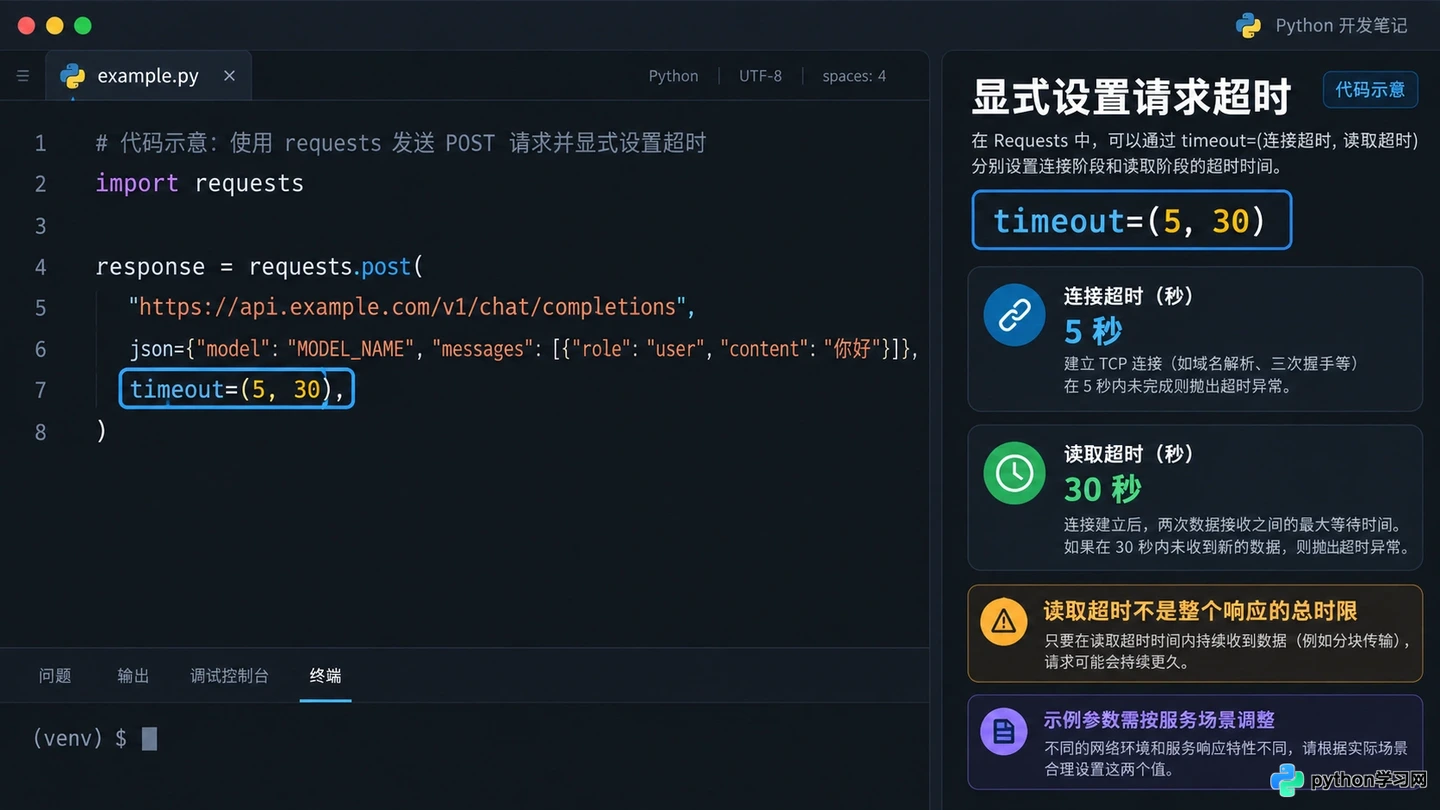
在HTTP请求中显式设置connect和read超时时间
在代码中,不要使用无限等待,而是设置一个合理的 timeout 参数。例如,将连接超时设为 10 秒,读取超时设为 60 秒甚至更长,具体取决于你预期的生成长度。同时,建议加入简单的重试逻辑,因为偶尔的网络抖动是常态。
import requests

url = "https://api.example.com/v1/chat/completions"
headers = {"Authorization": "Bearer YOUR_API_KEY"}
payload = {"model": "gpt-3.5-turbo", "messages": [{"role": "user", "content": "Hello"}]}

try:
    # 设置连接超时5秒,读取超时30秒
    response = requests.post(url, json=payload, headers=headers, timeout=(5, 30))
    response.raise_for_status()
    print(response.json())
except requests.exceptions.Timeout:
    print("请求超时,请稍后重试")
except requests.exceptions.RequestException as e:
    print(f"请求失败: {e}")
注意,超时时间设得过长会导致线程阻塞,影响用户体验;设得过短则容易误杀正常请求。根据实际业务场景调整这个平衡点是关键。
2. 应对 429 速率限制:实现指数退避重试
当报错状态码为 429,且消息中包含 Rate limit exceeded 或 Quota exceeded 时,说明你触发了服务商的频率限制。这就像高速公路限速,你开得太快或被太多车挤占,交警让你靠边停一会儿。
这种情况通常有两个原因:一是你的并发请求太多,超过了每秒/每分钟的配额;二是你的账户余额不足或套餐等级较低,限制了总吞吐量。
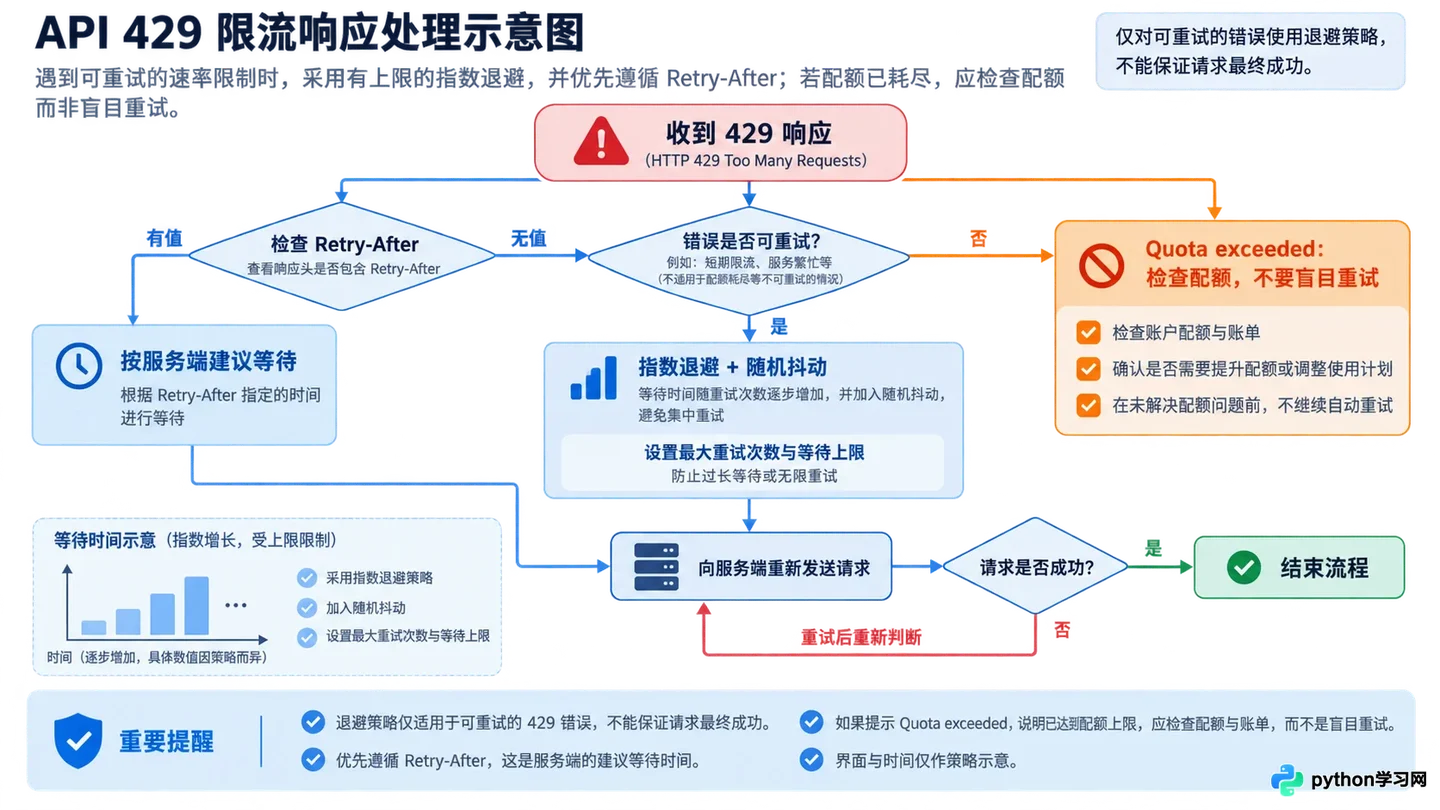
指数退避策略:重试等待时间随失败次数增加而延长
最优雅的解决方案不是硬着头皮继续发请求,而是实现“指数退避”(Exponential Backoff)重试机制。简单来说,就是第一次失败等 1 秒,第二次等 2 秒,第三次等 4 秒,以此类推,直到成功或达到最大重试次数。
许多成熟的 SDK(如 OpenAI 的官方库)已经内置了这种重试机制,只需开启即可。如果是自研 HTTP 请求,可以手动实现一个简单的装饰器或循环逻辑。
此外,检查响应头中的 Retry-After 字段。服务端通常会明确告诉你:“请等待 X 秒后再试”。尊重这个时间,比盲目重试更有效,也能避免账号被暂时封禁。
3. 修正 400 参数错误:核对模型名称与格式
如果返回的是 400 Bad Request,那问题出在你发送的数据上。服务器收到了请求,但发现内容不符合规范,拒绝处理。这就像你去餐厅点菜,报了一个菜单上没有的菜名。
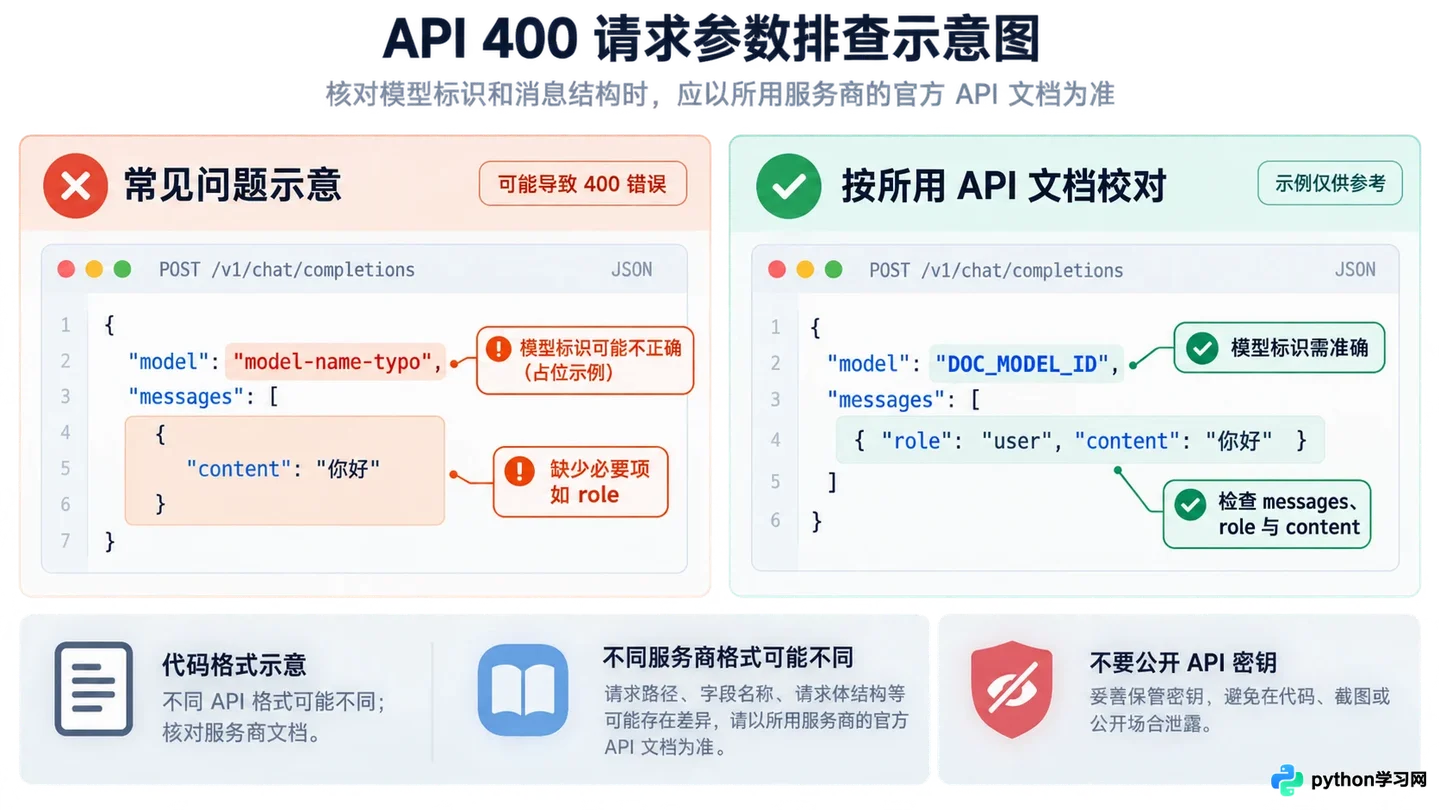
核对请求体中的模型名称和消息格式是否符合文档规范
最常见的错误包括:
- 模型名称拼写错误:比如把
gpt-3.5-turbo写成了gpt-3.5或chatgpt。务必查阅最新文档,确认模型 ID 的准确写法。 - 消息格式不符:某些接口要求
messages必须是列表,且每个元素包含role和content。如果漏掉了role,或者传入了不支持的系统角色,都会报错。 - Token 超出限制:虽然这有时返回 400,但也可能返回 413。检查你的输入文本长度是否超过了该模型的最大上下文窗口。
调试时,打印出完整的请求 payload(注意脱敏 API Key),并与官方文档的示例进行逐字对比。很多时候,多一个空格或少一个括号,都会导致解析失败。
4. 排查 401/403 认证失败:检查密钥权限
最后,如果遇到 401 Unauthorized 或 403 Forbidden,请立刻检查你的 API Key。这相当于门禁卡失效或权限不足。
确认 Key 是否复制完整,有没有多余的空格。同时,登录服务商控制台,查看该 Key 是否已过期,或者是否被限制了 IP 地址访问。如果是企业级应用,还需确认当前账号是否有调用特定模型的权限。
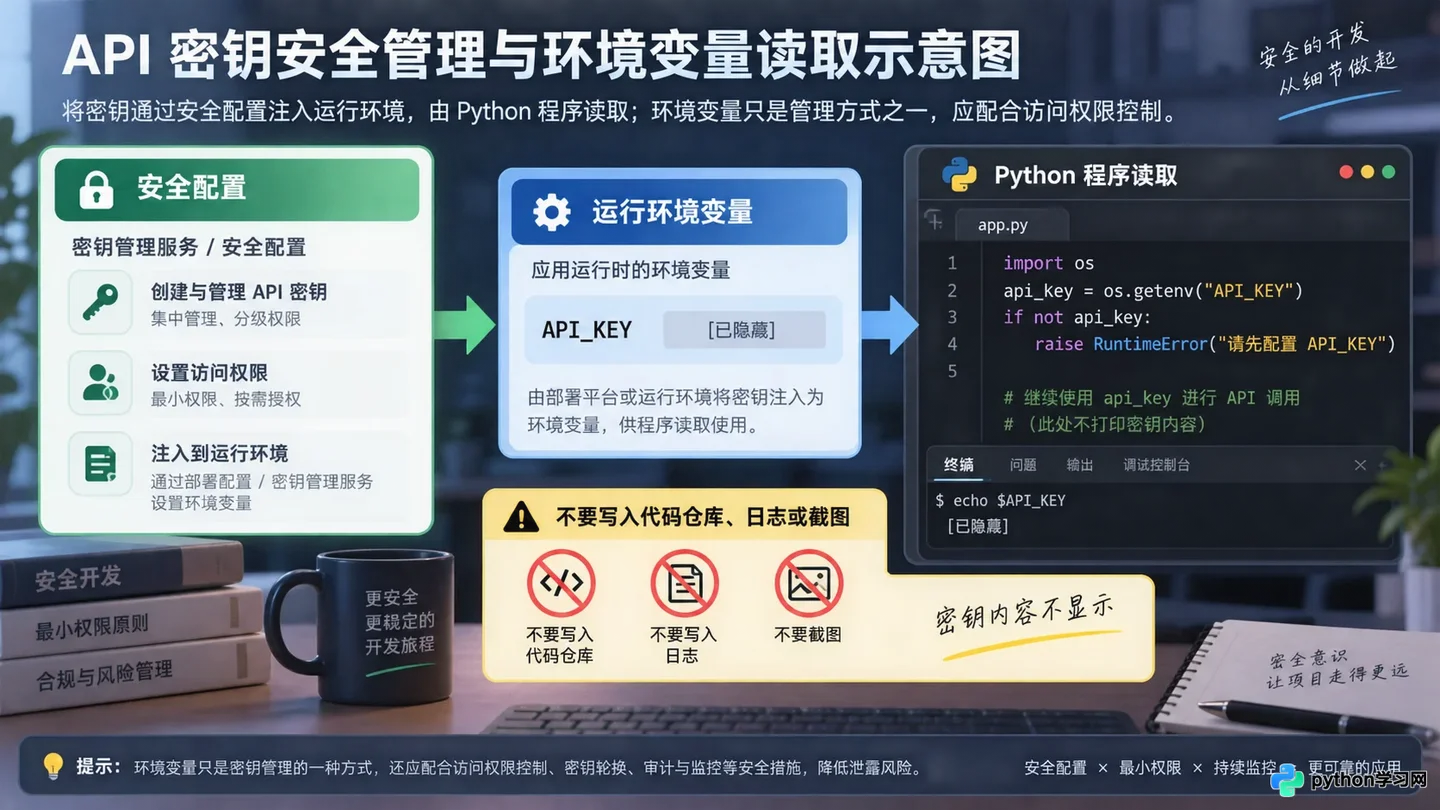
通过环境变量安全加载API Key而非硬编码
保持密钥的安全存储至关重要,不要硬编码在代码中,建议使用环境变量加载。这样既方便切换不同环境的密钥,也能避免意外泄露。
大模型开发中的报错大多是有迹可循的。遇到超时调大耐心,遇到限流学会等待,遇到参数错误仔细核对文档。养成查看完整错误信息和响应头的习惯,能让你在调试路上少走很多弯路。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















