


Python Matplotlib图表中文乱码怎么解决及字体自定义

一、Matplotlib 中文乱码成因与直观表现
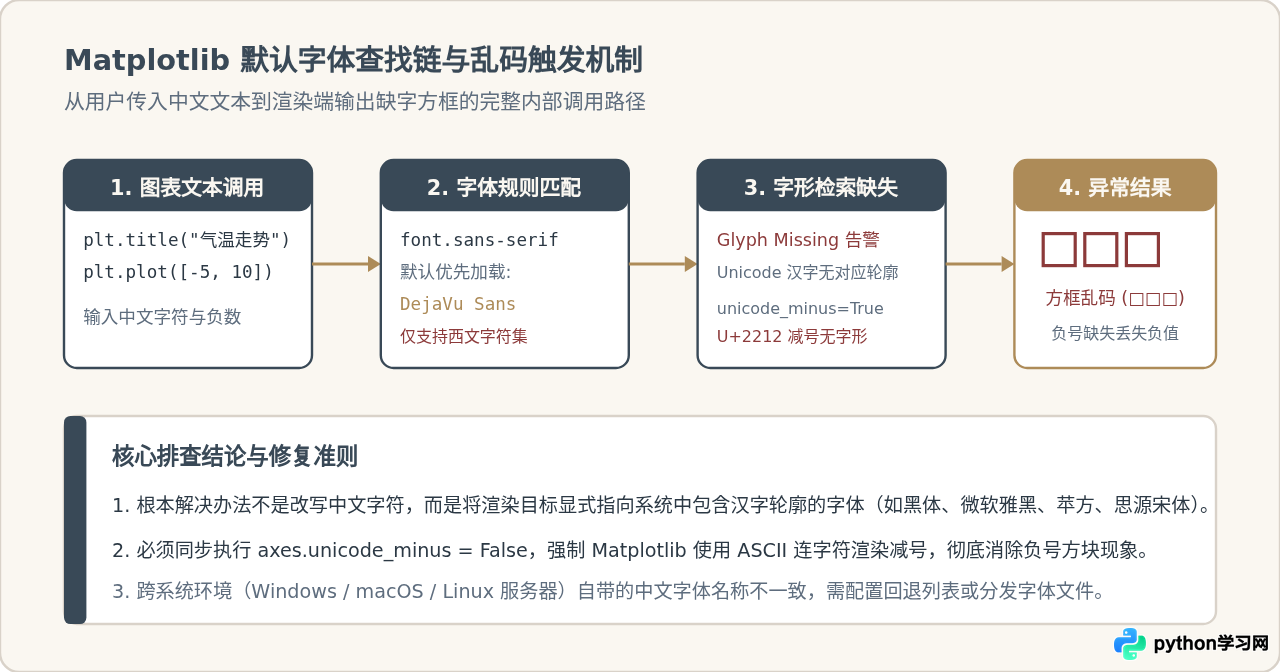
初次在 Python 脚本中使用 plt.title("某城市月度气温走势") 或 plt.xlabel("月份") 时,生成的图表往往不会正常呈现汉字,而是在终端抛出一长串警告:UserWarning: Glyph 26576 missing from current font.。图表界面上对应的文字位置则被替换为一个或多个空心方框。
这是因为 Matplotlib 在初始化时,默认的字体族(font.family)指向 sans-serif(无衬线字体),其内部候选列表首位是 DejaVu Sans。这是一套为西文字符设计的开源字体,在其字库字形表(Glyph Table)中根本没有包含 CJK(中日韩)汉字的字符映射。当渲染引擎尝试根据 Unicode 码点绘制汉字时,找不到对应的矢量轮廓,只能使用缺字备用符号(即方块)代替。
除此之外,若图表坐标轴包含负数(例如气温 -5℃),负号经常也会同步变成方块。这并非中文专属问题,而是 Matplotlib 默认开启了 axes.unicode_minus = True。它会尝试使用 Unicode 编码 U+2212(Minus Sign 减号)而非 ASCII 标准的连字符 -(Hyphen-minus,ASCII 45)来绘制负号,许多中文字体库同样缺少该特殊减号符号,导致负号连带损坏。
二、方法一:配置全局 rcParams(快捷有效)
针对日常数据分析、Jupyter Notebook 或个人电脑环境,最快见效的方式是通过 matplotlib.pyplot.rcParams 动态修改全局运行时参数。
不同操作系统内置的中文字体名称各不相同。如果在脚本中硬编码单一字体名称(例如只写 SimHei),代码在 Windows 上运行正常,但在 macOS 或 Linux 上又会因找不到该字体再次回退为乱码。因此推荐在 font.sans-serif 中传入一个包含多平台常见字体的优先列表:
import matplotlib.pyplot as plt

# 1. 设置中文字体优先回退列表(覆盖 Windows、macOS 及 Linux 常见字体)
plt.rcParams['font.sans-serif'] = [
    'PingFang SC',         # macOS 苹方
    'Microsoft YaHei',    # Windows 微软雅黑
    'SimHei',             # Windows 黑体
    'WenQuanYi Micro Hei',# Linux 文泉驿微米黑
    'Noto Sans CJK SC',   # 通用思源黑体
    'sans-serif'          # 兜底无衬线
]

# 2. 正常显示负号(解决负数变成方框的问题)
plt.rcParams['axes.unicode_minus'] = False

# 示例绘图验证
categories = ['一季度', '二季度', '三季度', '四季度']
values = [-12.5, 25.0, 18.2, -6.8]

fig, ax = plt.subplots(figsize=(6, 4))
ax.bar(categories, values, color='#394957')
ax.set_title("季度净利润率变动(%)")
ax.set_ylabel("净利率")
ax.grid(axis='y', linestyle='--', alpha=0.5)

plt.show()
各大操作系统常见的中文字体名称对比如下表所示。在编写跨平台代码时,建议将目标平台的对应字体排在列表靠前位置:
| 操作系统 | 常用中文无衬线体名称 | 常用中文衬线/仿宋体名称 | 系统预装状态 |
|---|---|---|---|
| Windows | Microsoft YaHei、SimHei |
SimSun(宋体)、KaiTi |
绝大多数版本默认预装 |
| macOS | PingFang SC、Heiti SC |
Songti SC、Kaiti SC |
系统自带,无需安装 |
| Linux (Ubuntu/Debian) | WenQuanYi Micro Hei、Noto Sans CJK SC |
WenQuanYi Zen Hei |
通常需 apt 安装 fonts-wqy-microhei |
三、方法二:使用本地字体文件与 FontProperties(推荐项目级规范)
在商业项目、团队协作或部署到无桌面环境的 Linux Docker 容器时,全局依赖宿主机安装的字体往往脆弱不可靠。不同团队成员的机器环境各异,极易产生渲染差异或在 CI/CD 中断裂。
最稳健、工程化标准最高的方式是:将开源中文字体文件(如思源黑体 SourceHanSansSC-Regular.otf 或阿里普惠体 .ttf)直接存放在代码仓库的资源目录中,通过 matplotlib.font_manager.FontProperties 显式加载。
这种方式具有以下优势:
- 零系统环境依赖:无论是本地 Windows、macOS 还是远程 Linux 服务器,只要 Python 能读取该文件,就能保证 100% 正确出图。
- 完全不污染全局配置:可以为不同图表元素指定不同的字体与粗细,例如大标题用粗体,轴标签用细体。
- 渲染效果跨平台绝对一致:字体度量完全统一,排版比例和行距在不同操作系统下完全吻合。
import os
import matplotlib.pyplot as plt
from matplotlib.font_manager import FontProperties

# 1. 定位项目内的字体文件路径(支持 .ttf 与 .otf 格式)
# 建议将字体保存在例如 ./fonts/SourceHanSansSC-Regular.otf
current_dir = os.path.dirname(os.path.abspath(__file__)) if '__file__' in locals() else '.'
font_path = os.path.join(current_dir, "fonts", "SourceHanSansSC-Regular.otf")

# 2. 实例化字体属性对象,可单独设置字号
my_font = FontProperties(fname=font_path, size=11)
title_font = FontProperties(fname=font_path, size=14)

# 3. 依旧保留负号修正
plt.rcParams['axes.unicode_minus'] = False

# 4. 在具体绘图 API 中通过 fontproperties 参数传入
fig, ax = plt.subplots(figsize=(7, 4.5))
ax.plot(['1月', '2月', '3月', '4月'], [12, -4, 8, 15], marker='o', color='#AD8B58')

# 在需要显示中文的具体位置挂载字体
ax.set_title("月度指标监测数据", fontproperties=title_font, color='#394957', pad=12)
ax.set_xlabel("监控周期", fontproperties=my_font)
ax.set_ylabel("偏差数值(点)", fontproperties=my_font)

for label in ax.get_xticklabels() + ax.get_yticklabels():
    label.set_fontproperties(my_font)

plt.show()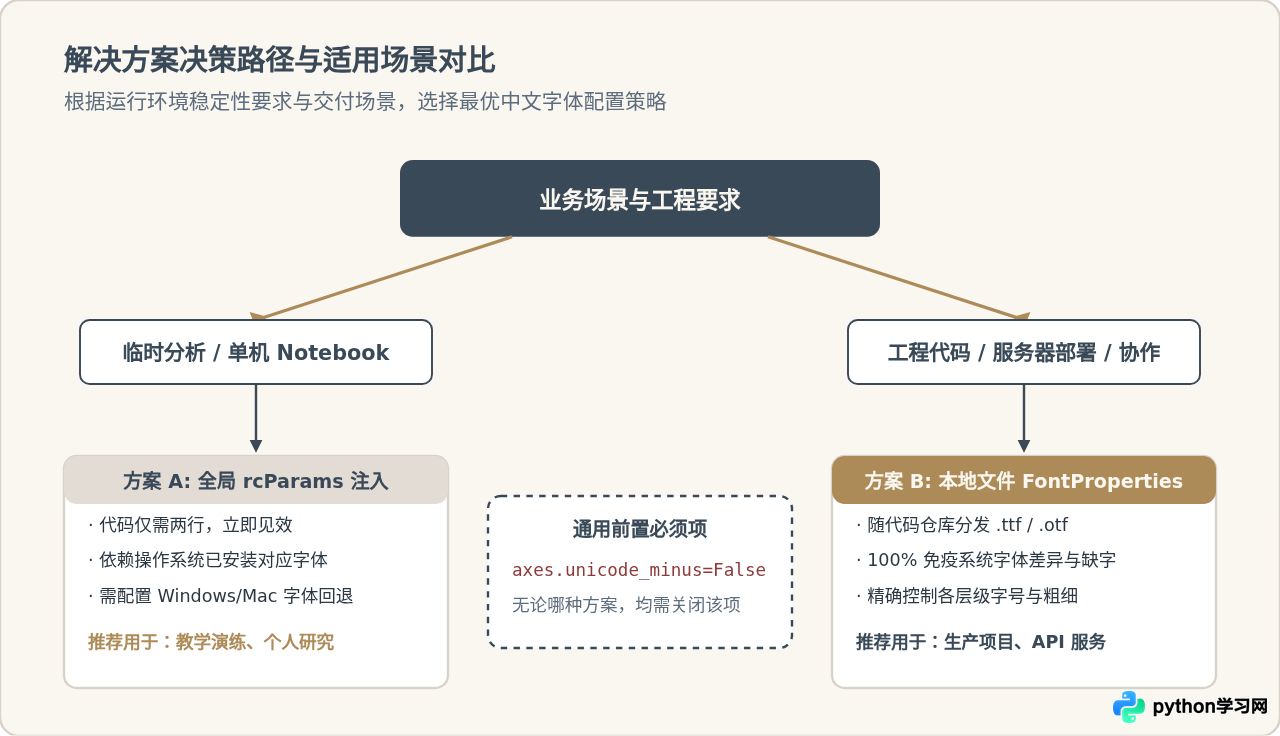
四、字体配置作用域与层级优先级
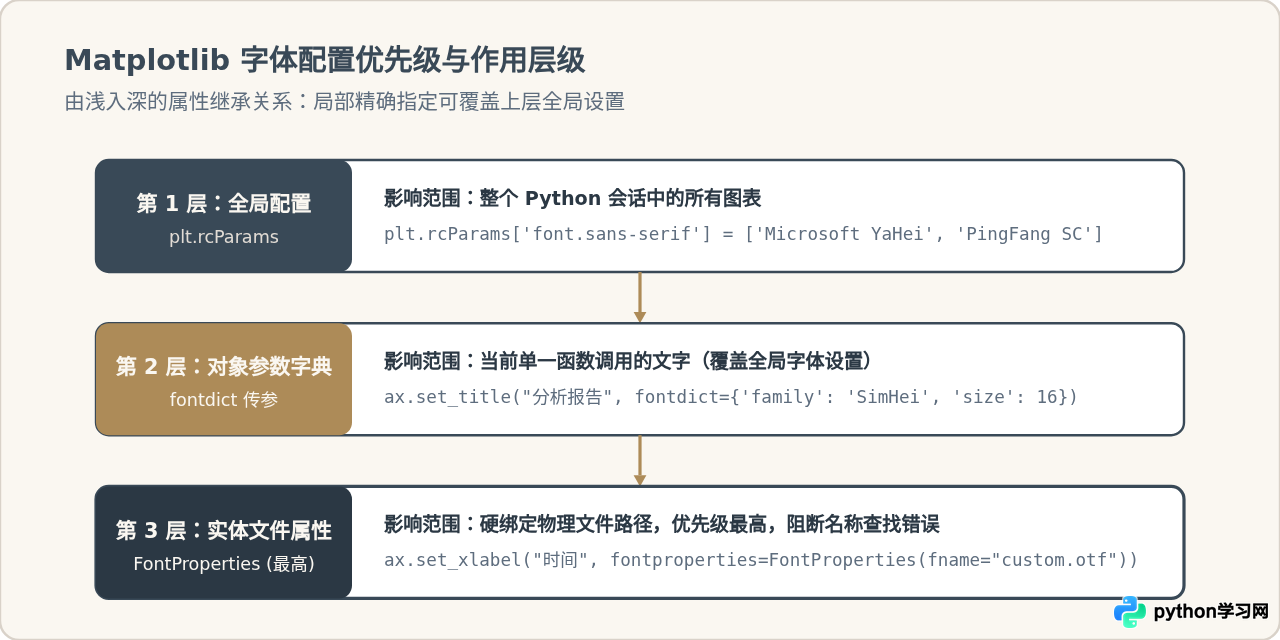
为了在复杂图表中实现精细化的视觉排版,需要理解 Matplotlib 内部对字体的多层覆盖机制。从最底层的全局默认值,到最高优先级的单个元素定制,优先级从低到高排列如下:
- 系统与库默认配置:Matplotlib 安装目录下的
matplotlibrc静态配置文件。 - 运行时全局会话层(
rcParams):在当前脚本中执行的plt.rcParams['font.sans-serif']。所有在此之后创建的Figure和Axes均继承该属性。 - 文本参数字典层(
fontdict):调用ax.set_title(..., fontdict={'family': '...', 'size': 16})。只对当前文本对象生效,覆盖全局字体族设置。 - 独立字体属性对象(
FontProperties):直接传递fontproperties=...。这是权重最高的方式,直接绕过字体管理器的系统名称映射,强行绑定指定字体文件或族名。
五、排查技巧:新装字体识别失败与缓存清理
有时用户虽然在操作系统中下载安装了中文字体(例如在 Windows 安装了思源黑体,或在 Linux 下把字体文件复制到了 /usr/share/fonts/),并且也在 rcParams 里配置了该字体名字,但绘制图表时依然出现乱码。
这通常是因为 Matplotlib 的字体缓存机制。在初次导入该库时,Matplotlib 会全面扫描系统字体目录并生成一个名为 fontlist-vXXX.json 的索引缓存文件。随后为了加快加载速度,它只会查询此缓存而不会每次重新扫描磁盘。新安装的字体如果没有触发缓存重建,就会被视作不存在。
1. 查看当前已成功识别的中文字体列表
可以通过运行以下轻量脚本,快速打印出当前 Python 环境下 Matplotlib 真正识别到了哪些中文字体:
import matplotlib.font_manager as fm

# 获取 Matplotlib 字体管理器中所有已注册字体的名称
available_fonts = sorted({f.name for f in fm.fontManager.ttflist})

# 筛选包含常见中文标识或关键词的字体
chinese_keywords = ['SC', 'Sim', 'Hei', 'Song', 'Kai', 'Ming', 'YaHei', 'Noto', 'WenQuanYi']
detected_chinese = [f for f in available_fonts if any(k.lower() in f.lower() for k in chinese_keywords)]

print("当前已识别的中文字体名称(可直接填入 rcParams):")
for name in detected_chinese:
    print(f" - {name}")
2. 清除字体缓存缓存文件
如果列表中没有新安装的字体,只需要定位并删除 Matplotlib 缓存目录。在 Python 中直接获取缓存路径:
import matplotlib

# 输出缓存所在的系统真实路径
print("缓存目录:", matplotlib.get_cachedir())
在终端中进入该目录,找到并删除以 fontlist- 开头、后缀为 .json 的文件(例如 fontlist-v330.json)。再次运行 Python 绘图代码时,Matplotlib 会重新全盘扫描系统字体,新字体便能正常加载。
六、全流程排查四步法总结
掌握了成因、方案与排查手段后,面对任何环境下的中文乱码问题,只需按以下四步稳妥推进:
- 第一步(明确目标字体):优先检查系统是否已有中文字体名;若需要严谨部署,则将
.ttf/.otf字体放进代码目录。 - 第二步(规范配置注入):根据是个人使用还是工程部署,选择
rcParams['font.sans-serif']列表回退,或使用FontProperties(fname=...)。 - 第三步(关闭负号转换):务必加入
plt.rcParams['axes.unicode_minus'] = False,防止减号损坏。 - 第四步(缓存刷新与出图验证):若字体未生效,利用
get_cachedir()清理fontlist缓存并运行测试出图。
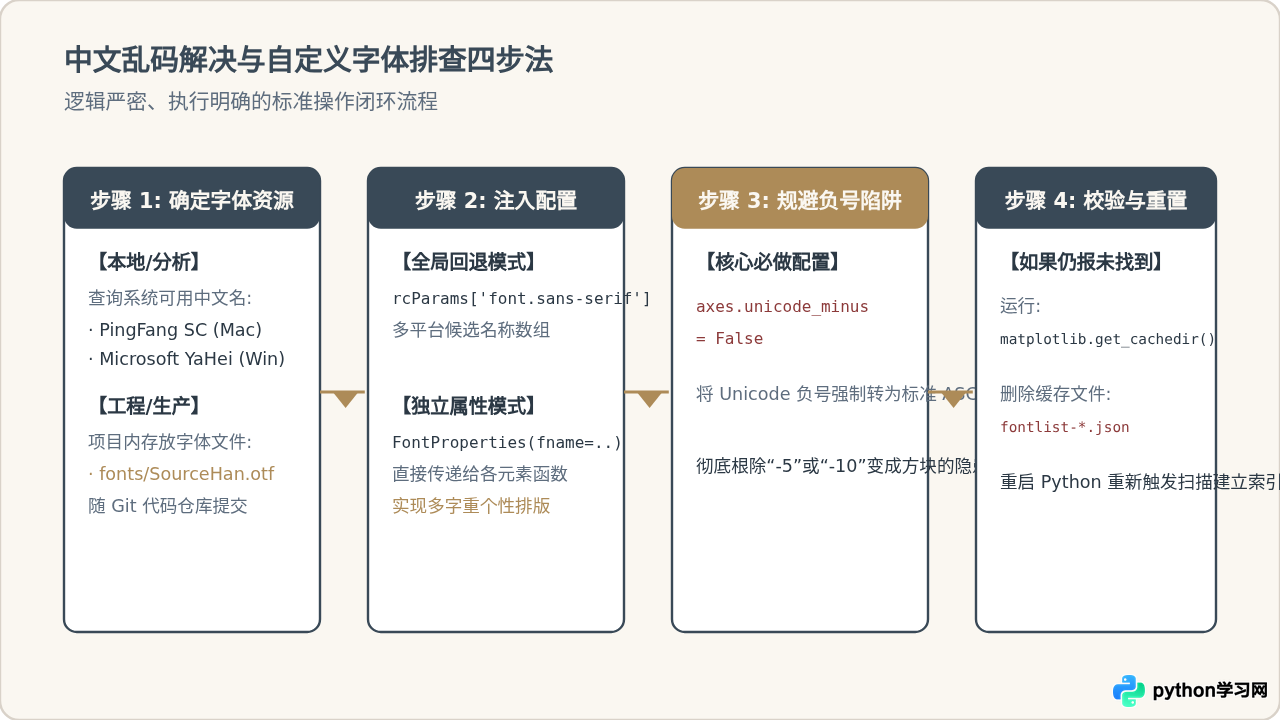
FontProperties 引入 + axes.unicode_minus = False”的组合。这能从根源上杜绝跨平台系统差异带来的各种缺字和方框隐患。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















