


面试必备:Python基础100题中的高频考点与解题思路

一、高频考点的分布特征与考查重点
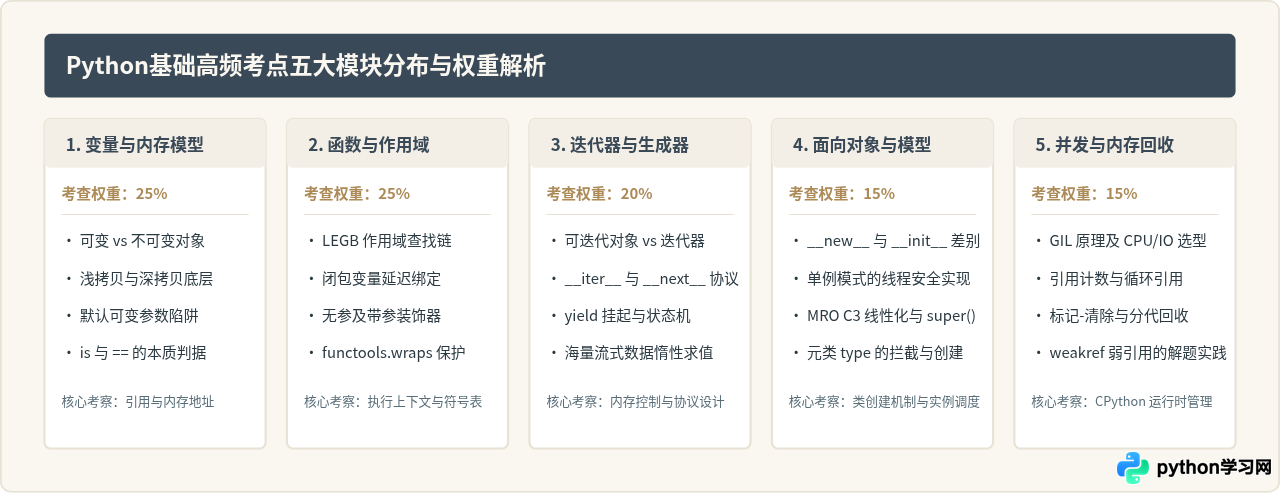
分析技术面试中的Python基础真题可以发现,考官的核心目的在于甄别“只会调用API”与“真正理解语言机制”的开发者。题目的命制往往建立在看似简单、但在特定边界条件下容易产生非预期行为的代码片段上。
这些高频问题主要分布在五个维度:底层数据对象与引用机制、函数作用域与高级特性、迭代生成协议与内存优化、面向对象模型与继承拓扑、并发调度与垃圾回收机制。掌握这些维度的核心差异与原理,能够应对绝大部分变形题目。
二、变量绑定、引用传递与深浅拷贝
在 Python 中,“变量不是存储数据的盒子,而是贴在对象上的标签”。这是解答一切可变对象陷阱、函数默认参数及对象拷贝问题的认知基石。
1. 函数默认参数可变陷阱
经典面试题:“以下代码输出什么?为什么?”
def append_item(val, target_list=[]):
    target_list.append(val)
    return target_list

print(append_item(1))  # 期望 [1],得到 [1]
print(append_item(2))  # 期望 [2],得到 [1, 2]
print(append_item(3))  # 期望 [3],得到 [1, 2, 3]
底层原因与答题思路:
在 Python 编译并加载该函数模块时,def 语句仅被执行一次,此时默认参数 target_list=[] 所引用的列表对象已在内存中创建并绑定到该函数的 __defaults__ 属性上。每次以省略实参的方式调用函数时,形参 target_list 均指向同一块由 __defaults__ 引用的内存地址。调用 append 是就地修改(in-place mutation),因此所有调用会产生状态累积。
标准解法:将默认参数设置为不可变的哨兵值 None,在函数体内部动态创建新容器:
def append_item_safe(val, target_list=None):
    if target_list is None:
        target_list = []
    target_list.append(val)
    return target_list
2. 深拷贝(deepcopy)与浅拷贝(copy)的本质边界
面试中经常要求现场手写或说明切片拷贝 lst[:]、copy.copy() 和 copy.deepcopy() 的差异:
- 赋值(=):不创建新对象,仅增加原对象的引用计数。修改任何层级均直接反映在原变量上。
- 浅拷贝(copy.copy 或 list(lst) 或 lst[:]):在内存中创建最外层的新容器对象,但内部子元素依然仅仅复制引用地址。若内部包含可变子对象(如嵌套列表、字典),修改子对象会相互影响。
- 深拷贝(copy.deepcopy):递归复制容器内的所有嵌套对象。深拷贝内部维护了一个
memo字典,用于记录已访问对象的内存地址,防止因相互引用导致的无限递归死循环。
三、作用域链与闭包的延迟绑定解析
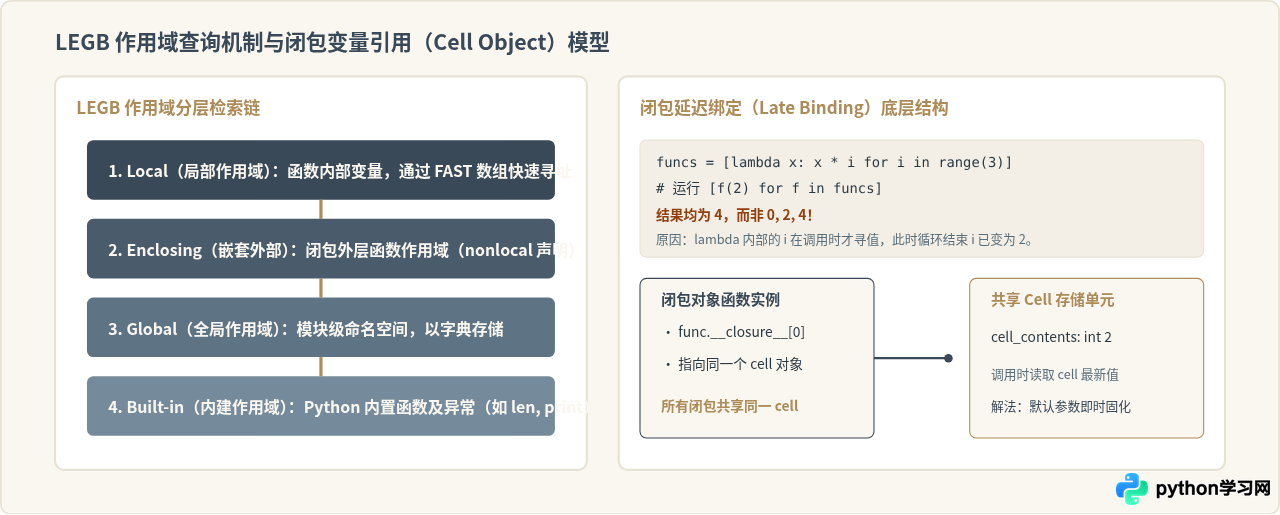
作用域查找遵循 LEGB 原则,即依次检索 Local(函数局部作用域)→ Enclosing(嵌套闭包作用域)→ Global(模块全局作用域)→ Built-in(内建作用域)。如果在当前作用域发生赋值且未声明 global 或 nonlocal,Python 编译器会在编译阶段将该变量标识为局部变量。
1. 闭包延迟绑定的标准解法
解决循环中创建闭包导致变量均为最后状态的问题,最优雅的做法是利用默认参数即时求值并绑定的特性:
# 解法一:利用默认参数在函数定义时完成求值
funcs = [lambda x, i=i: x * i for i in range(3)]
print([f(2) for f in funcs])  # 输出: [0, 2, 4]

# 解法二:使用偏函数 functools.partial
from functools import partial
funcs_partial = [partial(lambda i, x: x * i, i) for i in range(3)]
print([f(2) for f in funcs_partial])  # 输出: [0, 2, 4]
2. 通用装饰器的手写规范
在面试中手写装饰器是必考题,漏掉 functools.wraps 通常会被扣除基本功分数:
import time
from functools import wraps

def time_it(func):
    """统计函数执行耗时的通用装饰器"""
    @wraps(func)  # 关键:保留原函数的 __name__、__doc__、__annotations__
    def wrapper(*args, **kwargs):
        start_time = time.perf_counter()
        result = func(*args, **kwargs)
        elapsed = time.perf_counter() - start_time
        print(f"[执行统计] {func.__name__} 耗时: {elapsed:.6f}s")
        return result
    return wrapper
四、迭代协议与生成器的流式解题范式
很多算法面试题(如海量日志统计、超大文件排序)的核心考察点并非复杂的动态规划,而是内存控制。考官希望看到候选人使用生成器(Generator)进行惰性计算。
1. 可迭代对象(Iterable)与迭代器(Iterator)
- 可迭代对象:实现了
__iter__()方法,且该方法必须返回一个迭代器对象。例如list,dict,set。 - 迭代器:同时实现了
__iter__()和__next__()方法。__next__()在每次调用时返回下一个值,耗尽时抛出StopIteration异常;其__iter__()返回它自身。
2. 面试真题:超大日志文件的高效逐行处理
题目:“现在有一个 50GB 大小的文本日志文件,服务器可用物理内存仅有 2GB,请编写一个函数读取每行并匹配特定关键词。”
def stream_large_file(file_path, chunk_size=8192):
    """利用生成器分块读取超大文件,避免内存爆裂并精确处理跨行切断"""
    with open(file_path, "r", encoding="utf-8") as f:
        carry = ""
        while True:
            chunk = f.read(chunk_size)
            if not chunk:
                if carry:
                    yield carry
                break
            lines = (carry + chunk).split("\n")
            carry = lines.pop()  # 最后一行可能不完整,保留至下一个分块
            for line in lines:
                yield line

def filter_error_logs(file_path):
    for line in stream_large_file(file_path):
        if "ERROR" in line:
            # 仅处理命中行,内存占用稳定维持在 KB 级
            yield line.strip()
五、代码实战题的系统化解题四步法
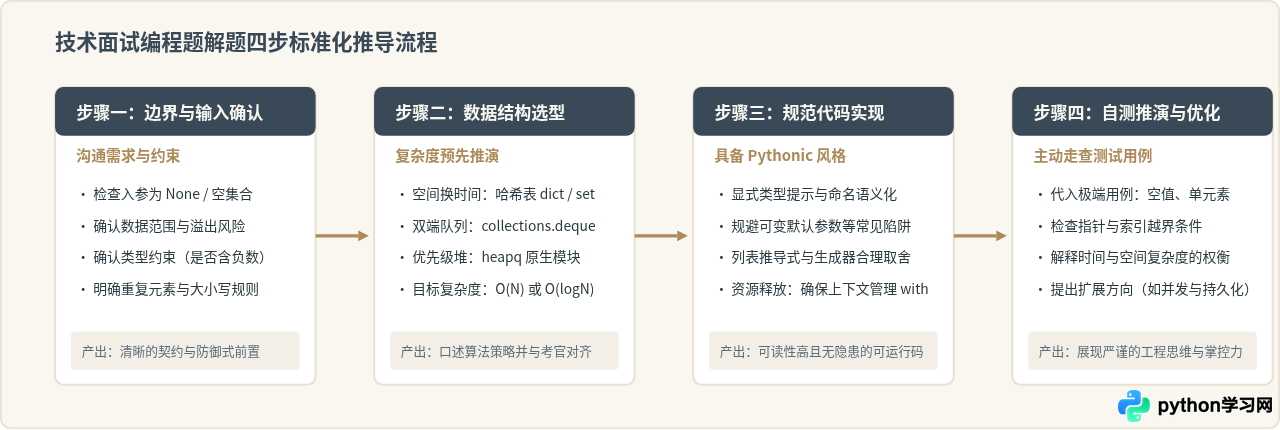
在面试现场编写 Python 代码题时,很多候选人急于下笔,往往因为未考虑边界、空间复杂度过高或未处理异常而导致失败。建立系统化的解题步骤至关重要。
六、并发与运行时机制:GIL 与垃圾回收
面试到中高级岗位时,CPython 的底层机制是拉开差距的关键。
1. 全局解释器锁(GIL)的实质与应对策略
GIL(Global Interpreter Lock)是 CPython 解释器引入的一个互斥锁,其目的是保护解释器内部的内存管理非线程安全数据结构(如对象的引用计数)。这意味着:在任何给定时刻,单个 Python 解释器进程内只有一个线程能够执行 Python 字节码。
- CPU 密集型任务(大量矩阵计算、图像处理、循环加和):多线程不仅无法提高运行效率,反而因频繁的线程上下文切换与 GIL 争抢导致总耗时变长。解法:使用
multiprocessing多进程模块,利用多核 CPU;或使用 C/Rust 扩展(如 NumPy/Cython)在底层释放 GIL。 - I/O 密集型任务(网络爬虫、文件读写、数据库请求):当一个线程发起 I/O 调用进入阻塞状态时,会主动释放 GIL,允许其他线程运行。因此多线程
threading或异步协同asyncio均能显著提升吞吐量。
2. 垃圾回收机制的三层防线
Python 的垃圾回收(GC)主要由三套机制协同工作:
- 第一层:引用计数(Reference Counting)。这是最核心的基础机制。每个对象内部维护
ob_refcnt。当引用增加(赋值、作为参数传递、装入容器)时加 1;引用减少(离开作用域、del、从容器移除)时减 1。一旦计数归零,对象内存立即被释放。其优点是实时性高,但无法解决循环引用。 - 第二层:标记-清除(Mark-Sweep)。专门解决容器对象之间的循环引用问题。GC 会遍历所有双向链表维护的容器对象,通过“可达性分析”算法标记从根对象(全局变量、当前调用栈变量)可达的存活对象,清理孤立的循环引用节点。
- 第三层:分代回收(Generational Collection)。根据“对象存在时间越长,越不可能成为垃圾”的弱代假设,将对象分为 0 代、1 代、2 代。新创建的对象属于 0 代,经过一次 GC 仍然存活的升级到 1 代,以此类推。代数越低,触发 GC 的频率越高,从而大幅降低单次全量扫描的性能开销。
七、高频考点对照与解题总结矩阵
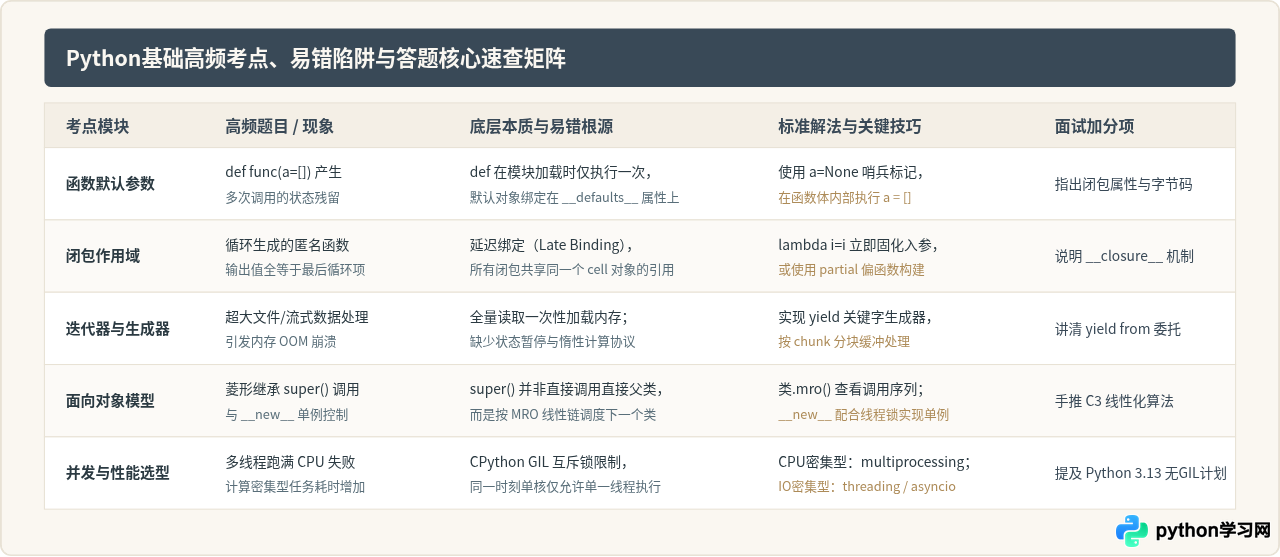
为了便于面试前快速自查与复习,下表及总结图汇总了高频考点、核心机制、典型陷阱及对应答题技巧:
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















