


Python使用difflib实现基础文本查重教程

在日常文本处理、作业批改或内容管理场景中,快速比对两篇文本是否存在抄袭或高度相似是常见需求。Python 内置的 difflib 标准库提供了现成的序列比对算法,无需安装任何第三方依赖,即可完成计算文本相似度、提取连续重复文本块以及生成重复率指标等基础查重任务。
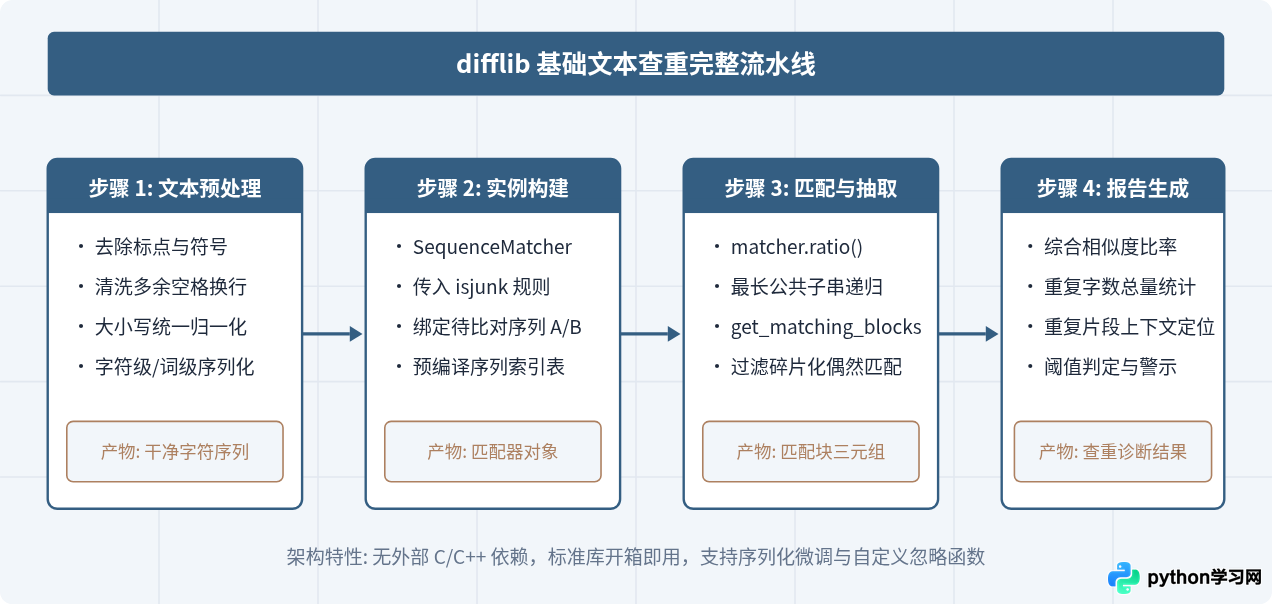
一、核心原理:difflib 的匹配算法与相似度公式
difflib 是 Python 专门用于计算可哈希序列相似度的标准库。在文本查重场景中,主要使用 difflib.SequenceMatcher 类。该类底层采用了 Gestalt Pattern Matching(Ratcliff-Obershelp 算法) 的变体。
它的核心工作逻辑是:在两段序列中寻找不包含“垃圾元素”(如空白字符)的最长连续公共子串;找到该匹配块后,以此块为界将序列切分为左右两部分,并在左右两侧递归执行相同的查找,直到无法找到更多匹配块为止。
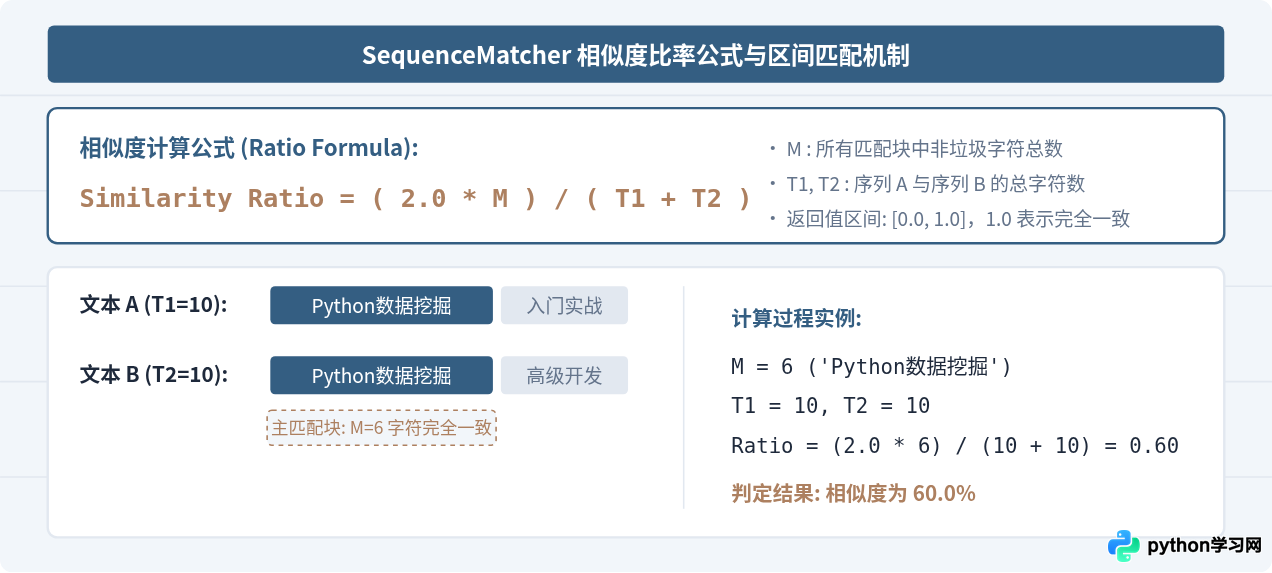
二、快速上手:计算两段文本的基础相似度
实现最基础的文本相似度计算非常简单。只需从标准库引入 SequenceMatcher,实例化时传入待比对的两个文本字符串,然后调用 .ratio() 方法即可。
import difflib

def calculate_similarity(text_a: str, text_b: str) -> float:
    """计算两段文本的相似度比率 (0.0 到 1.0)"""
    matcher = difflib.SequenceMatcher(None, text_a, text_b)
    return matcher.ratio()

if __name__ == "__main__":
    t1 = "Python标准库difflib可以用来比对字符串和计算序列相似度。"
    t2 = "使用Python内置的difflib模块可以比对文本并快速计算相似度。"

    score = calculate_similarity(t1, t2)
    print(f"文本 1 长度: {len(t1)}")
    print(f"文本 2 长度: {len(t2)}")
    print(f"相似度比率: {score:.4f} ({score * 100:.2f}%)")
文本 1 长度: 32文本 2 长度: 30相似度比率: 0.6129 (61.29%)
在这个示例中,SequenceMatcher(None, t1, t2) 的第一个参数为 isjunk,用于定义需要忽略的无意义字符。如果传入 None,表示所有字符均参与比对。
三、进阶排查:精确定位重复片段坐标
在实际查重任务中,仅给出一个百分比分值通常无法满足需求,运营者或批改者需要明确知道“哪些句子或段落重复了”。SequenceMatcher 提供了 get_matching_blocks() 方法,可以返回所有匹配子串的起始下标与长度。
该方法返回一个由 Match(a, b, size) 组成的三元组列表:
a: 该匹配块在文本 A 中的起始索引。b: 该匹配块在文本 B 中的起始索引。size: 匹配块的连续字符长度(最后一个元素固定为Match(len(A), len(B), 0),用于标识终止)。
import difflib

def extract_duplicate_blocks(text_a: str, text_b: str, min_length: int = 4):
    """
    提取两个文本中长度大于等于 min_length 的连续重复文本块
    """
    matcher = difflib.SequenceMatcher(None, text_a, text_b)
    blocks = matcher.get_matching_blocks()

    results = []
    total_matched_chars = 0

    for match in blocks:
        # 过滤掉末尾的终止哨兵及短于阈值的噪音块
        if match.size >= min_length:
            chunk_a = text_a[match.a : match.a + match.size]
            results.append({
                "start_a": match.a,
                "start_b": match.b,
                "length": match.size,
                "content": chunk_a
            })
            total_matched_chars += match.size

    # 计算有效重复率: 匹配字符数占两篇平均长度的比例
    effective_ratio = (2.0 * total_matched_chars) / (len(text_a) + len(text_b)) if (text_a or text_b) else 0.0

    return {
        "blocks": results,
        "total_matched_chars": total_matched_chars,
        "effective_ratio": effective_ratio
    }

# 测试长文片段提取
doc1 = "在自然语言处理中,文本查重是一个基础且关键的环节。通过比对算法可以识别异常抄袭。"
doc2 = "关于算法实战:在自然语言处理中,文本查重是一个基础且关键的环节。这是很常见的测试。"

res = extract_duplicate_blocks(doc1, doc2, min_length=6)
print(f"发现有效重复块数量: {len(res['blocks'])}")
for idx, b in enumerate(res['blocks'], start=1):
    print(f"[{idx}] 位置A:{b['start_a']} 位置B:{b['start_b']} 长度:{b['length']} 内容: \"{b['content']}\"")
print(f"有效重合度: {res['effective_ratio'] * 100:.2f}%")
发现有效重复块数量: 1[1] 位置A:0 位置B:7 长度:26 内容: "在自然语言处理中,文本查重是一个基础且关键的环节。"有效重合度: 60.47%
四、工具选型:difflib 模块各组件对比
difflib 模块内部包含多个不同用途的类与函数。在开发查重功能时,需要了解各个组件的分工,避免选用不恰当的工具增加性能负担。
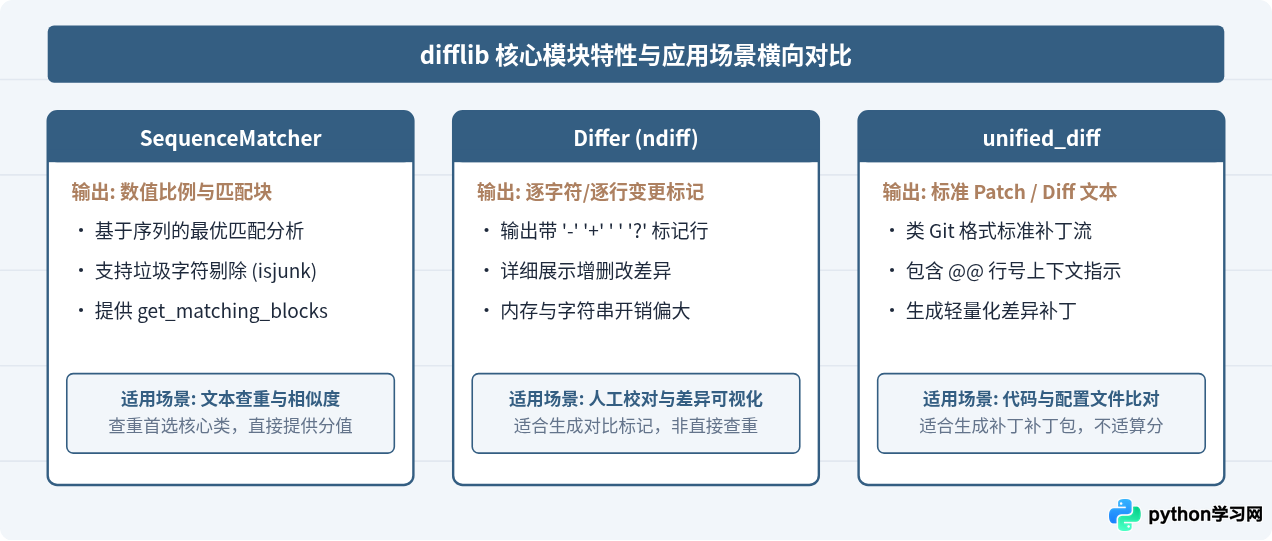
| 组件名称 | 主要返回结果 | 是否适合查重 | 主要用途 |
|---|---|---|---|
SequenceMatcher |
比率数值 (0.0~1.0)、匹配块索引三元组 | 是 (推荐) | 计算相似度分值、排重阈值过滤、截取重复段落 |
Differ |
增删改字符流与差异标注标记 | 否 | 人工比对文本、差异细节渲染、语法改动提示 |
unified_diff |
生成统一 diff 补丁文本(类似 git diff) | 否 | 版本管理补丁生成、代码及配置文件差异比对 |
五、关键预处理:提升查重准确率
直接将未经处理的原始文本(含有空格、换行符、HTML 标签、全半角标点)传给 SequenceMatcher,往往会导致两类问题:
- 假阳性匹配(虚高):文章中大量的标点、换行和格式化空白被判定为相同序列,拉高了最终的分值。
- 漏网匹配(偏低):抄袭者仅仅修改了全角逗号为半角逗号,或者插入了空格,导致整句被切断为细碎小块。
因此,在比对前进行规范化清洗至关重要:
import re
import difflib

def clean_text(raw_text: str) -> str:
    """文本标准化清洗:剔除多余空白、统一标点与小写化"""
    if not raw_text:
        return ""
    # 1. 转换为小写
    text = raw_text.lower()
    # 2. 去除常见 HTML 标签
    text = re.sub(r"<[^>]+>", "", text)
    # 3. 过滤特殊标点与符号,仅保留中文字符、字母及数字
    text = re.sub(r"[^\w\u4e00-\u9fa5]", "", text)
    return text

def advanced_similarity_check(raw_a: str, raw_b: str, threshold: float = 0.70):
    clean_a = clean_text(raw_a)
    clean_b = clean_text(raw_b)

    if not clean_a or not clean_b:
        return {"ratio": 0.0, "is_duplicate": False, "clean_len_a": 0, "clean_len_b": 0}

    matcher = difflib.SequenceMatcher(None, clean_a, clean_b)
    ratio = matcher.ratio()

    return {
        "ratio": round(ratio, 4),
        "is_duplicate": ratio >= threshold,
        "clean_len_a": len(clean_a),
        "clean_len_b": len(clean_b)
    }

# 对比清洗前后的差异
text_raw1 = "1. 这是第一段:Python 的 difflib 很好用!\n2. 推荐大家尝试。"
text_raw2 = "这是第一段: python的difflib很好用! 推荐大家尝试。"

print("未清洗直接比对:", difflib.SequenceMatcher(None, text_raw1, text_raw2).ratio())
print("标准化清洗后比对:", advanced_similarity_check(text_raw1, text_raw2)["ratio"])
通过对文本进行正则归一化,排除了格式符带来的扰动,能够真实反映两段文字的核心重合度。
六、性能瓶颈与工业级查重演进建议
difflib.SequenceMatcher 属于纯 Python 实现的动态规划与递归查找算法。其时间复杂度最坏情况下为 O(N²)(平均情况下大约为 O(N) 到 O(N¹.&sup5))。
这意味着:
- 比对两篇 2000 字以内的短文章或作业时,计算仅需几毫秒,性能非常稳定。
- 一旦单篇文本超过 5 万字,或者需要与库内 10 万篇历史文章逐一比对(1 对 N),直接遍历调用
SequenceMatcher会导致计算耗时爆炸。
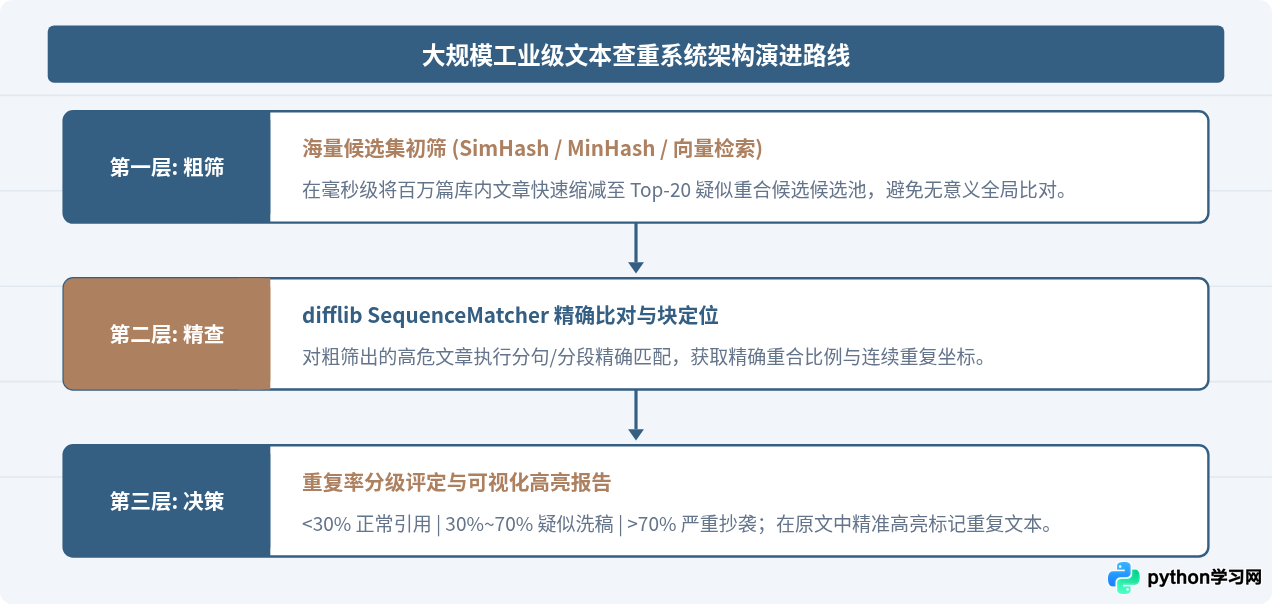
为了在大规模场景中兼顾效率与准确率,建议按以下策略进行工程落地:
- 分句/分段切片比对:长文章不建议整体传给
SequenceMatcher,而是先按句号或段落切分为句子列表,采用句子级别进行快速双重循环比对,能大幅度降低回溯开销。 - 粗筛 + 精查双层架构:面对海量文章库,先使用 SimHash 或 MinHash 算法计算文本指纹并建立倒排索引,秒级筛选出前 20 篇最相似的候选文章,再使用
difflib进行精确的重复块提取和比例核算。 - 合理设定重复块长度门槛:提取重复块时,建议将
min_length设置在 6 到 10 个字符以上,过滤“的”、“因此”、“总而言之”等常见通用过渡短语。
总结
Python 标准库的 difflib.SequenceMatcher 是实现基础文本查重最便捷、轻量的工具。通过掌握 ratio() 相似度计算、get_matching_blocks() 坐标抽取以及文本归一化预处理,开发者可以在几行代码内搭建起稳定实用的查重原型。当面对百万级大规模语料时,将 difflib 作为后置精查引擎结合指纹粗筛,即可构建出性能优异的工业级文本查重方案。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















