


有编程基础怎么快速上手Python语法?

对于已经掌握 C/C++、Java 或 JavaScript 等语言的开发者,学习 Python 不需要从“什么是变量、什么是条件判断”这种通用概念从零起步。最快捷的路径是直接将既有的编程心智模型与 Python 的底层对象引用机制对齐,重点攻克缩进作用域、常用数据容器的惯用写法(Pythonic idioms)以及动态类型带来的典型边界陷阱。
一、上手核心路径:从概念映射到写出可用代码
拥有编程基础的开发者学习一门新语言,最忌讳的是通读一本 800 页的基础语法手册。成熟开发者的优势在于已经具备算法逻辑、控制流和面向对象思想,学习 Python 的实质是一场“语法映射与习惯迁移”。
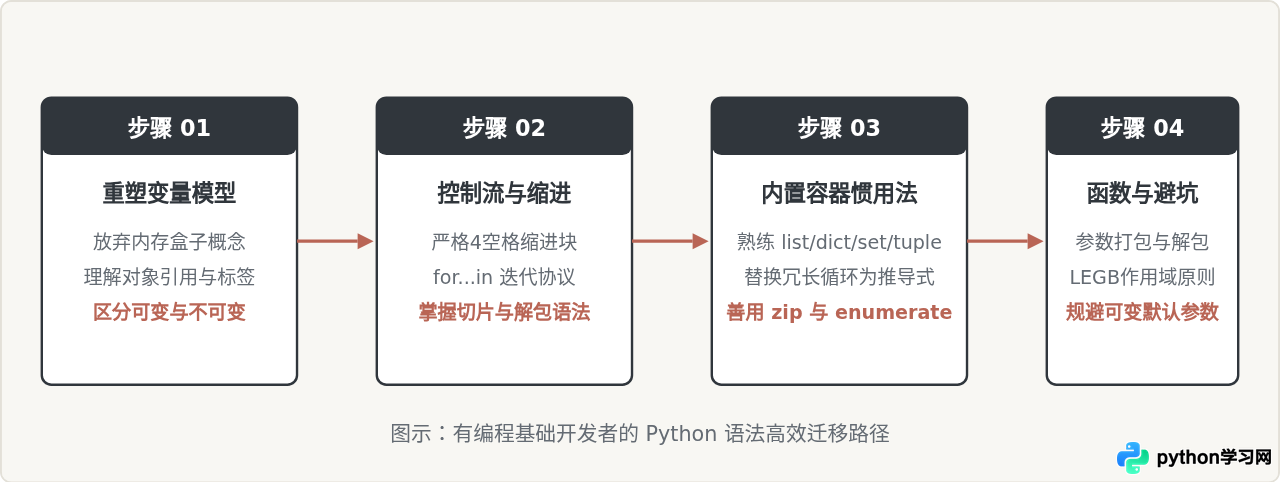
高效率的上手过程通常由四个连续步骤组成:先建立对 Python 变量与内存关系的正确认知,然后快速替换控制流与切片写法,紧接着熟悉四种内置核心数据结构的操作 API,最后掌握函数高级特性并识别避坑清单。
二、关键概念转变:Python 的“一切皆对象”与“名字绑定”
在 C/C++ 或 Java 中,声明一个变量 int a = 10; 是在内存中开辟一块能够容纳整型的存储单元(盒子),并将数值 10 存入该单元;执行 a = 20; 是将该内存单元中的值覆写。
而在 Python 中,变量只是贴在对象上的“标签”(引用),一切实体皆为对象。当你写下 a = 10 时,Python 首先在堆内存中创建整数对象 10,然后让名字 a 指向这个对象;再执行 a = 20 时,并不是把对象 10 改成了 20,而是创建了一个新的整数对象 20,并将标签 a 重新贴到 20 上。
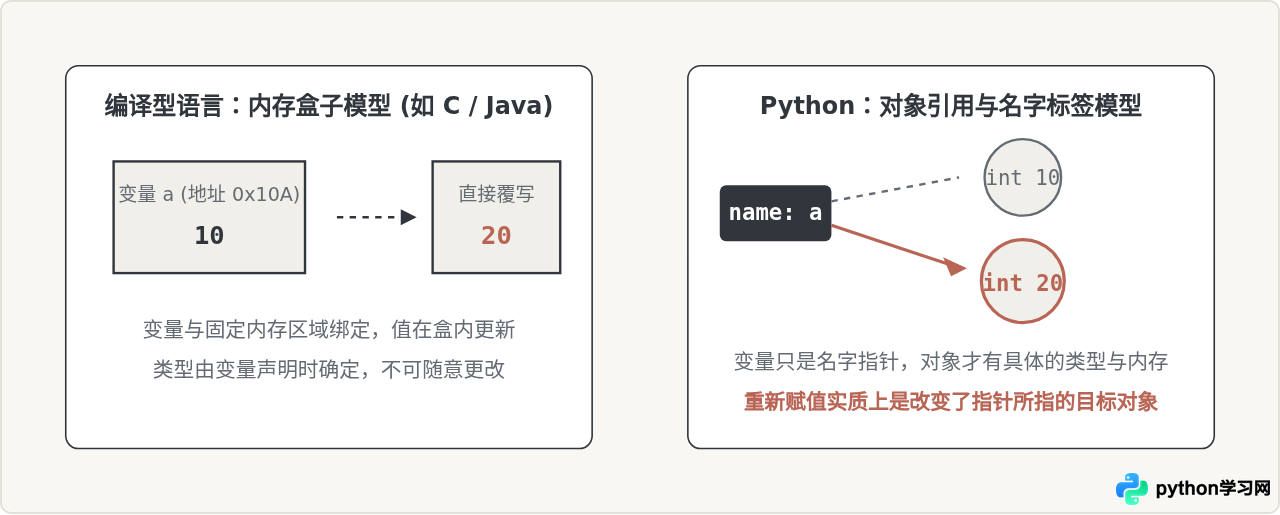
理解了这个模型,就能立刻想通 Python 中两个非常核心的分类:
- 不可变对象(Immutable):
int、float、str、tuple、bool。这类对象一旦创建,其内部状态不可修改。对它们的修改操作本质上都是生成一个全新对象。 - 可变对象(Mutable):
list、dict、set。多个变量名若指向同一个可变对象,通过其中一个引用就地(in-place)修改对象内容,其他引用访问到的内容同步改变。
# 可变对象的常见传参效应示例
def append_item(target_list, val):
    target_list.append(val)

data = [1, 2, 3]
append_item(data, 4)
# 输出: [1, 2, 3, 4] -> 原列表被直接修改,因为传递的是引用
print(data)
三、核心语法对照:快速转换旧习惯
有编程基础的开发者上手 Python 时,最容易写出“带着 Java/C 口音的 Python 代码”。通过以下几个最具代表性的语法对照,可以直接写出地道的 Python 表达。
| 场景 | C / Java / JavaScript 习惯写法 | Pythonic 习惯写法 |
|---|---|---|
| 遍历列表与索引 | for (int i = 0; i < len; i++) |
for i, item in enumerate(items): |
| 双列表并行遍历 | items1[i], items2[i] |
for x, y in zip(list1, list2): |
| 数值或变量互换 | 引入中间变量 temp = a; a = b; b = temp; |
a, b = b, a(元组自动打包与解包) |
| 字典安全取值 | if (map.containsKey(k)) { return map.get(k); } |
data.get(k, default_val) |
| 过滤并映射列表 | 循环并在外部 result.push(f(x)) |
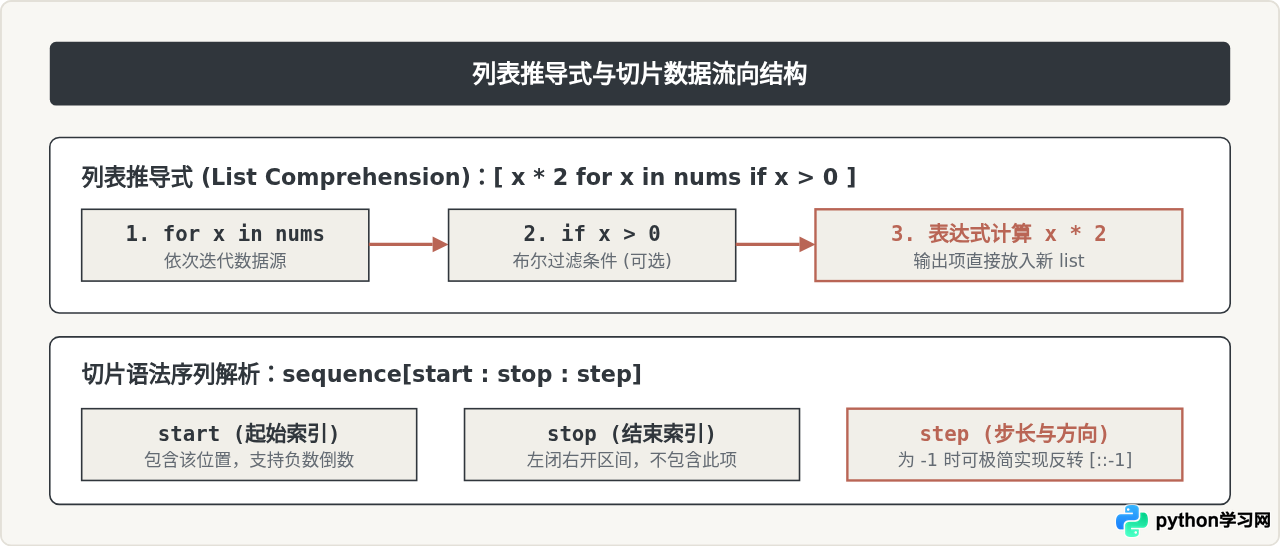
[f(x) for x in data if condition(x)] |
1. 作用域与缩进规则
Python 不使用大括号 {} 来界定代码块,而是使用严格统一的缩进(行业标准为 4 个空格,严禁混用 Tab 与空格)。在条件分支或函数声明行末尾必须包含冒号 :。
另外需要注意:在 Python 中,if、for、while 等控制语句不会产生新的局部作用域。在循环体内创建的变量,在循环结束后依然可以在外层直接访问。只有模块(Module)、类(Class)和函数(Function)会开辟新的命名空间。
2. 函数参数机制:解包与关键字参数
Python 支持位置参数、关键字参数、默认参数以及不定长传参:
def connect_database(host, port=3306, *args, timeout=10, **kwargs):
    # *args 收集多余的位置参数,形成 tuple
    # **kwargs 收集多余的键值对参数,形成 dict
    print(f"Connecting to {host}:{port}, timeout={timeout}")

# 传参调用方式非常灵活
connect_database("127.0.0.1", port=5432, timeout=30, user="admin", env="prod")
四、有经验开发者最易触发的 4 个思维陷阱
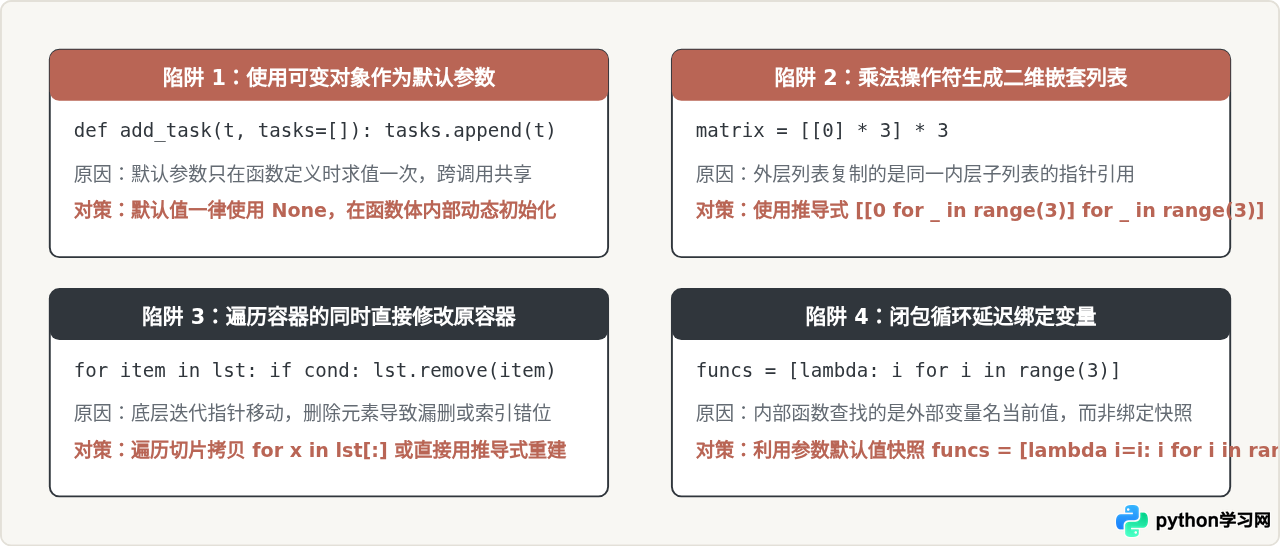
来自静态强类型或严格基于类语法语言的开发者,在初期经常会因为惯性思维写出潜伏隐患的代码。以下 4 个场景是排查频次最高的易错点:
1. 默认参数陷阱的具体排查
在 Python 中,def 是一个可执行语句。当模块被加载执行到函数定义时,默认参数表达式就会被计算并创建对象。如果默认参数是列表或字典,后续所有未显式传参的调用都会复用同一个对象:
# 错误示例:跨请求累加污染
def append_log(msg, log_list=[]):
    log_list.append(msg)
    return log_list

# 正确规范:以 None 作为哨兵值
def append_log_safe(msg, log_list=None):
    if log_list is None:
        log_list = []
    log_list.append(msg)
    return log_list
2. 变量作用域查找机制(LEGB 规则)
当在函数内部读取或写入一个变量名时,Python 按照以下优先级自底向上寻找:
- L(Local):当前函数的局部作用域。
- E(Enclosing):闭包外部嵌套函数的作用域。
- G(Global):当前模块文件的全局作用域。
- B(Built-in):Python 内置模块(如
len、range)。
在函数内部如果直接对未声明的变量进行赋值(例如 count += 1),Python 会默认将其视作对局部变量的操作;如果局部变量尚未初始化,则会抛出 UnboundLocalError。若需修改全局或外层变量,必须使用 global count 或 nonlocal count 显式指定。
五、上手实操建议:从脚本重构开始
学习语法的最终目的是快速写出健壮代码。建议按照如下方式在半天内完成上手:
- 拿一个既有语言写过的小脚本做重写:例如一个解析本地 JSON/CSV 文件并进行数据聚合的小工具。通过真实需求对比文件读写(
with open(...) as f:上下文管理器)以及内置数据结构的效率。 - 优先使用标准库:Python 的标准库极其丰富,诸如
pathlib(路径操作)、collections.defaultdict、itertools、json、dataclasses等,绝大多数常见功能无需引入第三方包即可优雅完成。 - 使用类型注解(Type Hints):对于习惯了静态类型检查的开发者,可在 Python 3.9+ 中积极使用
def process(data: list[str]) -> dict[str, int]:,配合 IDE 的静态分析,既能维持动态语言的敏捷,又能避免类型传递错误。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















