


Python元组和列表有什么区别?适用场景对比

在编写 Python 程序时,我们经常需要组织一组关联数据。假设你正在开发一个配送系统,需要记录配送员当前的经纬度坐标,以及他今天待配送的订单包裹编号。如果把经纬度存成 [121.47, 31.23],后续代码可能在无意中调用 append() 或修改数值,导致关键坐标被破坏;而如果把待配送订单存成不可修改的元组,程序又无法在完成配送或新增派单时动态增删。这一具体问题引出了 Python 中两个最基础却最核心的序列类型:列表(List)与元组(Tuple)。本文将从底层机制、运行表现到应用场景全面拆解两者的本质区别,帮助你在工程中准确选型。
一、核心机制对比:可变性与内部内存设计
列表与元组最根本的区别在于可变性(Mutability)。列表是动态可变容器,创建后支持原地增删改查;元组则是不可变容器,一旦创建,其内部引用的元素集合及顺序便永久固定。
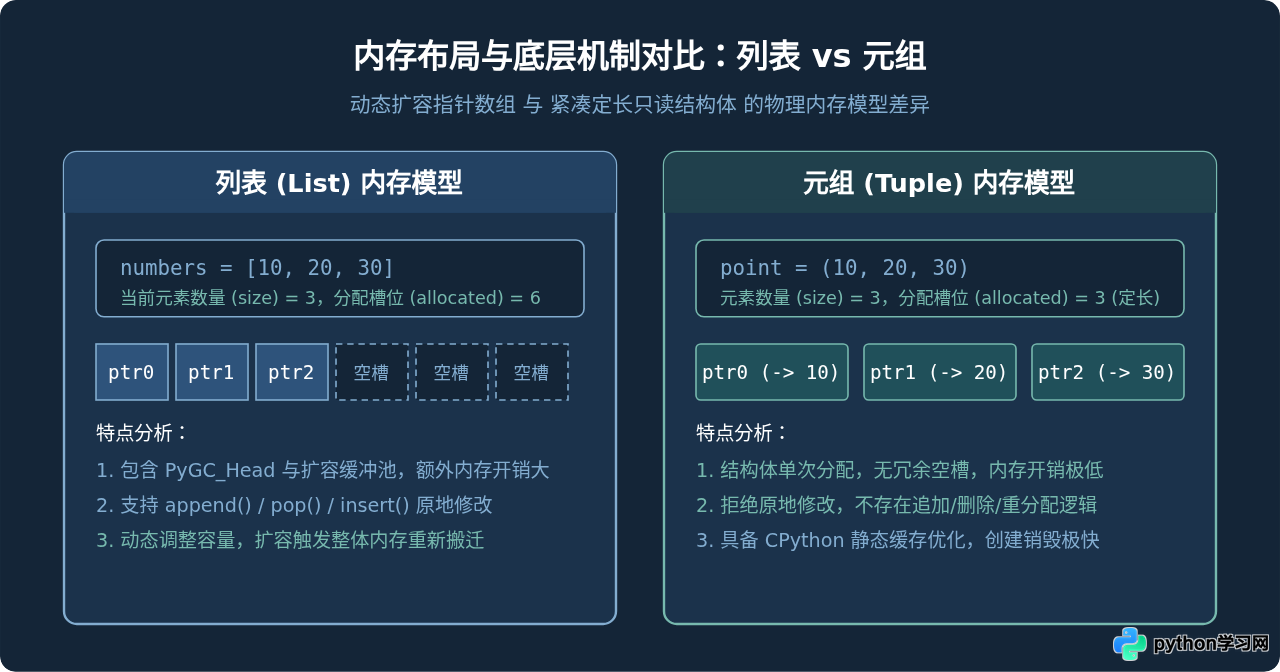
表面上看只是语法上方括号 [] 与圆括号 () 的差异,但底层实现机制完全不同:
- 列表(List):基于动态数组(Dynamic Array)实现。为了保证
append()操作均摊为 O(1) 复杂度,Python 采用了“过量分配(Over-allocation)”机制,分配的内存容量往往大于实际存储的元素个数,并且需要维护一个可变长度指针表。 - 元组(Tuple):基于定长连续数组实现。因为不可变,Python 在初始化元组时只分配恰好容纳指定元素的紧凑内存块,无需维护扩容冗余空间,结构精简稳定。
在 Python 代码中,可变性的差异表现得极为直接:
# 1. 列表的原地修改能力
fruits = ["apple", "banana"]
fruits.append("orange")      # 正常追加
fruits[0] = "pear"           # 正常修改索引元素
print(fruits)                # 输出: ['pear', 'banana', 'orange']

# 2. 元组的不可变保护
coordinates = (121.47, 31.23)
# coordinates[0] = 120.0     # 抛出 TypeError: 'tuple' object does not support item assignment
# coordinates.append(10.5)   # 抛出 AttributeError: 'tuple' object has no attribute 'append'
二、运行效率与资源消耗实测对比
不可变的设计赋予了元组在内存和速度上的显著优势。我们通过两个具体的维度来验证:
1. 内存占用差异
通过内置模块 sys.getsizeof() 观察相同元素下列表与元组的实际字节大小:
import sys

empty_list = []
empty_tuple = ()
print("空列表内存:", sys.getsizeof(empty_list))    # 常见输出: 56 字节 (包含动态管理头)
print("空元组内存:", sys.getsizeof(empty_tuple))   # 常见输出: 40 字节

data_list = [1, 2, 3, 4, 5]
data_tuple = (1, 2, 3, 4, 5)
print("5元素列表:", sys.getsizeof(data_list))     # 常见输出: 104 字节 (预分配缓冲)
print("5元素元组:", sys.getsizeof(data_tuple))    # 常见输出: 80 字节 (严格契合)
在千万级高并发或大规模数据处理场景中,如果存储数百万条固定数据结构,选择元组相比列表能直接节省 20% 到 30% 以上的物理内存。
2. 创建与回收性能
CPython 解释器对小型元组(元素数量小于 20)做了一项特殊的垃圾回收优化:销毁元组时,其底层占用的结构内存不会立即释放给操作系统,而是保留在全局空闲链表中(Free List)。当下一次再创建相同大小的元组时,直接复用该内存块,无需向操作系统申请内存。因此,在频繁创建小对象的循环中,元组的速度通常是列表的 2 到 5 倍。
三、核心机制二:可哈希性与字典键/集合支持
在 Python 中,字典的键(Key)和集合的元素(Set element)必须是可哈希(Hashable)的对象。可哈希意味着对象必须实现 __hash__() 方法,且其生命周期内哈希值保持恒定,同时可以与其他对象比较(实现 __eq__())。
- 列表不可哈希:因为列表元素可以被修改,如果列表作为字典键,一旦修改其内容,计算出的哈希值就会改变,字典将无法在原哈希桶中定位数据,从而破坏哈希表的完整性。因此 Python 明确禁止列表作为字典键或放入集合中。
- 元组通常可哈希:只要元组内部包含的所有元素也都是不可变对象,元组就可以直接计算哈希值,从而安全地作为字典键或集合元素。
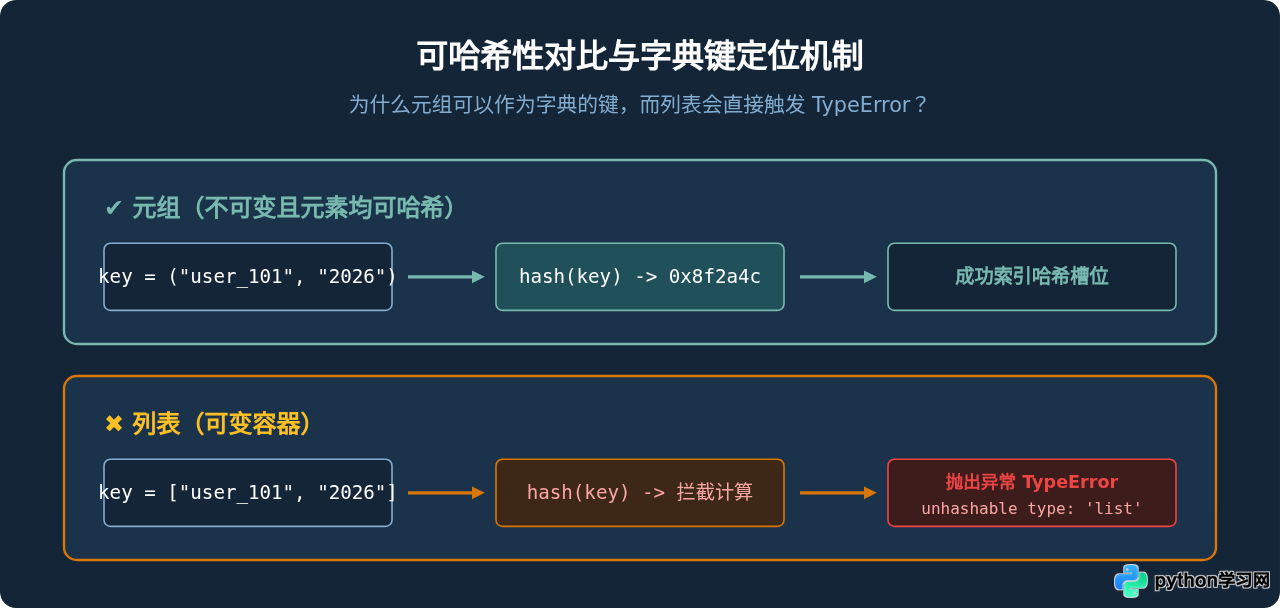
注意元组的“浅层不可变”陷阱:元组的不可变性仅指其持有的对象引用不变。如果元组内嵌套了可变对象(例如 t = (1, [2, 3])),则该元组不可哈希,调用 hash(t) 依然会报错;并且列表内的元素仍能被原地修改(如 t[1].append(4))。因此,若要作为可靠的字典键,元组内各级元素都必须是不可变对象。
四、工程选型指南:什么时候用列表?什么时候用元组?
在实际工程代码编写中,很多开发者倾向于默认使用列表,但从软件工程角度来看,数据结构的选择承载着代码意图传达(Communicating Intent)与数据安全性保障。
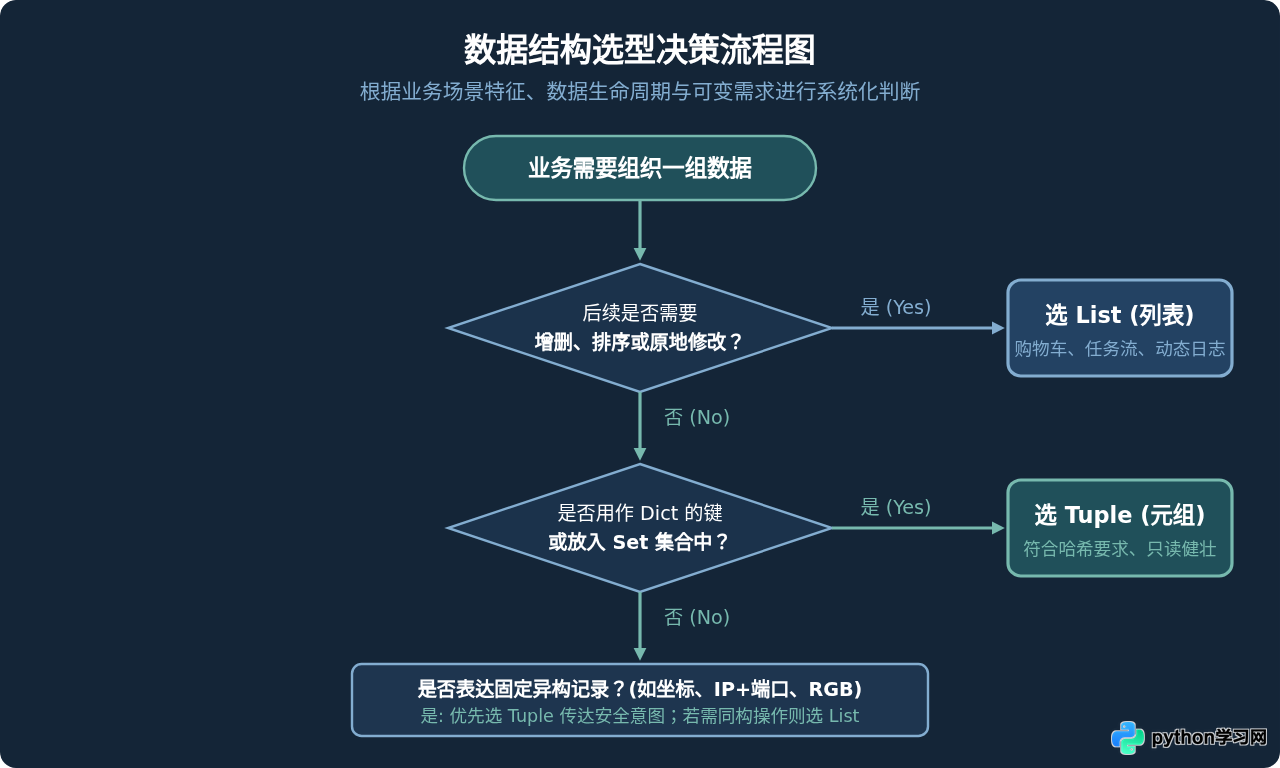
1. 必须或强烈建议使用【元组】的场景
- 作为字典复合键或集合元素:例如记录用户在特定年份的统计指标:
user_stats = {("user_01", 2026): 9800}。列表在语法上直接报错。 - 函数返回多个值:Python 函数执行
return a, b时,实际返回的就是一个元组。这种场景通常表示一个紧密关联的固定结果集合。 - 表达不可变记录(Records/Structs):例如地理坐标
(latitude, longitude)、RGB 颜色值(255, 128, 0)、数据库配置端口("127.0.0.1", 8080)。使用元组向维护者明确传递“此数据不可被随意追加或修改”的信号,防范意外改写。 - 多进程/多线程传递常量数据:元组天然只读,在跨函数传递或多线程共享时不存在并发写冲突,具有极高的线程安全性。
2. 必须或强烈建议使用【列表】的场景
- 长度可变、动态收集的集合:如用户的购物车商品列表、实时接收的传感器数据流、轮询任务队列。
- 需要就地排序、反转或重排:列表内置了高效的
sort()和reverse()方法,无需创建新对象即可原地重排海量数据;而元组若要排序,必须通过sorted(t)产生全新对象。 - 同构数据的大规模遍历处理:例如一批员工对象、一组日志行,各元素类型一致且随时可能经历过滤、删除、切片插入等操作。
五、常见踩坑与进阶实践
1. 单元素元组的逗号陷阱
在 Python 中,决定元组语义的核心符号是逗号(Comma),而不是括号。圆括号在语法中同时兼任运算优先级的职责:
# 错误写法:并未创建元组,括号被视作算术分组
a = ("apple")
print(type(a))  # 输出: <class 'str'>

# 正确写法:必须保留末尾逗号
b = ("apple",)
print(type(b))  # 输出: <class 'tuple'>
2. 想要可读性更高的记录?使用 Namedtuple
如果用普通元组存储数据,通常依靠索引访问(如 coord[0]),可读性较差。如果使用字典,又需要额外的哈希管理内存。标准库中的 collections.namedtuple 结合了两者的优点:
from collections import namedtuple

# 定义具有字段名的轻量元组结构
Point = namedtuple("Point", ["x", "y", "z"])
p = Point(x=10, y=20, z=30)

print(p.x)       # 输出: 10,支持属性名访问
print(p[0])      # 输出: 10,兼具元组索引解构与不可变性
# p.x = 100     # 抛出 AttributeError: can't set attribute (维持元组安全保护)
六、全维度对比总结
理解列表与元组的差异,本质上是理解软件工程中可变性(Flexibility)与不可变性(Safety & Efficiency)之间的权衡。列表提供了灵活的动态操作能力,适合管理演进中的数据流;元组提供了坚固的数据约束与高效的内存表现,适合固定结构的持久表达。
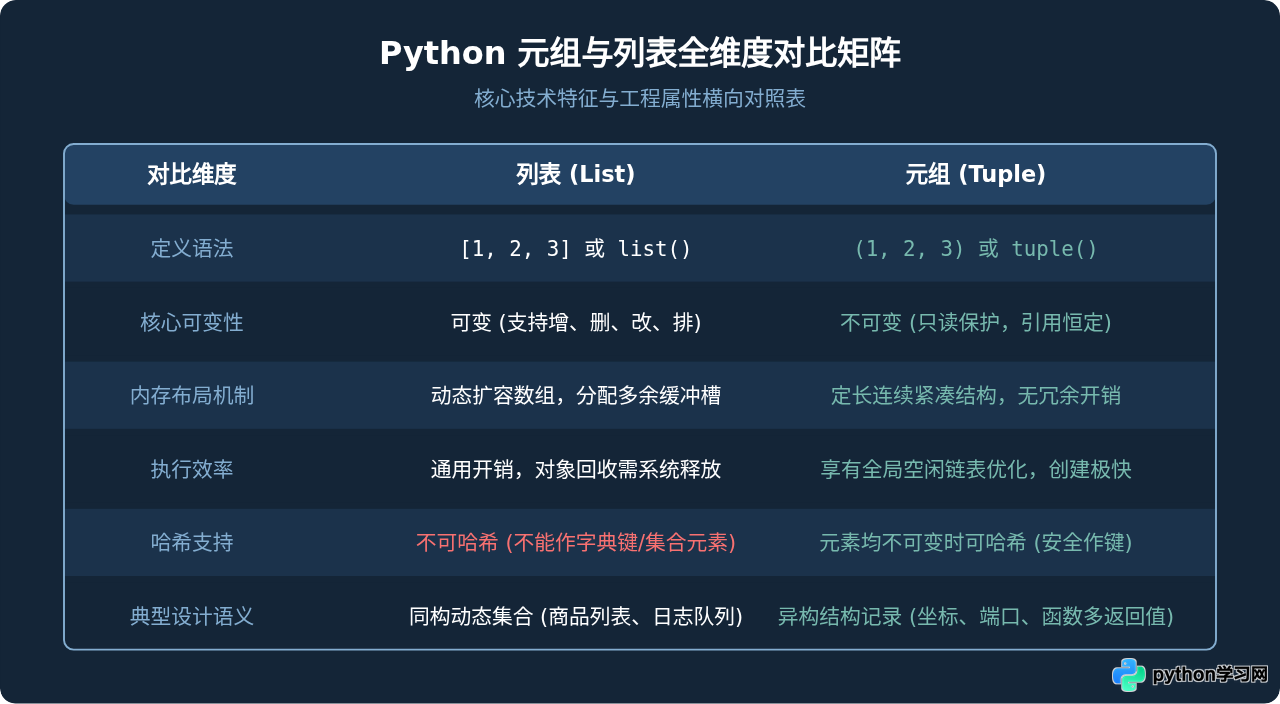
实战选型总结口诀:需要经常增删改,动态排序选列表;定长只读保安全,字典键值用元组;轻量记录求语义,命名元组更清晰。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















