


Python函数定义规范:文档字符串与类型提示编写

在现代 Python 开发中,编写高质量函数的标准已由单纯的“逻辑运行正确”转变为“具备高可维护性与契约清晰度”。没有规范约束的裸函数往往导致调用方陷入“参数类型靠猜、异常抛出不明、返回结构未知”的困境。构建工业级标准 Python 函数的核心支柱包含两项技术:一是利用类型提示(Type Hints)建立机器可解析、编辑器可联想的静态契约;二是利用文档字符串(Docstrings)向开发者陈述函数的业务目的、参数边界与设计权衡。本文将系统梳理类型提示与文档字符串的标准编写范式,通过具体步骤与避坑案例,帮助团队统一函数定义风格。
一、现代 Python 类型提示体系与签名规范
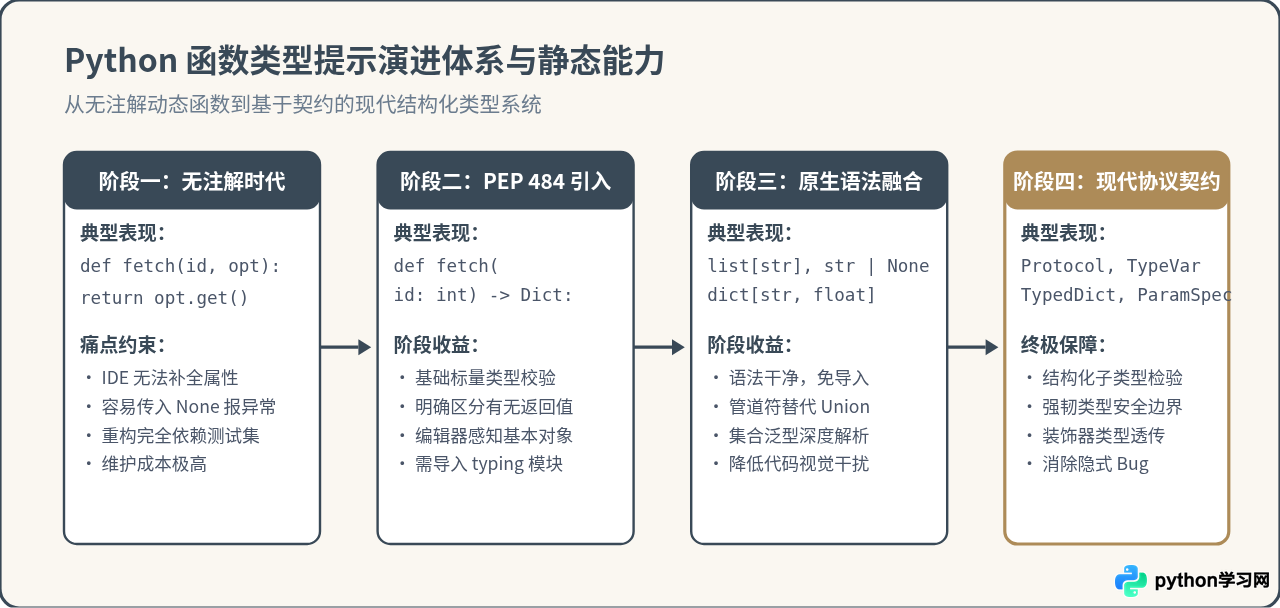
自 Python 3.5 引入 PEP 484 以来,类型系统经历了长足演进。在 Python 3.9+ 环境中,内置容器类型已全面支持泛型下标,无需再繁琐导入 typing.List 或 typing.Dict。从 Python 3.10 开始,联合类型可以使用更为简洁的管道符 | 代替 Union。在定义函数签名时,应遵循现代、精炼的语法规则。
一个标准的现代函数签名应明确指定每个形参的类型及返回值的类型。即便函数没有返回值,也必须显式标注 -> None,以便类型检查器明确区分“尚未编写返回值”与“预期无返回”。
# 现代标准函数签名示例(Python 3.10+)
def calculate_metrics(
    raw_scores: list[float],
    threshold: float,
    weight_map: dict[str, float] | None = None,
    allow_empty: bool = False,
) -> dict[str, float]:
    ...
对于复杂场景,标准库 typing 提供了高阶语义工具:
- 序列与映射抽象:当函数仅需要遍历列表或读取映射时,优先使用
Sequence[T]或Mapping[K, V]而非具体的list或dict,以提高函数的复用度。 - 可调用对象:对于回调函数,使用
Callable[[Arg1Type, Arg2Type], ReturnType]明确参数与返回值约束。 - 字面量与枚举约束:使用
Literal["asc", "desc"]限制参数仅能接收特定几个固定值。 - 结构化字典:对于返回非统一键值对的字典,使用
TypedDict声明键名及其对应的值类型。
二、主流文档字符串(Docstring)规范与 Google 风格详解
PEP 257 确立了文档字符串的基本语法要求:使用三双引号 """ 包裹;第一行必须是一句简明扼要的摘要(以句号结尾);摘要与后续正文之间必须空出完整一行;多行 Docstring 的闭合引号独占一行。然而,PEP 257 未细化参数列表、返回值与异常的排版结构。
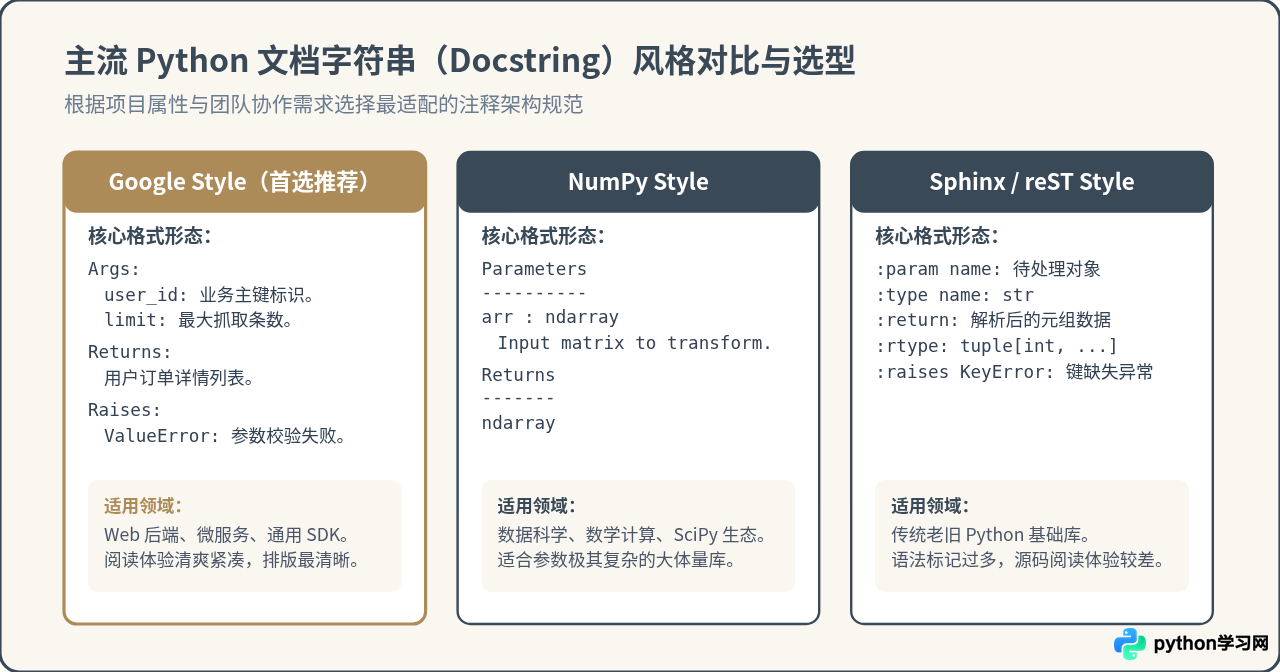
社区在长期演进中衍生出三种主流风格:Google 风格、NumPy 风格与Sphinx (reStructuredText) 风格。在绝大多数通用软件开发与微服务架构中,Google 风格凭借极高的垂直可读性、紧凑的段落排版和对自动化文档工具(如 MkDocs、Sphinx Napoleon)的优异支持,成为当下最推荐的团队规范。
Google Style 的核心区块结构规则
在 Google 风格中,Docstring 必须包含以下几大标准区块(按需选用):
- 单行摘要(Summary line):以第三人称或祈使句开头,阐明函数的主要功能,以句号收尾。
- 详细描述(Extended Description):若单行摘要不足以说明背景,可在此展开业务逻辑、算法复杂度或副作用说明。
- Args(参数列表):每个形参缩进 4 格,声明格式为
arg_name: 说明文字。注意:由于现代 Python 函数签名中已包含完整的类型提示,Docstring 中无须重复书写冗余类型(如arg_name (int): ...),以严格遵守 DRY(Don't Repeat Yourself)原则,避免重构时产生分歧。 - Returns / Yields:说明返回值的业务含义、内部结构或生成器产出值的逻辑。
- Raises:列出函数内部主动校验并显式抛出的异常类型,及其触发的具体条件。
- Examples:给出可运行的代码示例,通常采用交互式提示符
>>>编写,不仅能帮助读者快速理解用法,还能被doctest模块当作测试用例直接执行。
三、标准化编写步骤与生产级示例
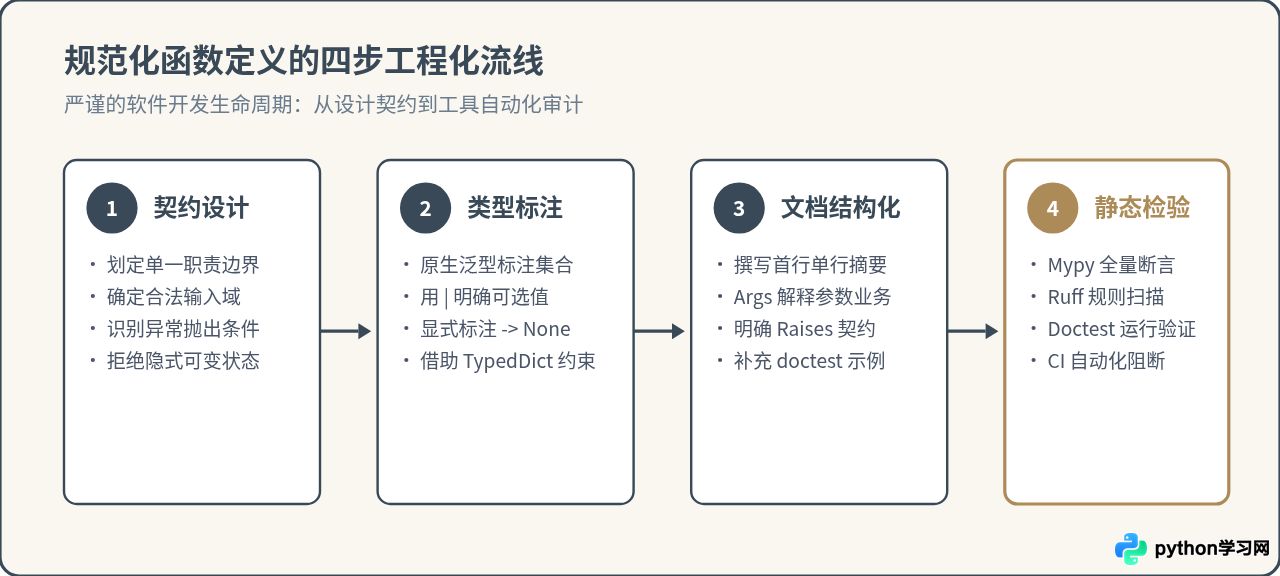
实现工业级规范的函数定义,通常按照四步闭环流程进行构建:设计接口契约、标注精准类型、编写业务文档、执行自动化静态验证。
生产级示范:数据批处理过滤函数
以下为一个严格遵循上述规范的生产级函数实现,演示了类型提示、TypedDict 结构化返回与 Google Docstring 的结合:
from collections.abc import Sequence
from typing import TypedDict


class FilterResult(TypedDict):
    """过滤操作的结果汇总。"""
    passed: list[dict[str, float]]
    rejected_count: int
    mean_score: float


def filter_and_aggregate_records(
    records: Sequence[dict[str, float]],
    score_field: str,
    min_threshold: float,
    max_records: int | None = None,
) -> FilterResult:
    """依据分数字段过滤记录序列并计算通过样本的均值。

    对输入的记录序列执行条件筛选。若记录中缺少指定的分数字段,
    或其分数低于阈值,则被判定为未通过。计算通过记录的平均得分,
    并受最大返回条数约束。

    Args:
        records: 包含数值属性的字典序列。
        score_field: 用作评估基准的键名。
        min_threshold: 允许通过的最低分数阈值(包含边界)。
        max_records: 最多返回的记录条数。若为 None,则不设上限。

    Returns:
        包含以下字段的 FilterResult 字典:
            passed: 通过筛选的记录列表。
            rejected_count: 未达阈值或字段缺失被淘汰的记录数量。
            mean_score: 通过记录的平均分值;若无通过记录则为 0.0。

    Raises:
        ValueError: 当 min_threshold 为负数,或 max_records 小于等于 0 时抛出。
        TypeError: 当 score_field 不为非空字符串时抛出。

    Examples:
        >>> data = [{"score": 85.0}, {"score": 60.0}, {"score": 92.5}]
        >>> res = filter_and_aggregate_records(data, "score", 80.0)
        >>> len(res["passed"])
        2
        >>> res["rejected_count"]
        1
        >>> res["mean_score"]
        88.75
    """
    if not isinstance(score_field, str) or not score_field.strip():
        raise TypeError("score_field 必须为非空字符串。")
    if min_threshold < 0:
        raise ValueError(f"min_threshold 必须为非负数,当前值为: {min_threshold}")
    if max_records is not None and max_records <= 0:
        raise ValueError(f"max_records 必须大于 0,当前值为: {max_records}")

    passed: list[dict[str, float]] = []
    rejected_count = 0
    total_score = 0.0

    for item in records:
        val = item.get(score_field)
        if val is not None and val >= min_threshold:
            if max_records is None or len(passed) < max_records:
                passed.append(item)
                total_score += val
        else:
            rejected_count += 1

    mean_score = (total_score / len(passed)) if passed else 0.0

    return {
        "passed": passed,
        "rejected_count": rejected_count,
        "mean_score": round(mean_score, 4),
    }
四、常见反模式与避坑指南
在日常代码审查中,以下四种反模式最为高发,严重削弱了类型提示与文档字符串的价值:
1. 可变对象作为默认参数
在 Python 中,函数默认参数在模块加载定义时求值且仅创建一次。若将可变对象(如 list、dict)直接作为默认值,后续调用中的修改将在不同调用间产生意外共享和脏数据。
# 错误反模式:列表默认值将在函数调用间累积
def append_tag(tag: str, tags: list[str] = []) -> list[str]:
    tags.append(tag)
    return tags

# 正确标准范式:使用 None 作为哨兵值并在文档中说明
def append_tag(tag: str, tags: list[str] | None = None) -> list[str]:
    """向标签列表中追加新标签。

    Args:
        tag: 待追加的新标签名称。
        tags: 既有标签列表。若为 None,将在函数内部自动初始化为空列表。
    """
    if tags is None:
        tags = []
    tags.append(tag)
    return tags
2. 滥用 Any 导致类型系统形同虚设
当开发者面对复杂对象或多态输入时,若贪图省事直接标注 param: Any,将直接击穿静态类型安全防线。对于仅需支持某些操作的对象,应优先考虑 Protocol(鸭子类型静态化);对于多种确定类型的集合,应使用 int | str 联合类型;对于输入与输出类型绑定的场景,应使用 TypeVar 泛型。
3. 文档中冗余重复声明类型
在函数签名已显式标注 user_id: int 的情况下,Docstring 中继续书写 user_id (int): ... 不仅是无用功,而且极易在后续重构代码(例如将 int 升级为 UUID 或 str)时遗漏修改,导致文档与代码真实签名相互矛盾。文档字符串应当专注于阐述业务意图、边界范围与单位约束(例如:超时时间的单位是秒还是毫秒,数值是否包含上下界)。
4. 忽略循环导入与延迟类型评估
当模块 A 与模块 B 的函数签名需要互引对方定义的类作为类型注解时,直接导入会导致 ImportError。解决方案是在文件顶部声明 from __future__ import annotations,并在 if TYPE_CHECKING: 保护块中导入目标类,避免运行时循环加载。
from __future__ import annotations
from typing import TYPE_CHECKING

if TYPE_CHECKING:
    from app.services.order_service import OrderManager

def process_checkout(order_id: str, manager: OrderManager) -> bool:
    ...
五、核心规范全景速查与总结
为便于在工程实践中快速对照执行,下表列出了函数定义质量维度的检查矩阵:
| 检查维度 | 合规标准(DO) | 违规反模式(DON'T) |
|---|---|---|
| 返回值标注 | 无返回函数显式标注 -> None |
省略返回类型或放任推断为 Any |
| 容器泛型 | 使用 list[str], dict[str, int] |
裸用 list, dict 或继续引入 typing.List |
| 默认参数 | 使用不可变对象或 None 作为默认哨兵值 |
使用 [], {} 等可变对象作为默认值 |
| 文档排版 | 首行独立摘要句尾加标点,参数仅写业务说明 | 无摘要直接写正文,Docstring 堆砌冗余类型 |
| 异常契约 | 明确在 Raises: 列出主动抛出的错误类型 |
抛出未记录的隐藏异常或裸抛 Exception |
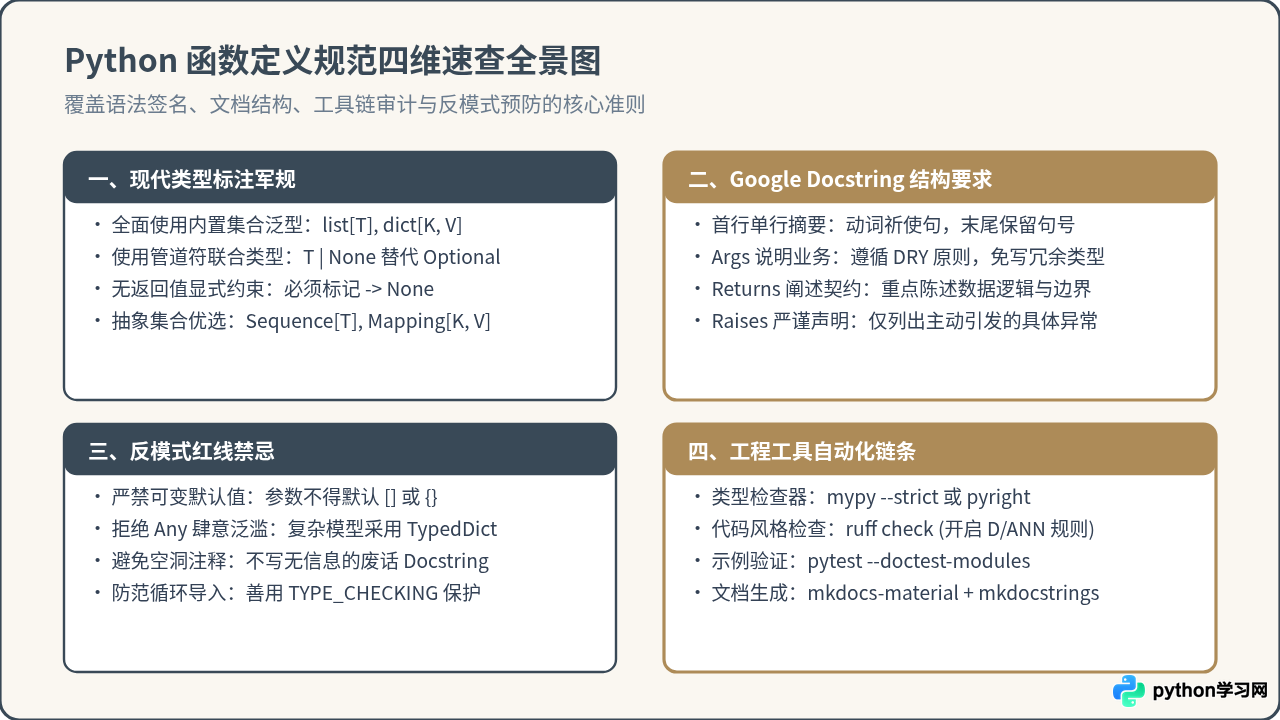
规范的建立重在自动化工具的约束。建议团队在 CI 管道中集成 ruff(开启 D 系列文档规则与 ANN 系列注解规则)和 mypy。通过将人工审查标准固化为机器规则,能够在代码提交阶段自动拦截缺失类型提示或 Docstring 不合规的函数,保障整个代码库的长期健康演进。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















