


新手学Python爬虫需要装什么软件?IDE环境与基础库推荐

新手刚接触Python爬虫时,面对网上各类教程提及的各种工具、框架和扩展,往往容易陷入软件选择焦虑。实际上,学习网络爬虫所需的基础工具链非常轻量、精炼:核心只需一个稳定的Python官方运行环境、一款顺手的代码编辑工具(推荐VS Code或PyCharm社区版),再加上2至3个专注于网络请求与网页解析的基础类库即可完成绝大多数常规抓取任务。本文将按实际开发逻辑,逐一拆解基础运行环境的安装要点、主流IDE的实际选型依据以及必装的核心库组合。
一、基础底座:Python官方运行环境的安装与配置
所有Python爬虫程序都依赖Python解释器运行。对于新手而言,直接从Python官方网站(python.org)下载稳定的长期支持版本即可(建议选择Python 3.10至3.12之间的版本)。在安装环节中,有一个最关键但极易被忽略的步骤:安装向导首页底部的“Add python.exe to PATH”(将Python添加到系统环境变量)。务必手动勾选该选项,否则在命令行终端中输入python命令时会出现“无法识别命令”的报错。
安装完成后,建议通过系统自带的终端(Windows的CMD/PowerShell或macOS的Terminal)执行以下命令,验证环境是否正确生效:
# 检查Python解释器版本
python --version
# 输出示例:Python 3.11.8

# 检查包管理工具pip版本
pip --version
# 输出示例:pip 24.0 from ... (python 3.11)
验证无误后,为了保证后续下载第三方库顺畅,建议将pip包管理工具的下载源配置为国内镜像源(如清华大学镜像源或阿里云镜像源),避免因网络延迟导致安装第三方库频繁超时中断:
# 一键配置pip全局国内镜像源
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple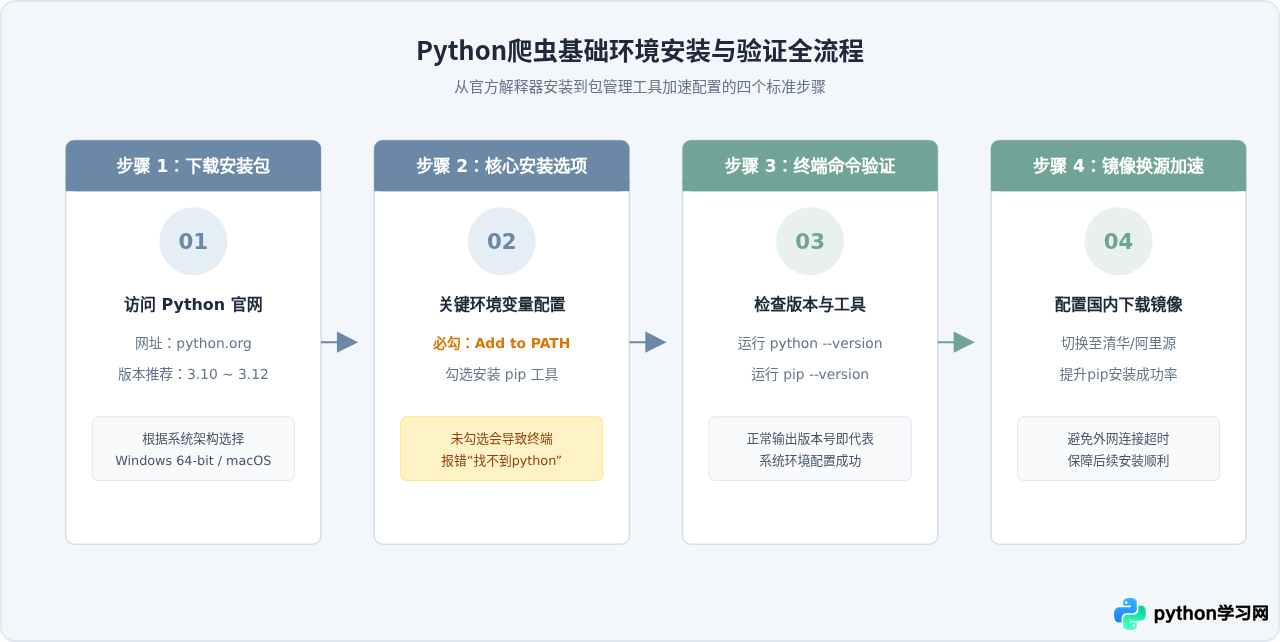
二、写代码的利器:主流IDE与编辑器选型推荐
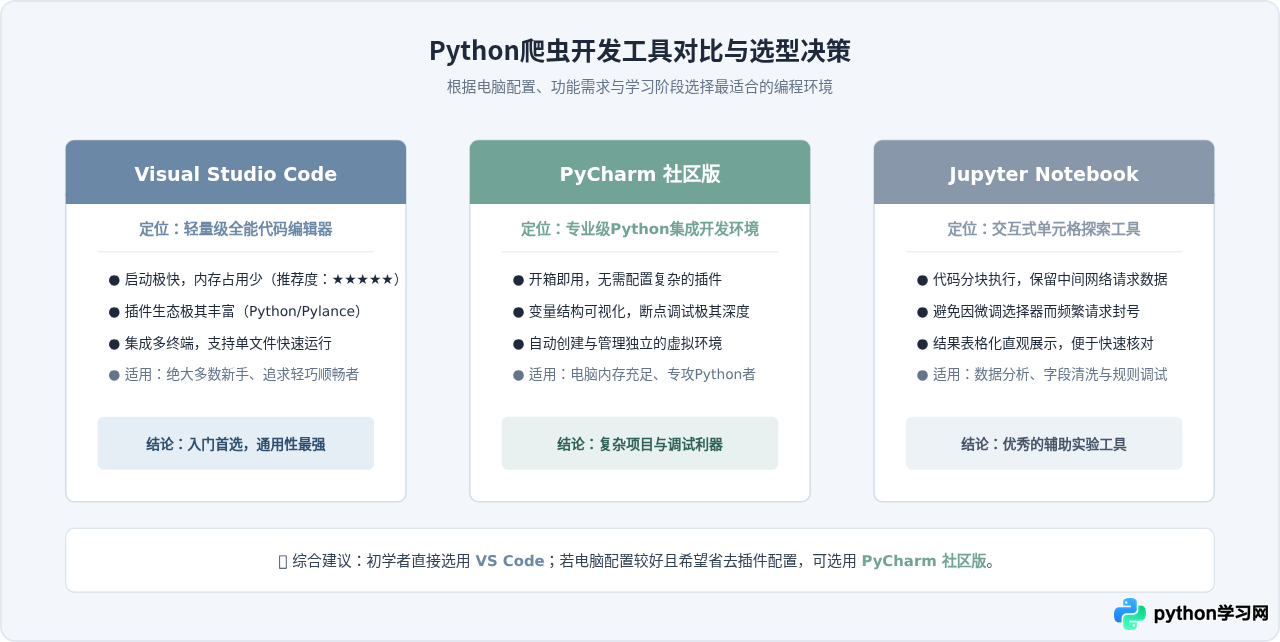
有了Python解释器之后,你需要一个编写与调试代码的软件。新手切忌使用系统记事本写代码,因为记事本不具备语法高亮、自动补全、缩进对齐和断点调试功能。目前适合爬虫学习的编辑器主要分为两类:集成开发环境(IDE)与现代代码编辑器。
1. Visual Studio Code(首选推荐)
VS Code由微软推出,是一款免费、开源且轻量级的代码编辑器。它的核心优势在于资源占用低、启动速度极快,并且拥有极其强大的插件生态。对于爬虫新手而言,安装VS Code后只需在拓展商店搜索并安装两个插件:
- Python(Microsoft官方出品):提供语法检查、代码格式化、自动补全以及运行调试支持。
- Pylance:提供高性能的类型推断与代码跳转功能。
VS Code自带集成终端,可以在上方窗口编写爬虫脚本,在下方终端实时执行与观察打印结果,学习体验非常连贯。
2. PyCharm Community Edition(专业开箱即用)
PyCharm是由JetBrains开发的专业Python IDE。新手建议下载免费的Community(社区版),不需要付费购买专业版。PyCharm的优势在于“开箱即用”:它内部集成了强大的虚拟环境管理功能、代码重构功能以及直观的可视化调试面板。在爬虫代码出现解析逻辑错误时,PyCharm的变量监视窗口能够清晰展示深层嵌套的字典或列表结构。其缺点是软件体积较大,启动时索引建立需要占用较多内存。
3. Jupyter Notebook(适合分段探索与调试)
Jupyter Notebook以网页形式提供交互式单元格运行环境。在爬虫开发过程中,新手往往需要频繁测试网页元素的选择器(如XPath或CSS选择器是否写对)。如果每次修改选择器都重新发起一次完整的网络请求,不仅容易触发目标网站的访问频率限制,也非常耗费时间。在Jupyter中,你可以将“请求网页”放在第一个代码块,“解析字段”放在第二个代码块,多次执行解析而不必重复联网请求,非常适合做数据抓取前的分析与探索。
三、核心基础库推荐:爬虫运作的三大环节与必备工具
一个标准的Python爬虫工作流程分为清晰的三个阶段:发送网络请求获取网页、解析HTML文本提取字段以及将清洗好的数据保存到本地。新手切忌一上来就学习庞大复杂的Scrapy框架或分布式爬虫,掌握最基础的单任务库才能深刻理解网络通信与DOM解析的本质。
1. 网络请求库:Requests 与 httpx
在Python中,虽然标准库自带urllib,但其语法相对繁琐且需要手动处理复杂的Cookie、会话与编码。新手最应当掌握的是第三方库Requests。
- Requests:被誉为“给人类使用的HTTP库”,API简洁直观,使用
requests.get(url)即可获取网页内容,支持自动处理会话(Session)、定制请求头(Headers)、携带Cookies及超时重试。 - httpx(进阶可选):现代化的HTTP客户端,既兼容Requests的同步API,又原生支持异步并发(async/await)以及HTTP/2协议,是未来进阶高并发抓取的重要选项。
2. 内容解析库:BeautifulSoup4 与 lxml
获取到HTML源码后,需要从中提取出目标文本或图片链接。处理解析任务有两个核心工具:
- BeautifulSoup4(简称 bs4):语法对初学者极其友好,支持通过标签名、CSS类名(如
find_all('div', class_='title'))快速定位元素,容错性高,即使网页标签有瑕疵也能自动修复解析。 - lxml:一个基于C语言底层的超高性能解析引擎。它可以作为BeautifulSoup的底层解析器(
BeautifulSoup(html, 'lxml')),同时也原生支持标准XPath语法,提取速度远快于Python原生解析器。
3. 数据存储库:内置模块与 Pandas
抓取到的数据通常需要持久化保存:
- 内置模块(json / csv):Python自带模块,无需单独安装。通过
import json或import csv就能轻松把爬取的数据导出为结构化JSON文本或Excel可直接打开的CSV表格。 - Pandas(推荐安装):数据分析领域的通用工具库,使用
pandas.DataFrame(data).to_excel('result.xlsx')可以一步将字典列表导出为标准Excel文件,非常省心。
在终端中一键安装上述全部核心基础库的命令如下:
# 一键安装爬虫基础库套件
pip install requests beautifulsoup4 lxml pandas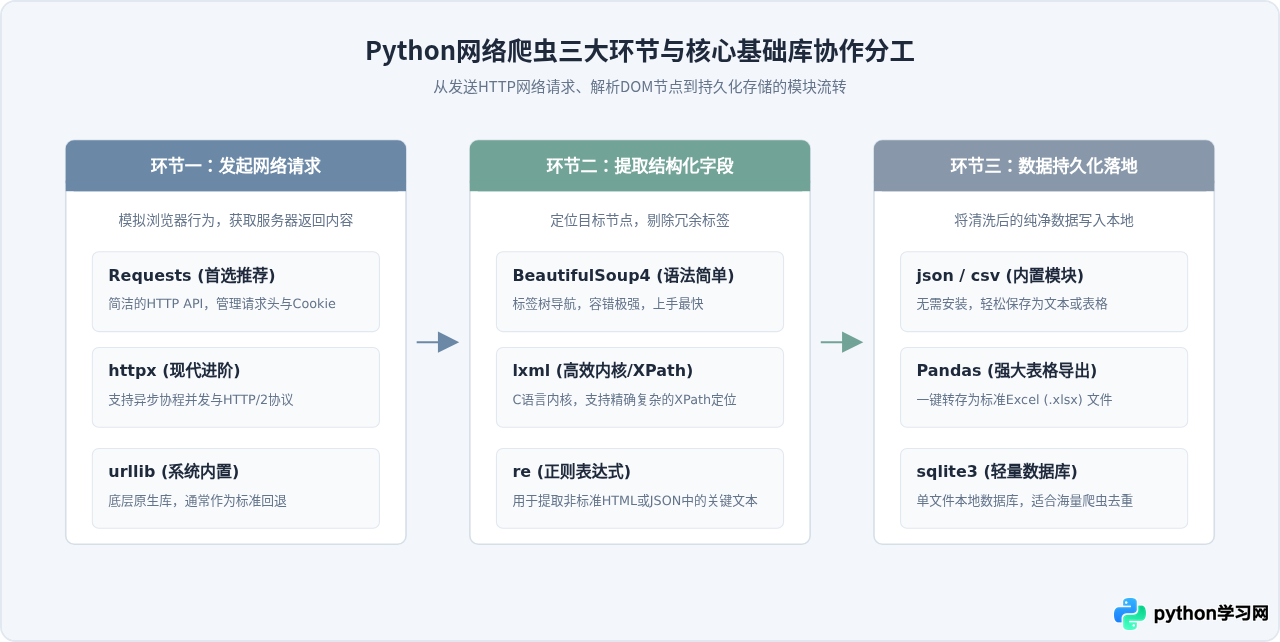
4. 最小实战验证:10行代码体验完整爬虫
完成环境与基础库安装后,可以编写一段极简的爬虫脚本验证各个组件的协同运作:
import requests
from bs4 import BeautifulSoup

# 1. 目标地址并设定请求头伪装成浏览器
url = "https://example.com"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36"
}

# 2. 发送网络请求获取响应
response = requests.get(url, headers=headers, timeout=10)
response.encoding = response.apparent_encoding

# 3. 使用BeautifulSoup解析网页内容
soup = BeautifulSoup(response.text, "lxml")
page_title = soup.find("h1").get_text(strip=True)

# 4. 打印提取出的目标字段
print(f"提取结果: {page_title}")
如果控制台能正常输出页面标题文字,说明你的Python解释器、Requests库以及lxml解析引擎均已处于可用状态。
四、不能忽视的外部武器:浏览器开发者工具(F12)
在讨论爬虫“需要装什么软件”时,许多新手误以为只需在电脑上装Python包。事实上,爬虫工程师每天使用频率最高的工具其实是现代浏览器自带的开发者工具(DevTools)(如Google Chrome、Microsoft Edge或Firefox,无需额外安装,按下键盘上的 F12 或快捷键 Ctrl+Shift+I / Cmd+Option+I 即可唤出)。
浏览器开发者工具在爬虫中的关键作用包括:
- Elements(元素面板):用于直观查看网页的HTML DOM结构,通过右键点击目标文字选择“检查”,可以直接获取该元素的CSS选择器或XPath路径。
- Network(网络面板):抓包的核心区域。在网页刷新后,所有网络请求都会在这里显示。通过筛选“Fetch/XHR”或“Doc”,可以找到目标数据究竟是通过后端直接渲染的HTML页面返回的,还是通过前端异步接口(API)以JSON格式拉取的。如果直接抓取JSON接口,往往能省去复杂的网页标签解析工作。
- Headers(标头面板):查看请求时需要的Cookies、User-Agent以及Referer等反爬校验字段,直接复制到Python代码中的
headers字典中即可。
五、新手避坑指南与常见问题
很多新手在运行代码后发现
response.text 里面找不到网页上看到的文字,便以为是Requests库或代码写错了。实际上很多现代网页采用前端框架(如Vue/React)异步渲染。遇到这种情况,先在浏览器F12网络面板中查看是否有异步API返回JSON数据;对于深层混淆或必须执行JS渲染的复杂页面,后续可按需学习 Selenium 或 Playwright 等自动化无头浏览器工具,但入门阶段切勿一上来就依赖浏览器驱动,因为无头浏览器运行沉重且速度较慢。
Requests库在默认情况下发送的User-Agent标识是
python-requests/2.x.x。绝大多数商业网站均会拦截携带该标识的请求直接返回403 Forbidden状态码。养成在每次发起网络请求时显式附带常规浏览器User-Agent的习惯,可以避开80%以上的初级反爬拦截。
六、总结
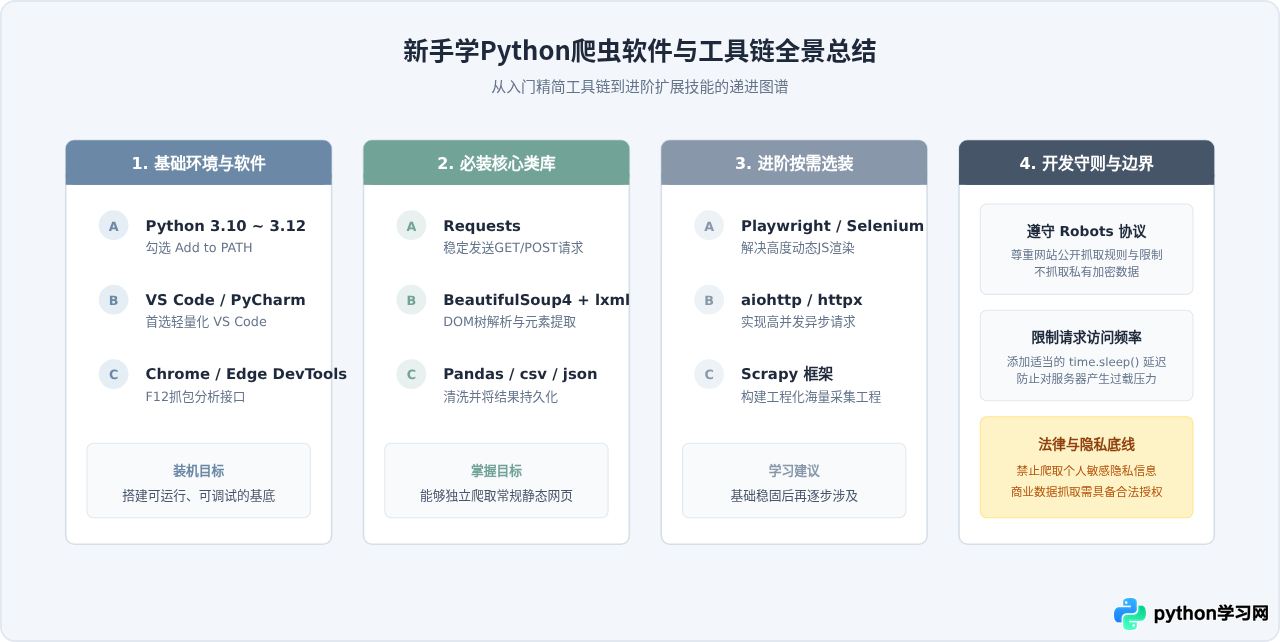
新手学Python爬虫的软件清单并不复杂,切忌在初学阶段就下载并堆砌各种庞大复杂的软件。总结而言,只需做好以下三件事:
- 安装官方Python 3,确保勾选了
Add to PATH,并设置好国内镜像源; - 安装VS Code(搭配Python插件)或PyCharm社区版作为日常代码编写与调试工具;
- 通过pip安装Requests、BeautifulSoup4、lxml和Pandas,并熟练配合浏览器自带的F12网络面板进行接口分析。
带着这套轻量而完整的工具组合,从简单的静态网页和公开接口入手练习,就能平稳渡过爬虫入门期,为后续处理复杂的反爬与高并发场景打下扎实的基础。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















