


AI数字人怎么制作:零基础在线生成全流程

在短视频和直播爆发的当下,真人出镜面临着时间成本高、状态不稳定以及隐私顾虑等多重压力。许多内容创作者渴望拥有一位“永不疲倦”的代言人,但传统3D建模或动作捕捉技术的高昂门槛,往往让非技术人员望而却步。
如今,基于深度学习的AI数字人技术已将这一过程极大简化。你不再需要理解复杂的骨骼绑定或渲染参数,只需通过浏览器访问在线平台,即可完成从形象定制到视频生成的全过程。对于零基础用户而言,核心不在于掌握技术原理,而在于学会如何向AI下达清晰的指令,并理解其能力边界。
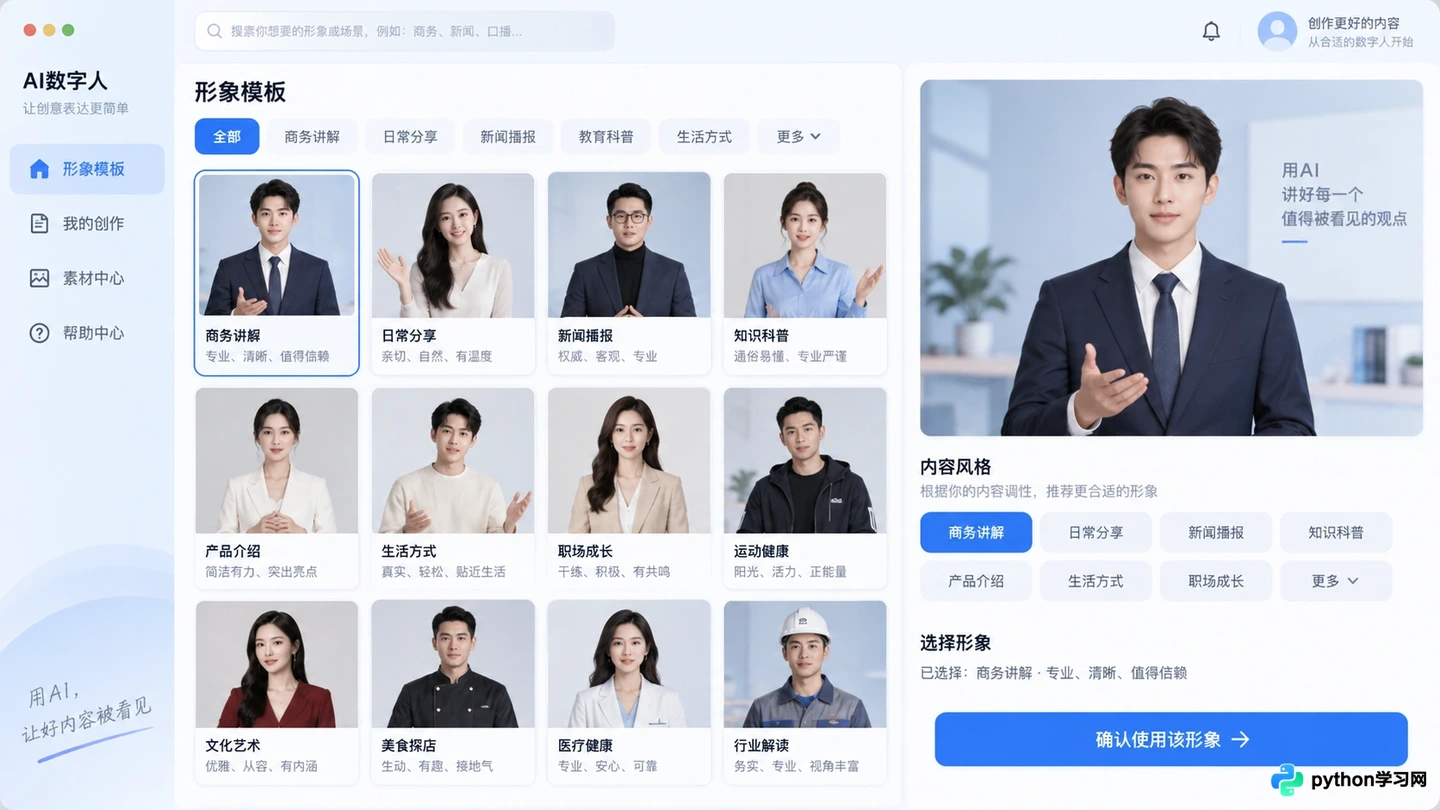
在线平台提供丰富的数字人模板库,用户可根据内容调性快速筛选。
形象定调:从模板库中匹配人设
制作AI数字人的第一步并非“捏脸”,而是“选人”。大多数在线生成平台提供的是预训练好的高质量数字人模型,而非完全自由的3D编辑器。这意味着,你的首要任务是在庞大的模板库中,找到与内容调性最契合的形象。
进入平台后,通常会看到分类明确的形象列表,如商务正装、休闲生活、新闻播报或特定职业角色。选择时不要仅看外貌吸引力,更要关注其气质是否与脚本内容冲突。例如,讲解严肃金融知识时,穿着过于随意的虚拟形象会削弱可信度;而推广年轻化产品时,刻板西装形象则显得疏离。
部分高级平台允许对选定形象进行微调,如更换发型、肤色或背景板。这种微调并非为了创造全新角色,而是为了消除“通用感”,让数字人更贴合品牌视觉规范。在这一阶段,确定一个稳定的主形象比频繁更换更重要,这有助于在观众心中建立长期的认知连接。
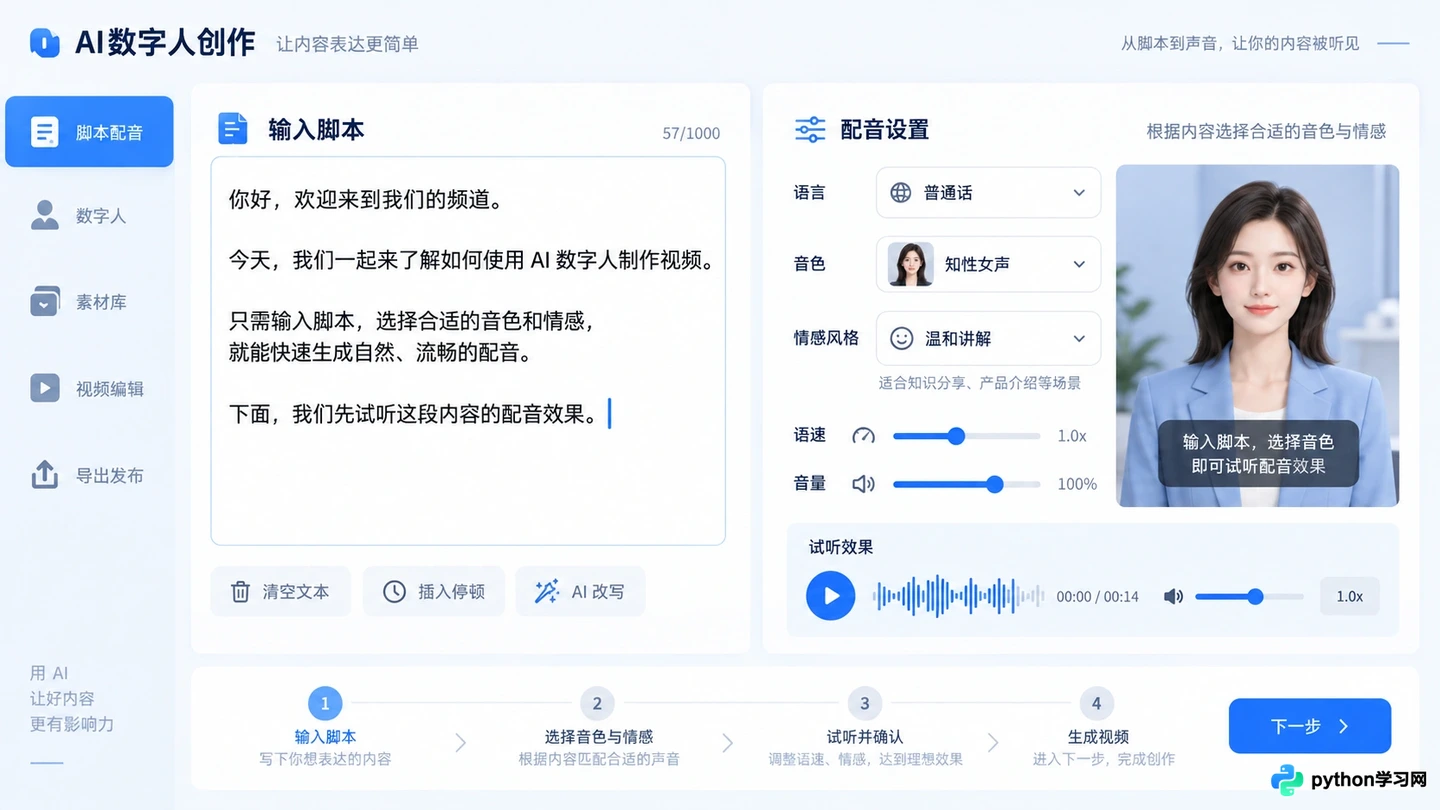
通过文本框输入脚本,并选择合适的AI配音音色和情感参数。
文本驱动:让声音与表情自然流动
选定形象后,核心工作转为内容输入。AI数字人的本质是“文本到视频”的转换,因此文案的质量直接决定最终效果。在在线编辑器的文本框中输入脚本时,需注意断句和标点的使用,因为它们直接影响AI的呼吸节奏和语调停顿。
现代AI引擎支持多种语言和音色选择。你需要根据目标受众挑选合适的配音演员(TTS)。除了性别和年龄,还要关注情感色彩:是激昂促销、温和科普还是冷静叙述。多数平台提供试听功能,建议先选取一小段文案测试不同音色的表现力。
更进阶的操作是利用“情感标签”或“语速调节”。如果某段话需要强调,可以在文本中加入停顿标记或调整局部语速。虽然目前的AI还无法完全媲美人类演员的微表情控制,但通过合理的文本排版,可以显著减少机械感,使口型与语音的配合更加流畅自然。
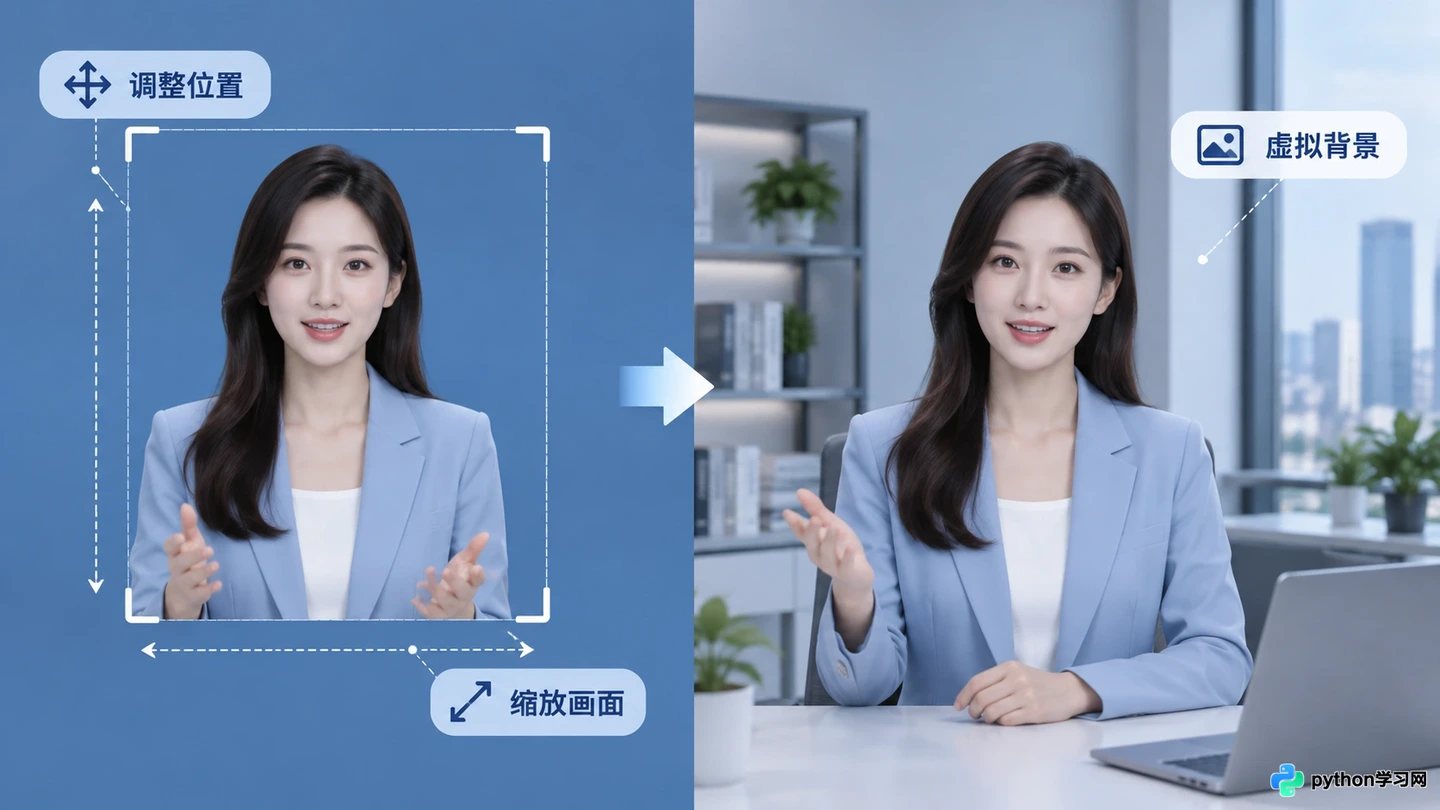
调整数字人在画面中的位置,并搭配协调的虚拟背景。
场景合成:视觉元素的协同编排
数字人不是孤立存在的,它需要置身于具体的场景中才能产生说服力。在线工具通常提供简单的拖拽式界面,让你将数字人放置在画面左侧、右侧或中央,并调整其大小比例。
背景的选择至关重要。你可以使用纯色背景以便后期抠像,也可以直接使用平台提供的虚拟演播室、办公室或户外场景。关键在于前景人物与背景的光影协调。如果数字人的光源方向与背景图片明显冲突,会产生强烈的“贴图感”,破坏沉浸体验。部分智能平台能自动调整数字人的光照以匹配背景,这是提升真实感的关键功能。
此外,别忘了添加辅助视觉元素,如字幕、图标或产品展示图。这些元素应与数字人的讲述节奏同步出现。例如,当数字人提到某个数据时,屏幕上相应图表适时弹出,能有效引导观众注意力,弥补数字人肢体语言相对单一的不足。
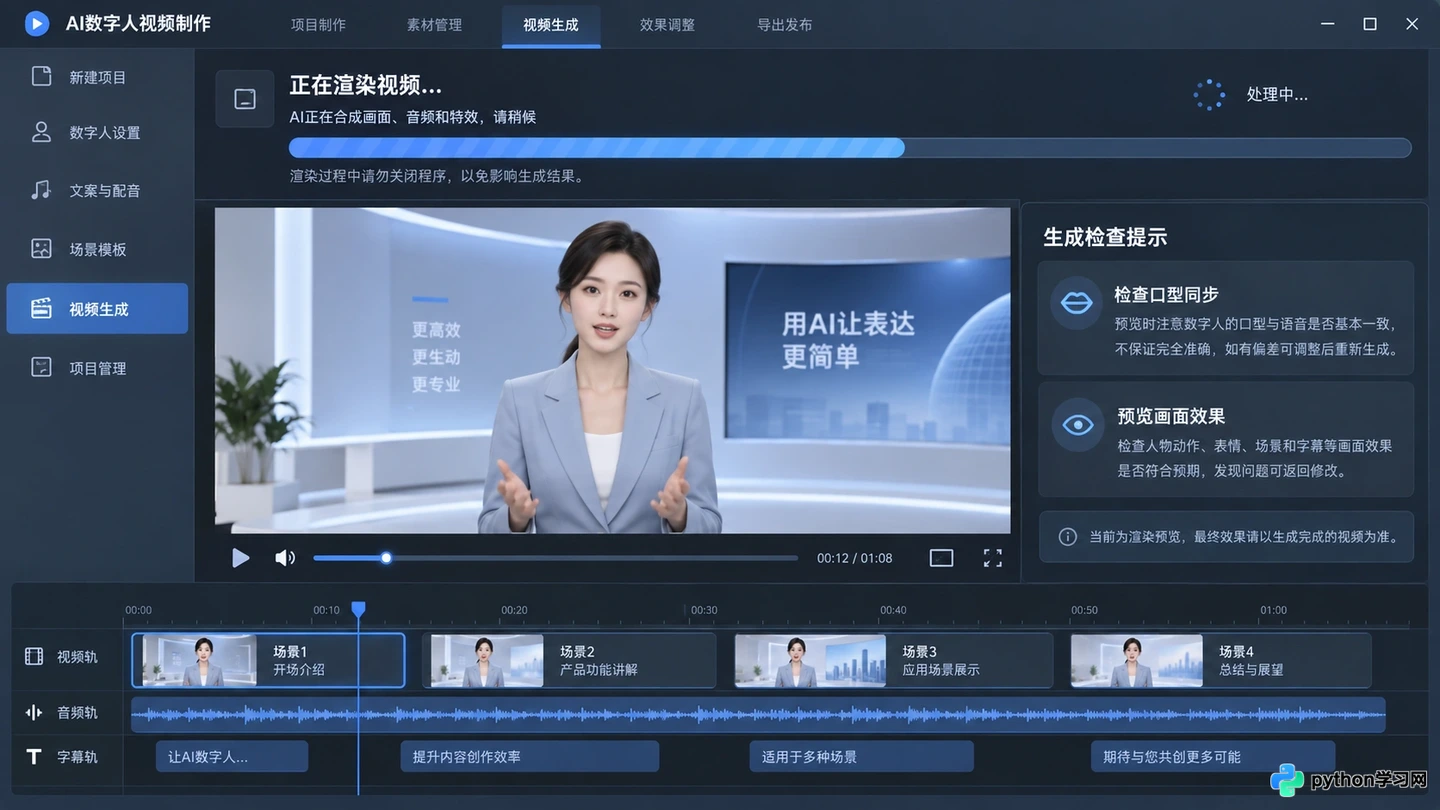
系统正在渲染视频,用户可预览口型同步和整体效果。
渲染与迭代:接受不完美并快速优化
完成所有设置后,点击生成按钮,服务器将开始渲染视频。这个过程可能需要几分钟到几十分钟不等,取决于视频长度和平台算力。等待期间,你可以预览低分辨率样片,检查口型同步是否准确、有无明显的穿模或表情僵硬现象。
初次生成的视频很难达到完美。常见问题包括生僻字发音错误、长句换气不自然或手势与语境不符。面对这些问题,不要试图一次性解决所有细节,而应采用“小步快跑”的迭代策略。先截取问题片段,修改文本标注或更换音色,重新生成局部视频,再通过剪辑软件拼接。
目前的技术水平下,AI数字人在处理极度复杂的情感爆发或即兴互动时仍显吃力。因此,它最适合标准化、信息密度高且逻辑清晰的播报类内容。接受其在创造性表演上的局限,发挥其在效率和一致性上的优势,才是正确使用AI数字人的态度。
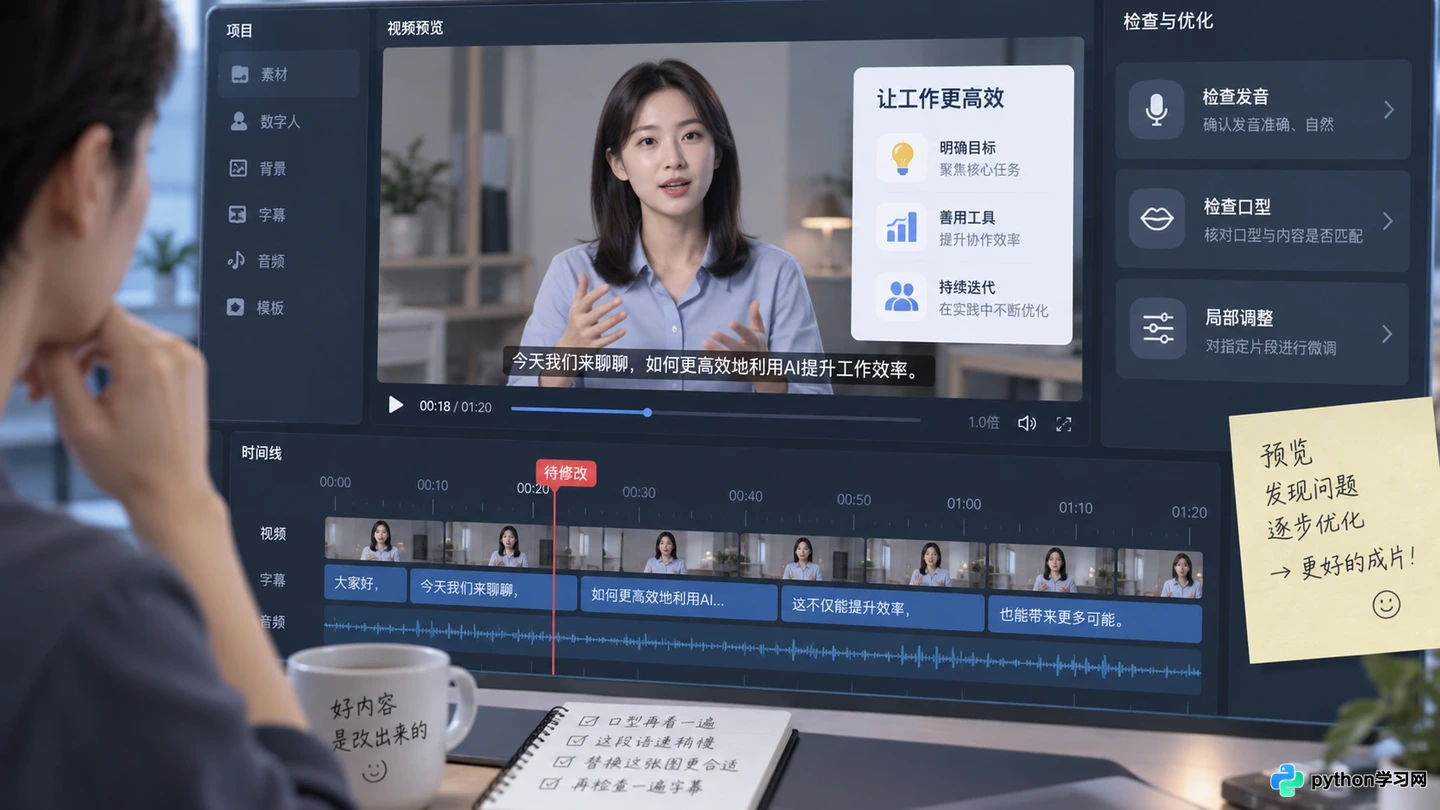
成品视频展示,数字人表情自然,配合字幕和图形元素。
回到最初的取舍,制作AI数字人并非为了完全取代真人,而是为了解放人力去从事更具创造性的工作。对于需要高频更新、标准化输出的内容场景,在线生成的AI数字人提供了极具性价比的解决方案。只要掌握好形象匹配、文本打磨和场景协调这三个关键环节,零基础用户也能轻松打造出专业级的数字播报内容。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















